
 语音小管家
近日,清华大学自然语言处理与社会人文计算实验室与面壁智能、OpenBMB 开源社区正式发布ForgeTrain——全球首个完全由 AI 编写、零人类代码介入的生产级大模型训练框架。
它不是一个实验原型,而是一套可以直接投入生产、创造价值的“AI 引擎”。在英伟达 H100 GPU 上,ForgeTrain 的训练速度超越了英伟达自研、业界主流的 Megatron 框架10%。这意味着在同等任务下,直接节省 10% 的算力成本。在华为昇腾 910B/910C 上,ForgeTrain 已完整跑通预训练流程,训练速度超越了华为自研 MindSpeed 框架 10%,证明了其强大的跨硬件平台适配能力。从零研发一套训练框架的时间仅需 1-3 天,中间无需人类参与,研发效率相比传统方法提升近 100 倍。
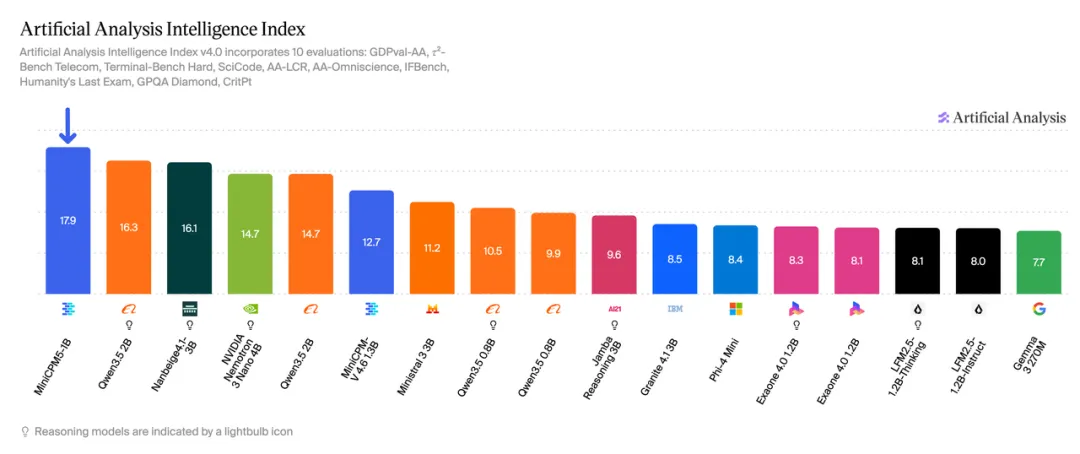
这标志着,“AI 写的框架 → 在国产芯片上运行 → 训出领先的 AI 模型”这一完整闭环被成功打通。这一系列成果的背后,是我们提出并实践的全新软件编程范式Forge Engineering。
为什么必须“AI 制造 AI”?
大模型能力的每一次跃迁,背后都是天文数字级的资源投入。十万卡集群的开支已逼近顶级科技公司的年现金流量级,北美电网的新增容量被头部实验室大面积预订,高质量文本语料日益稀缺。如果大模型的进步只能靠砸更多钱、用更多卡,这条路注定越走越窄。这是一个关乎大模型未来生死存亡的底层问题。
一个简化的公式可以描述大模型能力的增长:大模型年度能力增长 = Scaling 每代涨幅 × 研发预算 / 每代研发成本
Scaling 涨幅受理论约束,研发预算受资源约束,真正能被持续撬动的杠杆只有一个:压低每一代模型的研发成本。
这正是“AI 制造 AI”的出发点。全球顶级实验室已将此列为战略核心——Anthropic AI 创始人 Dario Amodei 称其为 AGI 时间表最强的加速器,OpenAI 和 DeepMind 也在全力探索。然而,在“让 AI 编写大模型底层基础设施”这个最关键的节点上,此前的探索都留下了空白。英伟达的 VibeTensor、Anthropic 的 C 编译器、OpenAI 的 Harness Engineering,三份来自北美头部科技厂商的成果各有贡献,但没有一个团队,在“AI 编写训练框架”这个粒度上,同时做到生产级可用、并且性能卓越。
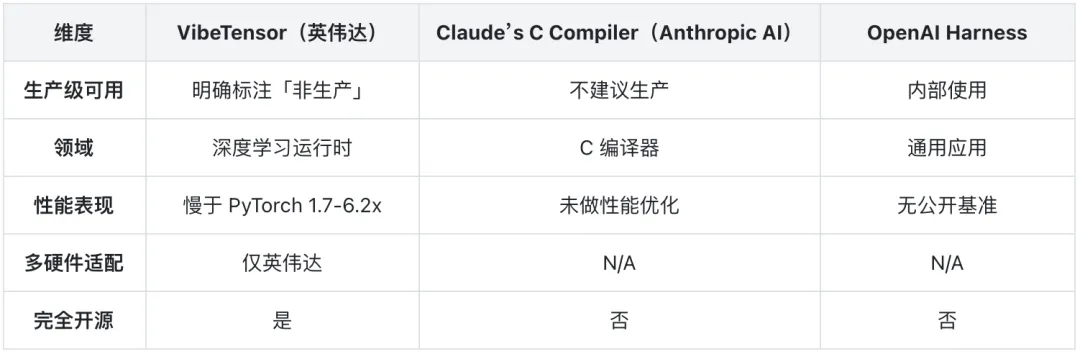
ForgeTrain 正是在这个关键空白处实现了决定性的突破。AI 不仅写出了一个能用的训练框架,而且这个框架比人类专家实现得更快、性能更强。
Forge Engineering:从“编程”到“锻造”
大模型训练框架不是一般的软件。它需要管理数百乃至数千张 GPU 的协同,在分布式环境下保证计算结果的精确一致,还要把每一块算力榨到接近理论上限。写出来不难,写出来能用、还能更快,是完全不同量级的挑战。Forge Engineering 的方法论分三个阶段,每一步都有明确的验收标准:
第一步:立标准(Harnessing)
从 Megatron 中采集关键运行数据,构建一套自动化评测 Harness,把什么叫“跑对了”、什么叫“跑快了”变成机器可以自动判断的标准。后续所有的 AI 生成与迭代,都有客观锚点,而不是靠人眼 review。
第二步:咬对齐(Bit-for-Bit Replication)
AI 在 Harness 约束下,构建一个与 Megatron 逐比特一致的版本。逐比特一致不是大约对齐,不是行为相似,而是在相同输入下产出完全相同的数值结果。这一步确保框架的正确性基线:AI 具备精确理解和复现复杂系统的能力。
第三步:解约束反超 (Surpassing)
正确性验证完成后,解除二进制一致的限制,切换到一组性能导向的新 Harness,让 AI 在更大的搜索空间里自主迭代。最终结果是速度超越英伟达 Megatron 10%,节省 10% 的算力成本。
这条“先逐 bit 复现,再放宽约束实现反超”的三阶段路径,在此前所有公开方法论中是空白。VibeTensor 直接追求与 PyTorch 行为对齐,但性能有所下降;Anthropic 的 C 编译器用 GCC 作差分测试,但仅限正确性验证而非性能反超;OpenAI 的 Harness 没有参照实现可供对齐。ForgeTrain 是第一个把这三步显式提出、并全部兑现的团队。
这个三阶段路径指向了一种全新的软件工程范式,我们将其命名为:Forge Engineering(锻造工程)。要理解它的意义,先看大模型时代编程范式的演进:
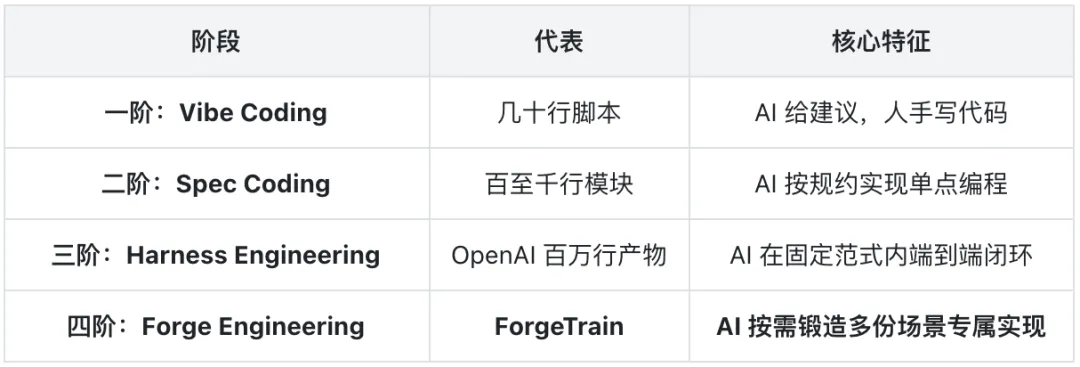
OpenAI 提出的 Harness Engineering 是重要里程碑,它证明 AI 可以端到端生成大型通用系统。但代码仍被当作一份需要长期维护的资产:有主分支、有发布节奏、有不断累积的技术债。
Forge Engineering 跨过了最后一步。它把代码从“资产”解绑成按需锻造的深度定制品——同一份 Harness,可以在 H100 上锻造一份实现,在昇腾 910C 上锻造出另一份完全不同的实现。两份代码都是为各自硬件深度优化的,没有为了通用性而带来的性能损耗。
过去,大型软件工程有一个无解的取舍:要通用就要抽象,抽象就有损耗;要效率就要定制,定制就失去可移植性。Forge Engineering 让这个取舍消失了。通用性,留在 Harness 的规约里;高性能,留在每一次的锻造里。
重塑国产算力在 AGI 时代的生态位
黄仁勋反复强调“英伟达本质上是一家软件公司”。真正让客户离不开英伟达的,不是芯片,而是十几年、上百万开发者堆砌出的 CUDA 生态。这是英伟达最深的护城河。国产芯片硬件进步迅速,但软件生态始终是最大的痛点。核心挑战是:让每种算法在每款芯片上高效运行,组合空间是天文数字,靠人力永远追不完。
Forge Engineering 改变了这道题的解法:
当写代码的边际成本趋近于零,我们就不必再维护一份试图兼容所有芯片的“万能框架”。而是维护一套规约与评测标准(Harness),为每款芯片、每种场景现场锻造专属的高性能实现。芯片换代或模型迭代,就再锻造一份新的。
这意味着,过去国产芯片每出一代、软件生态就要用人力重新追一轮的恶性循环,有可能被彻底打破。我们不再需要花十年堆另一个 CUDA,而是让 AI 为每款芯片即时锻造专属软件栈。芯片出多快,软件就能跟多快。护城河的逻辑变了:不再比谁堆的代码多,而是比谁的“锻造炉”更快更准。
算力可以被封锁,工程效率却封锁不了。ForgeTrain 是这条路上的第一个坚实验证。我们将“AI 制造 AI”的进化路径划分为 L1 到 L5 五个级别,与 OpenAI 对 AGI 的 L1-L5 定级形成呼应,其中ForgeTrain 对应 L3(AI 端到端闭环产出下一代大模型所需的基础设施):
开源可复现
一句话可以描述“AI 制造 AI”的战略意义:一旦“AI 研究 AI 的速率”超过“人类研究 AI 的速率”,大模型的研发速度就从人力规模的函数变成算力规模的函数,AGI 实现的时间表将被重写。
ForgeTrain 预训练的 MiniCPM5-1B 性能达到全球同级模型最优,体现了“AI 制造 AI”的可行性。目前,ForgeTrain 框架代码已开源,完整工具链即将发布,欢迎大家关注。
我们开源的不只是代码,更是方法论。从 MiniCPM 系列的端侧高效模型,到今天的 ForgeTrain 和 Forge Engineering,我们探索的核心问题始终没变:如何让每一份算力产生更大的价值?
答案越来越清晰——不是比谁的资源多,而是比谁把资源用得更聪明。当 AI 学会锻造自己的工具,效率的天花板,再次被打破。
ForgeTrain 开源链接:https://github.com/OpenBMB/ForgeTrain
