
 语音小管家
近年来,以Suno、Mureka、YuE、ACE-Step 等为代表的音乐生成模型迅速演进,其输入条件已经从单一的文本描述,扩展为文本、歌词与参考音频任意组合的多模态指令。然而,用来判断「单条生成结果到底好不好」的评测手段,却相对滞后:传统的分布级指标(如Fréchet Audio Distance)只能在语料层面给出统计判断,无法为后训练与样本筛选提供样本级(sample-level)的信号;而新近的样本级方法又往往各自为政——有的只评音质,有的只看文本对齐,且大多对输入形态作了较强假设,难以应对「文本+歌词+参考音频」交织在一起的真实创作指令。
这项由伦敦玛丽女王大学、北京大学、慕尼黑工业大学等学校的研究者联合完成的工作认为:要在AI 音乐创作(AIGC)流程中充当「人类偏好的代理(proxy)」,奖励模型需要像人类评审一样,同时看到完整的多模态指令、听到生成的音频,并在「音乐性」与「指令对齐」两个维度上给出与人一致的判断。围绕这一目标,作者构建了大规模偏好数据、统一评测基准与一个参数高效的奖励模型,并指出一个常被忽视的问题:直接使用现成的多模态大模型(off-the-shelf MLLM)作评审并非最优;而能够「指令—音频一体化」打分的奖励模型,目前整体仍落后于生成模型的发展。 该工作已被 ICML 2026 接收。
论文标题:CMI-RewardBench: Evaluating Music Reward Models with Compositional Multimodal Instruction
论文作者:Yinghao Ma*, Haiwen Xia*, Hewei Gao, Weixiong Chen, Yuxin Ye, Yuchen Yang, Sungkyun Chang, Mingshuo Ding, Yizhi Li, Ruibin Yuan, Simon Dixon, Emmanouil Benetos
发表会议:International Conference on Machine Learning (ICML) 2026
项目首页:https://github.com/Haiwen-Xia/CMI-RewardBench(模型权重和数据均已开源)
研究领域:音乐生成评测· 奖励建模(Reward Modeling)· 多模态对齐
⏩一、问题的重新定义:奖励模型应当如何「像人一样听」
音乐评测的核心,是在灵活的多模态条件下,同时评估「音乐性(musicality)」与「指令遵循 / 对齐(alignment)」。其中的核心概念是「组合式多模态指令(Compositional Multimodal Instruction, CMI)」——一段生成音频可能同时受到文本描述、歌词与参考音频的约束,奖励模型需要在这些可选且变化的输入条件下,都给出与人类判断一致的打分或排序。
图1 给出了理想的工作范式:人类评审在拿到提示(文本 / 歌词 / 参考音频)后,综合音乐性与多个层面的对齐来评价一段波形;奖励模型若要作为人类的可靠代理,就应接收同样的多模态输入并复现同样的多维判断。但现实中的奖励模型大多是「碎片化」的——要么仅凭音频本身给音质打分,要么只能捕捉单一模态对(如文本—音频)的对齐,因而难以在灵活的 CMI 输入下稳定地代理人类判断。这也意味着,「对齐」不再只是与文本描述的一致性,而是与整套提示(文本+歌词+参考音频)的综合一致性。
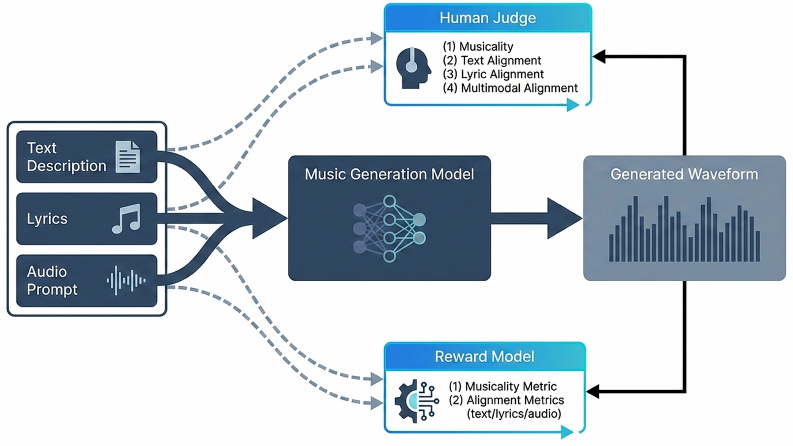
图1.在组合式多模态指令(CMI)下,奖励模型应充当人类评测的代理:人类评审依据文本、歌词与(或)参考音频,从音乐性与多层次对齐两个角度评价生成波形;理想的奖励模型应接收相同的多模态条件,并输出音乐性与对齐两类指标。当前奖励模型多为碎片化设计,难以胜任这一任务。
⏩二、数据的缺口:CMI-Pref 与 CMI-Pref-Pseudo
制约这类评测模型的根本瓶颈在于数据。音乐推荐领域虽有海量交互数据(如Spotify Million Playlist),但它刻画的是「用户—曲目」的全局偏好,而非针对复杂多模态指令、对生成样本进行细粒度比较排序的对齐信号。已有的偏好数据与评测平台(PAM、MusicEval、SongEval、AIME、MusicPref、Music Arena 等)各有贡献,却大多局限于「文本到音乐」,对歌词、尤其是音频到音频(audio-to-audio)条件的覆盖相对较少。
为此,作者构建了两套配套数据。CMI-Pref-Pseudo是一个约 11 万对的伪标注偏好数据集,由 Qwen3-Omni 担任 LLM 评审,对来自 23 个来源(12 个开源模型与 11 个商业 API)的生成音频两两比较,其中约 35.6% 的样本带有参考音频条件;CMI-Pref则是高质量的人工标注语料,含 4,027 对偏好样本,每对都在音乐性与对齐两个维度上分别给出偏好、1–5 的置信度与一段理由;其中保留了平衡划分的 500 对测试集,覆盖「纯文本」「文本+歌词」「文本+音频」「文本+歌词+音频」四种条件。
如图2 所示,二者是其中唯一同时支持文本、歌词与音频三类条件的偏好数据集,而音频条件为现有公开数据集所缺失。
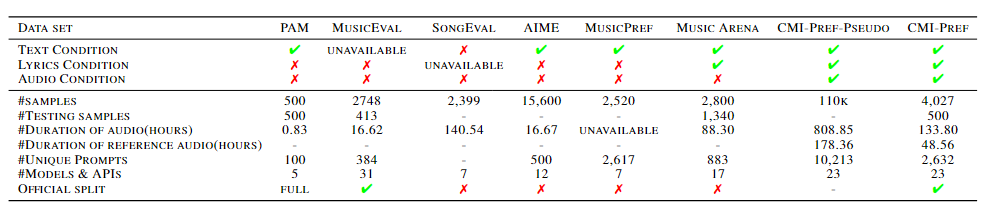
图2.CMI-Pref / CMI-Pref-Pseudo 与既有数据集的模态覆盖与规模对比(节选)。在现有公开数据中,仅有 CMI-Pref 与 CMI-Pref-Pseudo 同时覆盖文本、歌词与参考音频三类条件。
⏩三、统一的奖励模型:CMI-RM
在数据之上,作者提出了CMI-RM(Compositional Music Instruction Reward Model)——一个在单一架构内处理文本、歌词与音频任意组合、并覆盖 CMI-RewardBench 全部评测设定的奖励模型。给定由文本、歌词、参考音频任意组合而成的提示,再加上一段待评估音频,CMI-RM 输出音乐性与对齐两个标量分数。
如图3 所示,模型采用双塔结构:一塔编码多模态提示,另一塔处理待评估音频。所有编码器均冻结,并由MuQ-MuLan 实例化——文本与歌词共用文本编码器,参考音频与待评估音频共用音频编码器,缺失的模态以零张量代替。提示侧的三路嵌入先由Prompt Transformer融合,再与待评估音频嵌入一起送入Joint Transformer建模提示与音频的交互,最后经时序池化与一个轻量 MLP 头映射为音乐性分数与对齐分数。
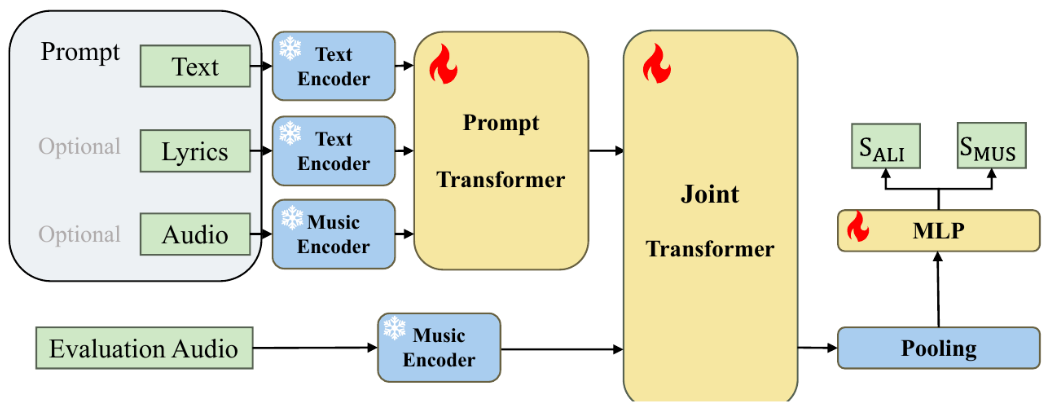
图3.CMI-RM 的模型结构。冻结的文本 / 音乐编码器分别编码文本、歌词、参考音频与待评估音频;可训练部分包括 Prompt Transformer、Joint Transformer 与 MLP 头,输出对齐分数与音乐性分数。
由于只有融合与打分模块需要训练,CMI-RM 的可训练参数量约为30M。训练分两阶段:先在CMI-Pref-Pseudo 上以 Bradley–Terry 偏好建模做预训练,再在 CMI-Pref 与 MusicEval 的人工标注上做微调,将成对偏好与标量评分统一到同一训练目标中。
⏩四、CMI-RewardBench:统一基准与评测结果
为把割裂的评测重新统一,作者提出了CMI-RewardBench,整合四类资源、覆盖从「绝对音乐性打分」到「组合式对齐」的五项任务,并按标量数据和比较数据各自选定了指标。
图4 汇总了音乐性维度的结果,可以看到两点。其一,前沿多模态大模型在细粒度音乐判断上整体偏弱。其二,CMI-RM 在多个基准上具有较好的泛化性。
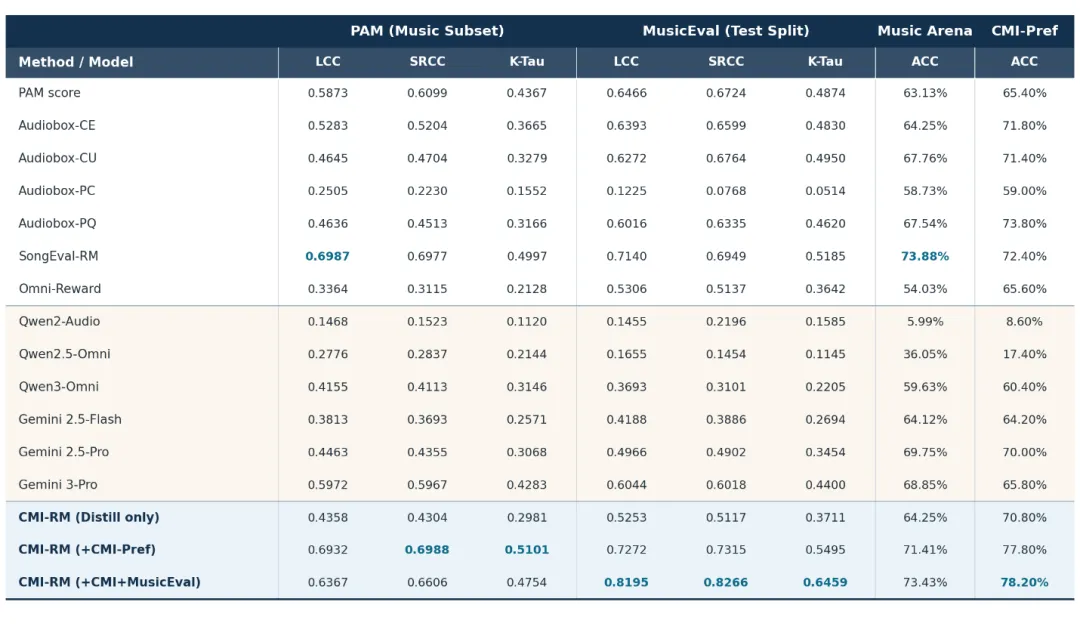
图4.CMI-RewardBench 上的音乐性评测结果(节选自论文 Table 2)。
图5 进一步给出组合式对齐的评测,这一点也是 CMI-RewardBench 与以往仅关注“文本—音乐一致性”的评测方案之间的重要区别。基于相似度的客观指标(如 CLAP、MuQ-MuLan)无法处理带音频条件的情形(表中以「—」表示),通用 MLLM 表现参差;而 CMI-RM 在含音频、以及最难的「文本+歌词+音频」设定上表现最好——后者达到 82.40%,对比 Gemini 3 Pro 的 66.8%。这与第一节的判断一致:能够「指令—音频一体化」地打分,才是应对多模态生成条件的关键。
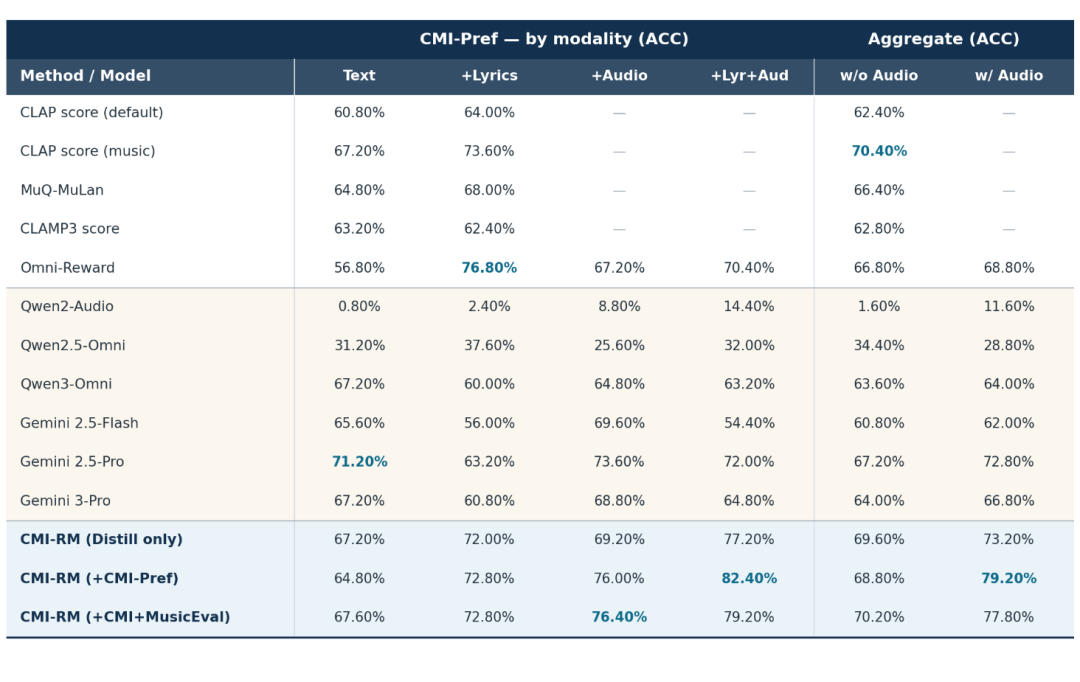
图5.CMI-Pref 上的组合式多模态对齐评测(节选自论文 Table 3,按模态拆分)。
⏩五、推理时扩展:把奖励模型用作best-of-N 过滤器
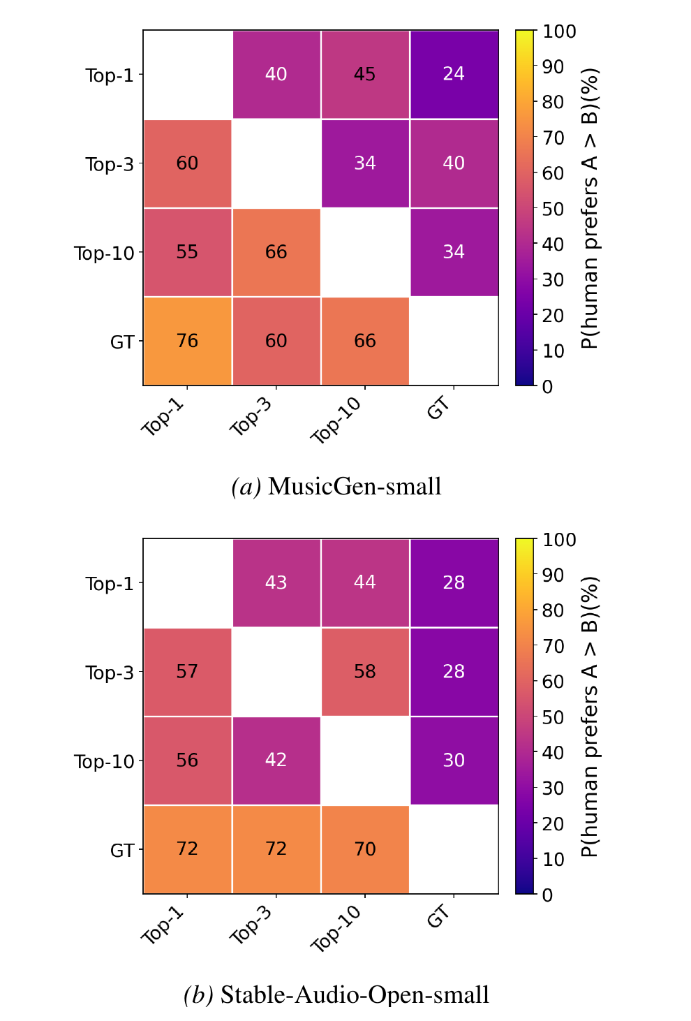
奖励模型的价值不止于评测,也在于指导生成。作者以MusicGen-small 与 Stable-Audio-Open-small 为骨干,在 MusicCaps 评测集的 2,183 条文本提示上各生成 10 条候选,用 CMI-RM 作「best-of-N」筛选器,以音乐性与对齐分数的均值为准则),并通过主观A/B 听测验证。
图6 给出了人类偏好的成对矩阵,可读出两点:其一,真实音频(GT)始终被偏好于所有重排序结果,说明重排序改善了生成质量,但尚未弥合与真实数据的差距;其二,Top-k 选择之间的偏好并不严格随 (N) 单调上升,增益会逐渐饱和。总体而言,best-of-N 重排序是一种简单有效的推理时扩展策略,但收益在中等 (N) 之后趋于平缓。
⏩六、结 语
这项工作重新校准了音乐评测的任务:当生成模型已能接受文本、歌词与参考音频的任意组合时,评测与奖励建模不宜再停留在「单模态、对单一属性打分」的旧范式。围绕「组合式多模态指令」,作者提供了三件可供社区复用的资源——大规模偏好数据(CMI-Pref-Pseudo 与 CMI-Pref)、统一评测基准(CMI-RewardBench)与参数高效的奖励模型(CMI-RM)。基准结果也表明:即便是 Gemini 3 Pro 这样的前沿多模态大模型,作为音乐评审仍难以稳定达到人类一致率;而能够「指令—音频一体化」打分的奖励模型整体上仍落后于生成能力,这正是值得继续投入的方向。
