
 语音小管家
上海交通大学 X-LANCE 实验室与小米联合发布的 Dasheng AudioGen,不再独立建模语音、音乐、音效生成任务,而是让 AI 像“声音导演”一样理解真实世界音频中多种声音的复杂关系,并端到端生成自然、协调的混合音频场景。
⏩音频生成新范式
当我们说起 AI 生成音频,很多人首先想到的是“文字转语音”(TTS):输入一段文字,AI 读出来。或者是“文字生成音乐”(TTM):输入“轻松的钢琴曲”,AI 写出一段旋律。还有一些模型可以实现“文字生成音效”(TTA),如雨声、脚步声、汽车声等音效。
但在真实的世界中,声音从来不是单独存在的。
想象一个电影片段:夜晚的城市下着雨,主持人的声音从电台里传来,远处有车流声,背景里还有一段低沉的爵士乐。真正让人沉浸其中的,不是某一种声音单独有多好,而是这些声音如何同时出现、彼此混合、保持空间感,并共同构成一个可信的“声音场景”。
这正是 Dasheng AudioGen 想解决的问题:让 AI 不再只是分别生成语音、音乐或音效,而是从一段文字描述出发,直接生成一个包含可懂语音、背景音乐、环境声和音效的完整音频场景。
⏩为什么这件事不简单?
过去的音频生成模型大多是“专才”。文字转语音模型擅长读稿,但生成的效果更像录音棚里的干净人声;音乐生成模型可以生成歌唱声与器乐,却无法生成说正常的说话声与声效;音效生成模型能生成风声、雨声、音乐声,但无法生成可懂的语音。
如果把这些模型拼接在一起使用,效果则不如人意:人声可能被音乐掩盖,声音质感和录音环境不匹配,音效像是后期硬贴上去的。更重要的是,因为各个音频是独立生成的,声音事件的时序关系和混合关系完全无法控制,难以获得真实的听感。
论文中构建的 Expert-Pipeline 基线就代表了这种“专家模型分别生成再混音”的思路,而实验显示,在复杂混合场景中,它几乎无法生成和谐的混合音频。
Dasheng AudioGen 的思路不同。它不是把多个模型的结果拼起来,而是让一个统一模型从一开始就理解:场景里有哪些声音、谁在前景、谁在背景、谁先发生、谁后发生、它们发生在什么环境里、音频层级之间如何互相影响。
⏩核心设计一:把音频描述拆成“声音分镜”
用户只需要给出一句自然语言描述,例如:“一位侦探在雨夜独白”,提示词优化器(Agentic Prompt Refiner)会把这个描述整理成多个视角:整体场景()是什么、说话人的风格(<|speech|>)是什么、具体台词(<|asr|>)是什么、有哪些音效(<|sfx|>)、音乐(<|music|>)是什么类型、录音环境(<|env|>)是什么。这个过程有点像电影拍摄前的分镜脚本,只不过这里分的不是画面镜头,而是声音层次。
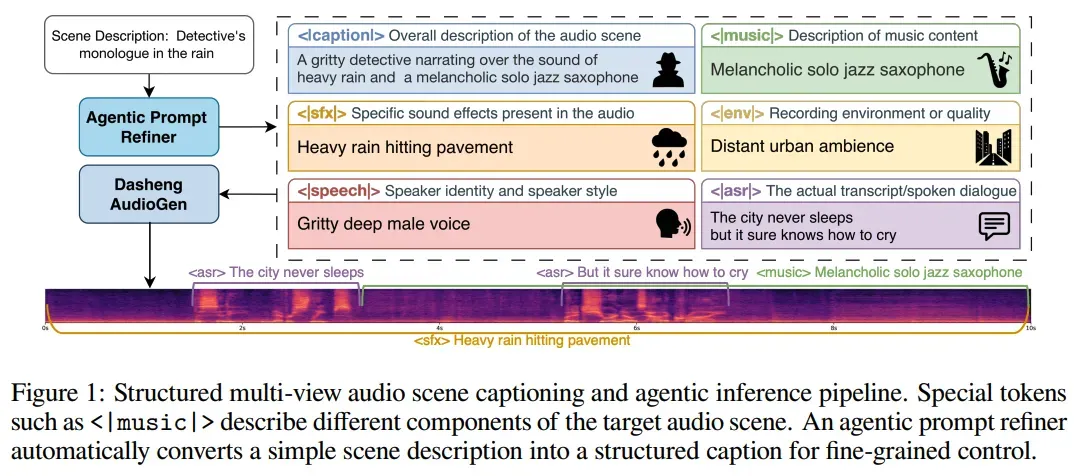
这种“结构化多视角描述”带来的好处是:AI 不再需要从一整句模糊描述里猜测所有细节,而是可以更清楚地知道每个声音层应该承担什么功能。同时,细粒度的分层文本条件可以提供更优质的监督信号,增强模型的表现。
消融实验证明,“结构化多视角描述”带来了生成音频质量上的稳定提升。特别是语音合成准确率,使用“结构化多视角描述”后,语音合成词错误率从52%降低到了10.77%。
⏩核心设计二:用统一的“声音语言”表达复杂音频
复杂音频的难点在于,不同声音往往会同时发生。一个十秒片段里,可能既有人声,又有背景音乐,还有环境声和突然出现的音效。传统方法常用 VAE 声学表示来作为生成目标,但这类表示更偏向“纯声学表示”:它主要学习如何重建声音本身,却不一定知道这些声音在语义上代表什么。这对文本到音频生成来说是一个关键问题。模型的输入是文字,而文字描述的是语义。如果目标空间缺少语义先验,模型就需要从文本语义直接跨到声学细节,中间没有一个更容易对齐的桥梁。对于简单声音,这个问题可能还不明显;但在复杂场景中,模型不仅要生成每一种声音,还要理解它们之间的关系:谁是前景,谁是背景,哪些声音应该清晰,哪些声音应该融入环境,这导致了纯声学表征在混合音频生成场景下表现不佳。
为了解决这一问题,Dasheng AudioGen 使用基于 DashengTokenizer 的高维度统一语义-声学表示。通俗地说,它不是只保存“波形长什么样”,而是尽量同时保留声音的语义信息和声学细节。这样,模型在从文字生成音频时,不是在一个完全陌生的低层声学空间里进行生成,而是在一个更容易对齐文字含义、也更能容纳多层声音的空间里工作。
这个设计带来的提升非常明显。论文中专门对比了 DashengTokenizer 统一表示和传统 VAE 声学表示的效果:在使用同样的大规模混合音频数据 ACAVCaps 或者标准任务数据集训练时,统一表示在几乎所有测试场景特别是混合混合音频类别中都带来了稳定、显著提升,在MECAT测试集上平均提升为20%。
论文还观察到了一个很能说明问题的现象:当训练数据从干净的语音数据集 LibriTTS 换成更复杂的混合音频数据 ACAVCaps 时,不同表示方式在语音可懂度上的变化截然不同。对于传统 VAE 声学表示来说,训练环境一旦从干净语音变成真实混合音频,语音识别错误率 WER 会明显退化:从6.4%上升到32.9%。这说明纯声学表示在复杂声音场景中更容易受到背景音乐、环境声和音效的干扰,很难稳定地把语音从多层声音中区分出来并和说话文本进行精细对齐。但 DashengTokenizer 的统一语义-声学表示表现出了相反趋势。它在 LibriTTS 上训练时 WER 为12.2%,而换到混合音频数据 ACAVCaps 训练后,WER 反而下降到10.77%。也就是说,当声音环境变得更复杂时,带有语义先验的表示并没有被混合场景拖垮,反而能够借助更丰富的训练场景和更大的数据量更好地区分和对齐语音内容。
⏩效果如何?在混合场景下接近真实录音
文在多个标准任务和混合音频任务上进行了评测,DashengAudiogen在单项任务上取得了媲美专家模型的表现,在混合音频场景生成上远远超过专家模型基线。
在标准生成任务测试集上,Dasheng AudioGen 展现出了很强的基础能力。在 AudioCaps、MusicCaps 和 LibriTTS 等经典测试集上,它依然保持了有竞争力的表现。尤其是在音乐生成任务 MusicCaps 上,Dasheng AudioGen 的 FAD 指标达到1.37,领先 MusicGen、AudioX等代表性模型;在语音自然度方面,其 UTMOSv2 得分达到3.12,接近专门的语音合成模型 Qwen3-TTS。这说明,统一模型并没有以牺牲单项能力为代价来换取“多功能”,而是在声音效果、音乐和语音等基础任务上都具备扎实的生成质量,为进一步生成复杂、真实、层次丰富的声音场景打下了基础。
在混合音频生成任务上,DashengAudiogen使用MECAT作为测试集。在最具挑战性的“语音 + 音乐 + 音效”混合场景中,Dasheng AudioGen 的音频分布指标 FAD 达到2.17,而专家混合基线表现为6.38。更关键的是,专家拼接方案在混合后语音识别错误率明显恶化,WER 达到62.14%;Dasheng AudioGen 则为28.98%,说明统一生成在保持场景感的同时,也更能维持人声可懂度。
在人类听评中,Dasheng AudioGen 在几乎所有混合类别上显著优于 Expert-Pipeline,并且在多个维度特别是“语音+音乐+声效”混合类别上与真实录音没有显著差异。而混合专家基线在“语音+音乐+声效”混合类别上与真实录音存在显著差异(p<0.05,效应量d_z=1.41)。
⏩这项工作意味着什么?
如果说图像生成让“用文字画图”变成了日常工具,那么统一音频场景生成可能会让“用文字做声音设计”变得更加自然。未来,在短视频、游戏、播客、有声书、教育内容、虚拟角色和无障碍内容制作中,创作者也许不再需要分别寻找配音、音乐和音效素材,而是直接描述一个声音场景,让 AI 生成一个整体协调的版本。
当然,Dasheng AudioGen 仍有改进空间。当前模型主要生成 10 秒音频,语音可懂度距离专门的 TTS 系统还有差距,也还不支持显式的音色克隆。但它展示了一个重要方向:音频生成不应只是单点能力的堆叠,而应该走向“场景级”的统一建模。
Dasheng AudioGen 让我们看到,下一代音频生成模型的关键不只是更像人声、更像音乐或更像音效,而是让这些声音在同一个场景中自然共存。它让 AI 更接近一位声音导演:理解情绪、安排层次、控制空间,并最终生成一段更接近真实世界的声音体验。
