
Interspeech2026 | 能够反馈编辑的沉浸式音频故事生成智能体:AuDirector

一个面向沉浸式音频故事创作的自反思闭环多智能体框架。 录取信息:Accepted to Interspeech 2026 论文题目:AuDirector: A Self-Reflective Closed-Loop Framework fo…
70 0 0

一个面向沉浸式音频故事创作的自反思闭环多智能体框架。 录取信息:Accepted to Interspeech 2026 论文题目:AuDirector: A Self-Reflective Closed-Loop Framework fo…

本文介绍AudioLens,一个全新的用于播放、分析、观察音频文件的 VSCode 插件。 AudioLens 多通道主界面 针对语音、声音事件检测、音频算法、信号处理、机器学习或音频数据集处理工作者,日常工作流的一个痛点问题是: 代码,数…

来源丨语音及语言信息处理国家工程研究中心 本期分享 语音及语言信息处理国家工程研究中心智能语音信息处理团队被 Interspeech 2026接收的14篇论文,论文方向涵盖语音编码、语音合成、语音识别、语音匿名化、声音事件检测等。 1、An…


想象一下你身处一个拥挤的派对:人声鼎沸,谈笑声不断,酒杯碰撞声此起彼伏。突然,几句话——或许是提到了你的名字——将你拉入了一场远方的对话。对话的两个人离你几米远,但当你把注意力集中到他们身上时,他们的话语似乎变得更加清晰易懂,甚至可能更加响…
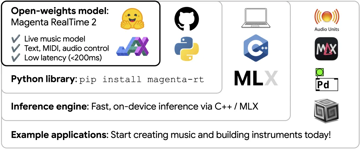
Google Magenta 团队发布并开源了Magenta RealTime 2(MRT2),一个 24 亿参数的实时音乐模型——你可以像演奏乐器一样使用它,并直接在 MacBook(Apple Silicon)本地运行。与"把提示词离线…

近年来,AI编辑技术取得了显著进展,推动生成模型从单一元素的编辑能力迈向更加灵活的交互式操作范式。在视觉领域,图像编辑模型(如 Nano-banana 2)已逐步走向成熟并进入实际生产流程,而以 Gemini-Omni 为代表的视频编辑模型…
来源丨21db声学人 蛤蜊、海螺这类带壳海洋软体动物和天敌的捕食互动,深刻影响着海岸生态系统,但这类过程大多藏在水下,很难直接观察。贝类能够稳固岸线、净化海水、维系区域生物多样性,是海岸生态平稳运转的关键。可如今受海洋酸化、碎壳型捕食生物活…

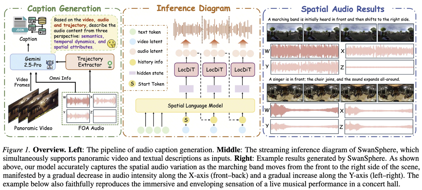
空间音频生成要求模型同时处理声源语义、时间同步和三维方位关系。现有方法通常在生成质量、推理延迟和空间条件建模之间存在取舍:非流式扩散模型依赖较长上下文,难以用于实时场景;通用视频编码器主要关注语义内容,对全景视频中的朝向、运动轨迹和声源位置…
