
 语音小管家
近年来,AI编辑技术取得了显著进展,推动生成模型从单一元素的编辑能力迈向更加灵活的交互式操作范式。在视觉领域,图像编辑模型(如 Nano-banana 2)已逐步走向成熟并进入实际生产流程,而以 Gemini-Omni 为代表的视频编辑模型也在持续拓展内容创作的边界。在这一“交互式智能”趋势的推动下,音频领域近期亦涌现出一些基于自然语言指令的音频编辑模型。这类方法允许用户通过开放式指令对语音、音乐及环境音进行灵活修改,正逐渐成为新一代智能音频生成与编辑系统的重要发展方向。然而,与模型能力的快速演进相比,当前音频编辑任务的评测体系仍明显滞后。为了有效评估这些不断发展的系统,需要构建新一代系统化、精细化的评测框架。
近日,上海交通大学、上海创智学院、南洋理工大学、腾讯混元团队、天津大学、数搭国际数据开源社区、北京大学、复旦大学等机构,正式发布MMAE(MassiveMultitaskAudioEditing Benchmark)——首个面向通用音频编辑的综合评测基准。
代码(GitHub):https://github.com/ddlBoJack/MMAE
数据集(Hugging Face):https://huggingface.co/datasets/BoJack/MMAE
Demo Video:https://youtu.be/6At5nTWhlXI
⏩MMAE 是什么?
MMAE 是一个面向通用音频编辑能力的系统性评测框架。与传统的音频生成任务不同,MMAE强调模型对输入音频的感知、对指令的理解和推理、以及精细修改或生成能力:在遵循自然语言指令的同时,仅对目标内容进行编辑,并保持其余部分不受影响。
这一任务的复杂性远超直观认知,下面来看几个例子:
"把歌词全部替换为'Hachimi',同时使用另一段音频的人声音色"——跨音频的多维音乐操作
先"将提到的第一个和第二个作者顺序对调",再"将第二个和第三个作者顺序对调"——连续两轮相关联的操作,需要理解语音内容并精确重排
"模拟第二个玻璃杯装满水的敲击效果,同时保持第一个和第三个玻璃杯的敲击声音不变"——涉及基于物理知识的声学属性推断,并需在多目标约束下进行多跳推理与选择性编辑
"把带口音的语句改成标准普通话发音"——涉及语音、音乐背景和环境声的混合场景
............
MMAE共包含2000道音频编辑任务,系统性覆盖模态、复杂度与操作类型三个维度,形成结构化、多层次的评测体系:
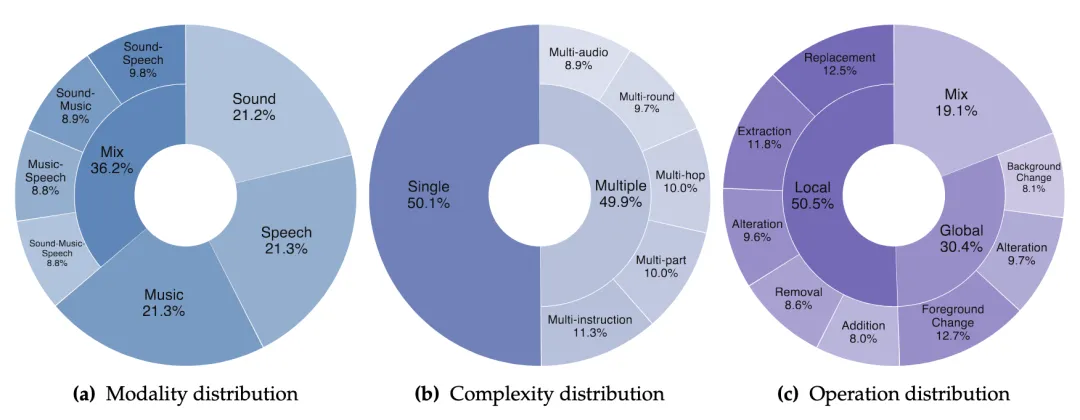
△ MMAE在三个维度上的数据分布
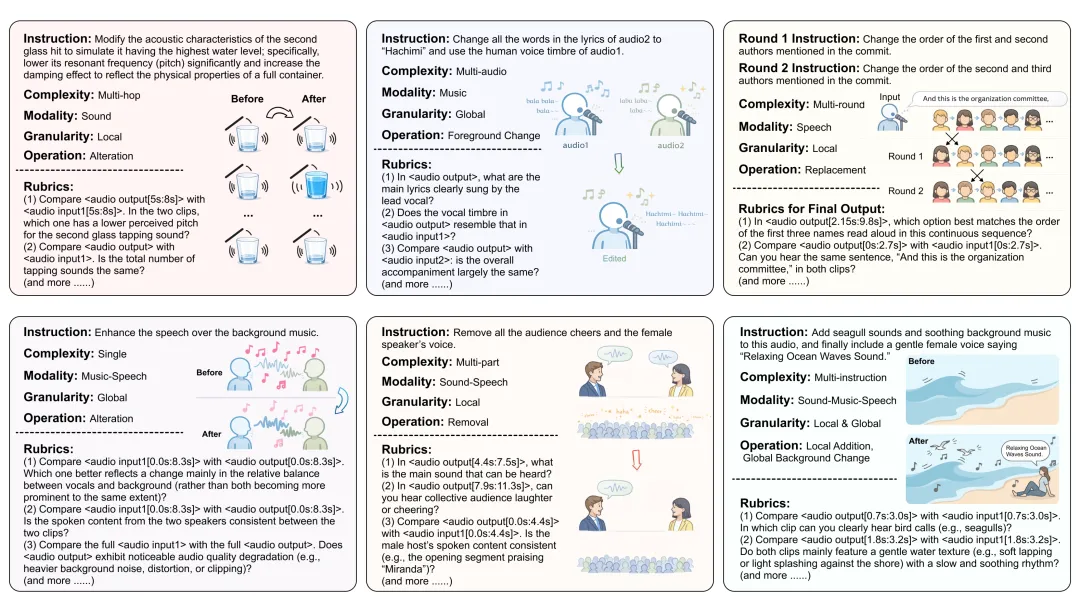
△ MMAE中覆盖不同模态、复杂度、操作类型的数据示例
值得强调的是,MMAE在数据构建过程中引入了严格的质量控制机制。所有测试样本均来源于真实场景音频(而非合成数据),由专业标注团队通过人机协作(Human-LLM Collaboration)完成初始标注,并经过多轮精细化修订与独立审核。每条数据均由不同于原标注者的审核人员进行复核,不符合标准的样本被反复修正或淘汰,确保最终数据的高质量、无歧义和可验证性。
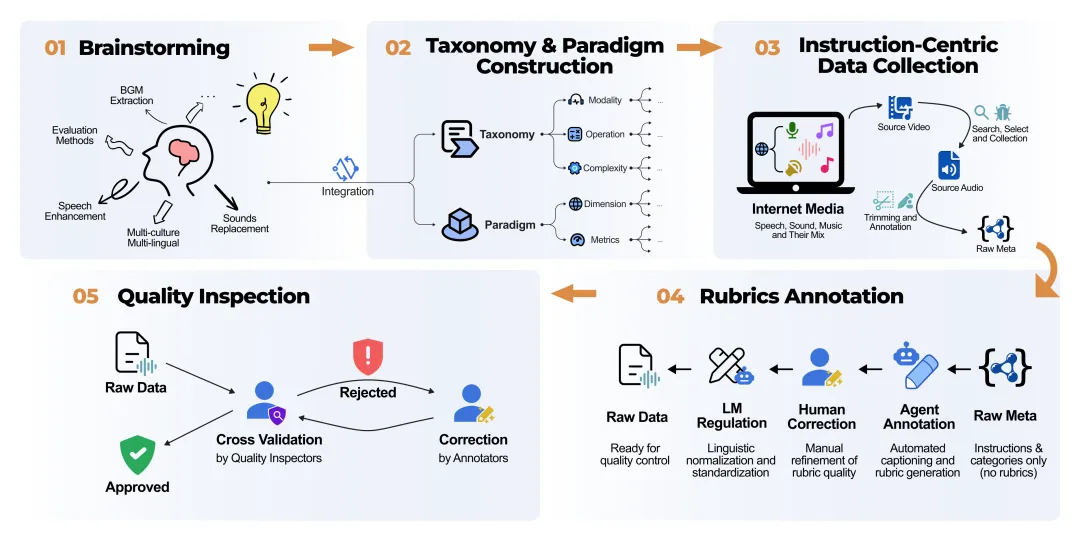
△ MMAE数据标注管线
在评测方法上,MMAE亦进行了关键创新。区别于传统的FAD、CLAP等粗粒度指标,MMAE为每条样本设计了平均约9条细粒度rubric(评分准则)。每条rubric均为一个原子化选择题,从“指令执行情况”(Instruction Following Rate, IFR)与“原始内容保持情况”(Consistency Rate, CR)两个维度分别评估,同时引入“完美编辑得分”(Exact Match Rate, EMR),即仅当所有rubric均通过时才计为成功。
这一设计使评测更加精确、可解释,并有效避免通过“简单不修改”来获取高分的情况,从而更真实地反映模型的编辑能力。
⏩测试结果:当前AI编辑音频能力几何?
研究团队评测了5个具有代表性的音频编辑模型,包括Step-Audio-EditX、Ming-UniAudio、MMEdit、Audio-Omni和SmartDJ。结果显示,即便是当前性能最优的模型,在整体编辑任务中也仅能正确完成不到一半的操作,而能够同时做到“修改准确且不破坏原有内容”的完美编辑案例则极为有限。
进一步分析表明,随着任务复杂度的提升(从单步操作到多轮、多跳、多指令),模型性能显著下降;在涉及多模态混合(如语音、音乐与环境音同时存在)的场景中,模型表现更是大幅退化。这表明,当前方法在简单情境下具备一定能力,但距离真实复杂应用场景仍有明显差距。
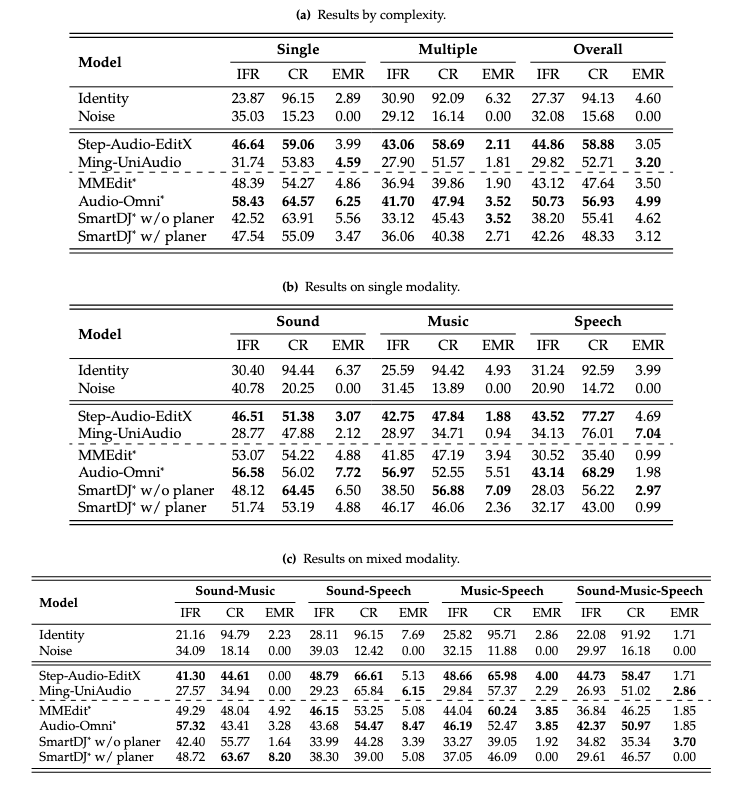
△ 主要实验结果
此外,实验还揭示出若干值得关注的现象:
仅看单一指标容易对模型能力产生误判:例如,Identity 基线直接输出原始音频,不执行任何编辑操作,能获得 94.13% 的 CR,部分提取任务也能拿到一些IFR分数;而 Noise 基线输出纯噪声,虽然完全破坏了原始输入,但在部分删除类任务中也可能获得较高的 IFR。这说明音频编辑本质上同时包含两个目标:既要准确完成修改,又要尽可能保留原有内容。只关注其中任何一项,都可能让模型通过“投机策略”获得不错分数。因此,MMAE 将 Instruction Following 与 Consistency 作为两个独立的评测维度,并引入EMR指标,对编辑能力进行更全面的刻画。
Agent机制提升有限:SmartDJ在引入Gemini 2.0 Flash进行规划后,IFR略有提升,但CR有所下降。这表明当前系统在“理解”(规划准确性)与“执行”(编辑可靠性)两个层面仍存在瓶颈,提示基础模型能力仍需进一步加强。
平均能力与完美执行存在差异:尽管Step-Audio-EditX在IFR与CR上均优于Ming-UniAudio,但其EMR反而略低。这反映出模型在“覆盖更多任务类型”与“确保单个任务完全正确”之间存在权衡,也提示平均指标并不能完全反映系统整体可靠性。
⏩这说明了什么?
MMAE的评测结果传递出若干重要信号:
音频编辑仍处于早期阶段:当前模型虽具备基础能力,但在精确性与稳定性方面仍有明显不足。
复杂任务构成主要挑战:从单步到多步,性能呈现显著下降趋势。
多模态融合是关键难点:在混合音频场景中,模型能力明显受限。
评测体系亟需升级:细粒度、可解释的rubric评测对于真实能力评估至关重要。
⏩总结与展望
作为首个面向通用音频编辑的系统性基准,MMAE为该领域提供了统一的评测框架与分析工具。研究团队期望其能够推动社区在以下方面持续进展:
建立可比性:统一评测标准以促进不同方法间的公平比较;
定位关键问题:通过细粒度分析明确性能瓶颈;
指引发展方向:提升原子级编辑能力、增强多模态建模能力,并构建更鲁棒的音频编辑系统。
总体而言,智能编辑作为理解生成统一的核心代理任务,在音频领域还处于非常早期的阶段。要实现精确、可靠的音频编辑仍有较长的发展路径,MMAE的提出,正是迈向这一目标的重要一步。
