
 语音小管家
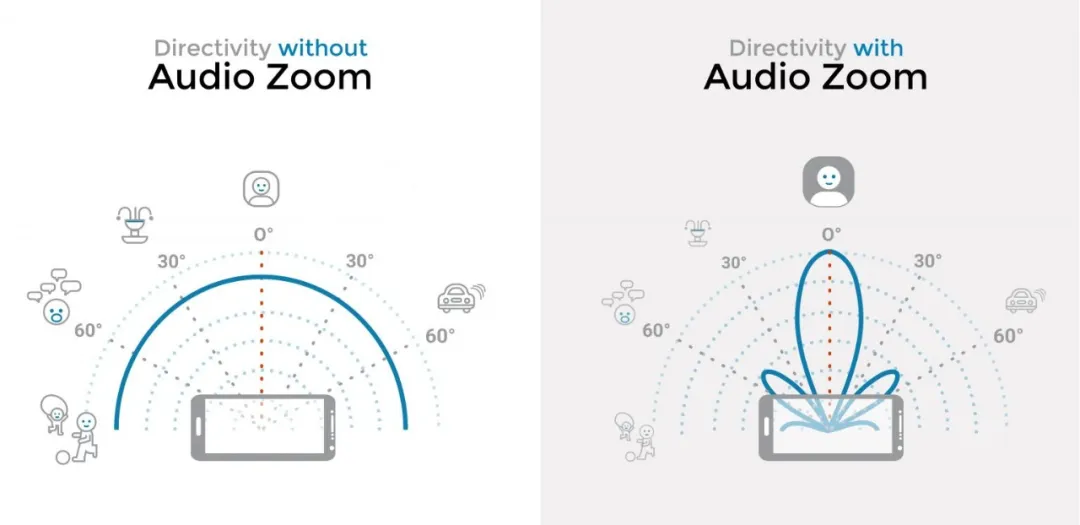
音频变焦背后的主要技术称为空间滤波(通常被称为波束成形)。这些技术通过微调从不同麦克风采集到的声音,来实现对无用噪声的过滤。人类的听觉系统拥有两项主要技能:分辨声音来源的方向,并随后聚焦于该声音。波束成形器的目标是以类似的方式工作,最终使目标声音更清晰、更聚焦。正如相机的变焦功能可以让你聚焦于远处的特定物体一样,波束成形使你能够以类似的方式聚焦于声音,如下图所示。一般来说,音频变焦包含以下几个步骤:
波束成形,进行空间滤波 后置滤波,对噪声进行进一步抑制 增益控制,对处理后的音频进行增益调整
Veen 和 Buckley (1988) 发表的具有影响力的综述重新审视了基础波束成形技术,其中包括延迟叠加法和最小方差无失真响应(MVDR)。Veen 和 Buckley 对它们的优缺点进行了对比:延迟叠加法简单且计算开销低,在要求不高的场景下表现尚可,但在干扰信号强于目标信号的场景中则表现受限。MVDR 在具有挑战性的混响环境中提供了更好的性能。它在对信号进行求和时能够提供良好的噪声消除能力和无失真响应。这意味着它可以分离并控制距离较近的信号,是实际拍摄行动中理想的采用方案。
MVDR的精髓就体现在无畸变上。什么叫无畸变呢,就是在对感兴趣方位(声源方向)的信号无失真地输出。MVDR波束形成器的公式推导并不复杂,我们这里简单的介绍一下。MVDR由Capon于1969年提出,也称为Capon波束形成器,它的目标是对感兴趣方位的信号无失真输出的同时使波束输出的噪声方差最小。波束输出噪声方差记为
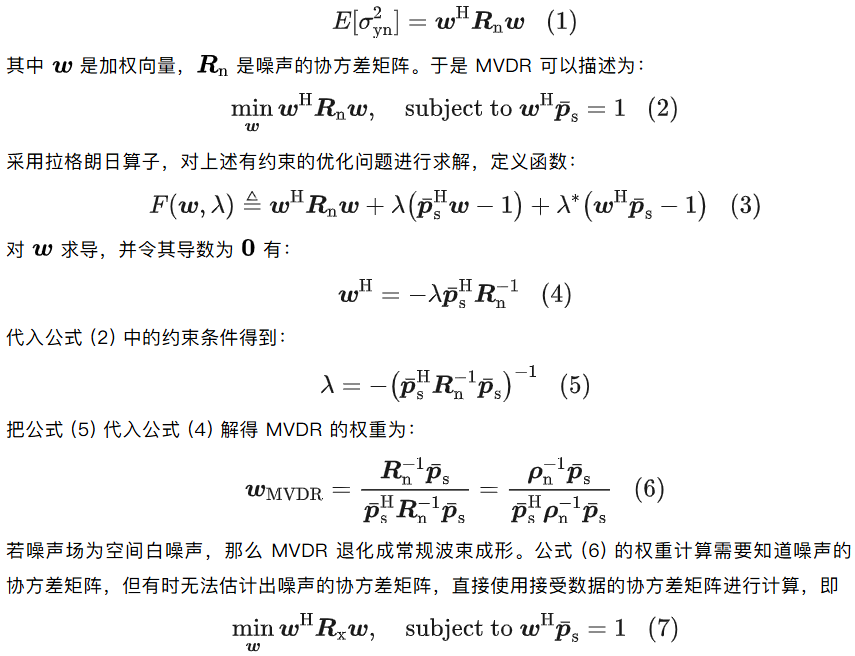
有的地方称上式的波束形成器为最小功率无失真响应(Minimum Power Distortionless Response, MPDR)。MVDR 的效果依赖于导向矢量和数据接受协方差矩阵精确与否,在理想环境下能够抑制干扰,最大程度提升信干噪比。
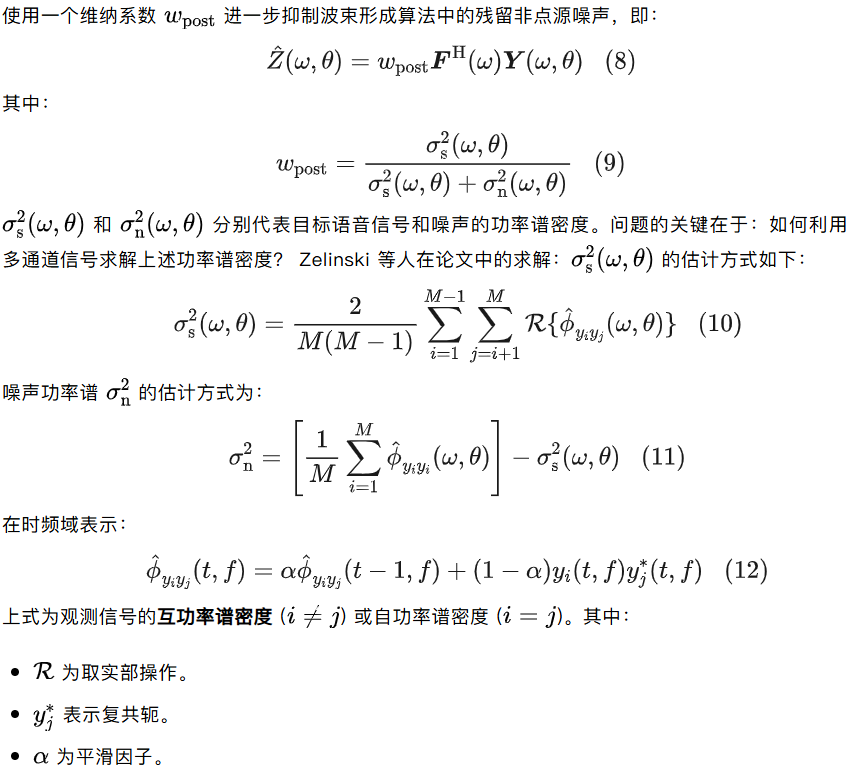
波束成形器主要针对具有明确方向性的点源干扰(如特定的噪音源)。然而,在现实环境中,存在大量的传感器自噪声(电路底噪)和弥漫混响场噪声(各向同性的噪声)。这些噪声在空间上是各向同性的,空间滤波器(波束成形)很难将它们完全剔除。此外当阵列孔径较小,对于波长较长的低频信号,波束的“主瓣”会变得非常宽,导致无法通过空间手段有效隔离低频干扰。经典的后置滤波器利用跨谱密度矩阵来估计相干与非相干能量比,从而有效降低那些无法通过“对准方向”来消除的漫反射噪声。
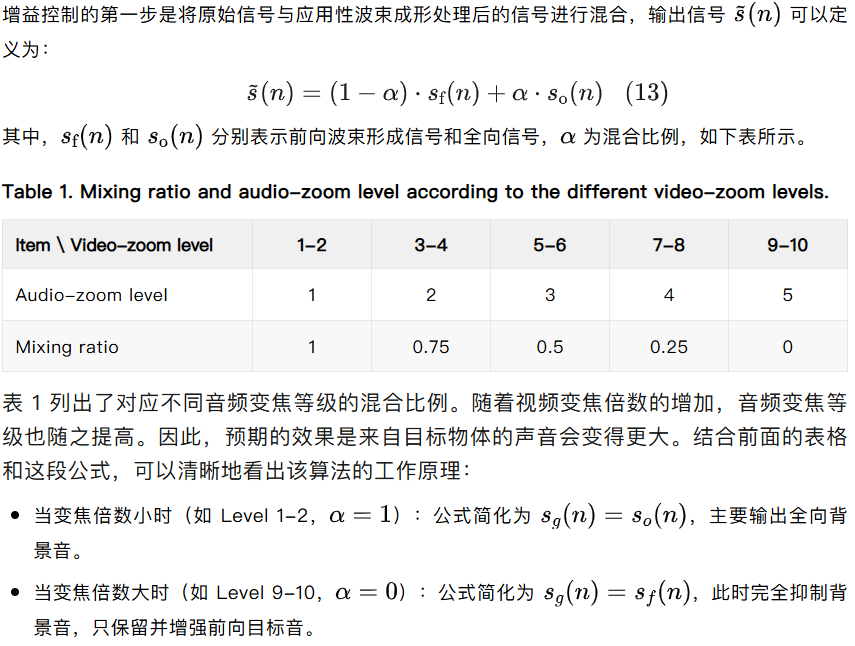
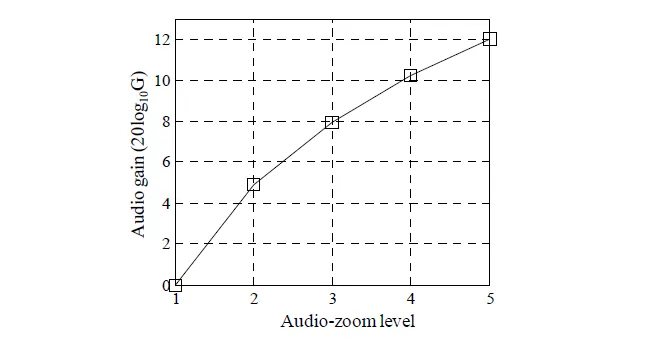
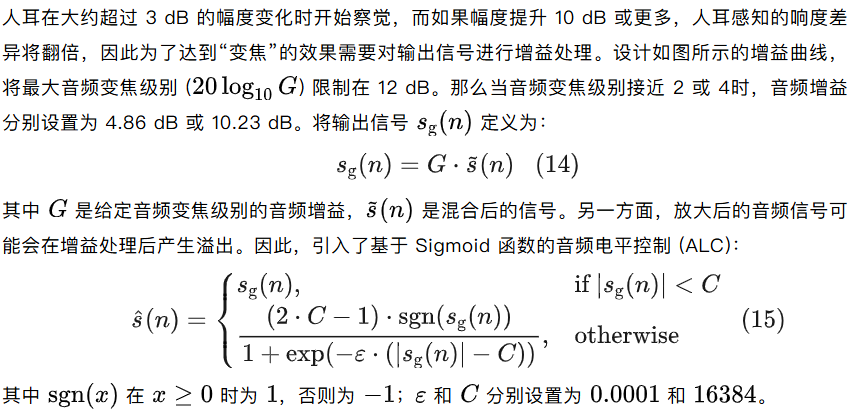
增益控制的第一步是将原始信号与应用性波束成形处理后的信号进行混合,输出信号
参考文献:
[1].https://2026.ieeeicassp.org/sp-cup/
[2].Audio Zooming in a Drone Surveillance System for Police Evidence Gathering
[3].AUDIO ZOOM FOR SMARTPHONES BASED ON MULTIPLE ADAPTIVE BEAMFORMERS
[4]. A Beamforming-Based Video-Zoom Driven Audio-Zoom
Algorithm for Portable Digital Imaging Devices
