IEEE-TASLP 基于双路检索深度差异建模的音频深度伪造检测

本次分享由内蒙古大学24级博士生张锦华、内蒙古大学刘瑞教授与香港中文大学(深圳)/ 深圳河套学院 李海洲教授合作发表在IEEE Transactions on Audio, Speech and Language Processing 20…
26 0 0

本次分享由内蒙古大学24级博士生张锦华、内蒙古大学刘瑞教授与香港中文大学(深圳)/ 深圳河套学院 李海洲教授合作发表在IEEE Transactions on Audio, Speech and Language Processing 20…

通义实验室正式推出 Fun-ASR1.5, 实现了「方言工业级可用」的语音识别大模型 。 它基于统一的大模型架构,单模型即可无缝覆盖30种语言、汉语七大方言体系及20+地方口音,古诗词吟诵也能精准转写。测试显示,典型方言场景字错误率(CER…
论文链接: https://arxiv.org/abs/2604.10708v1 代码链接: https://zeyuet.github.io/Audio-Omni 发表会议: arxiv Sora 带火了视频生成,但音频 AI 却一直深陷…


论文标题:Seedance 2.0: Advancing Video Generation for World Complexity 论文链接:https://arxiv.org/abs/2604.14148v1 代码链接:https://…
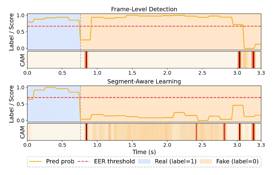
随着语音合成与语音转换技术的快速发展,语音深度伪造(Speech Deepfake)正变得愈发逼真与普及。从早期的整句生成,到如今更具隐蔽性的局部篡改(Partial Spoofing),攻击者可以仅修改语音中的关键片段(如数字、人名或关键…


体量轻巧、推理高效,Qwen3.6-35B-A3B 开源! 这是一款采用稀疏混合专家(MoE)架构的高效模型:总参数350 亿,每次推理仅激活30 亿参数。 参数量虽小,性能依旧强劲。在智能体编程上,它大幅超越前代 Qwen3.5-35B-…
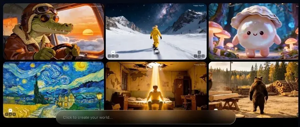
来源丨智东西,作者:王涵,编辑:李水青 阿里首个世界模型突然发布!实测一点不比李飞飞的逊色? 智东西4月16日报道,刚刚,阿里ATH创新事业部发布了其首款开放式世界模型HappyOyster(快乐生蚝)。 基于原生多模态架构,该模型支持多模…
