
 语音小管家
随着语音合成与语音转换技术的快速发展,语音深度伪造(Speech Deepfake)正变得愈发逼真与普及。从早期的整句生成,到如今更具隐蔽性的局部篡改(Partial Spoofing),攻击者可以仅修改语音中的关键片段(如数字、人名或关键词),从而在不破坏整体自然度的前提下实现精准误导。这类细粒度攻击不仅更难被察觉,也对现有语音安全系统提出了更高要求。本文提出了一种面向语音深度伪造定位的全新框架——Segment-Aware Learning(SAL),通过引入片段级结构建模与数据增强机制,使模型从“依赖边界检测”转向“理解整段伪造内容”,在多个数据集上显著提升了定位性能与跨域泛化能力。
Localizing Speech Deepfakes Beyond Transitions via Segment-Aware Learning
作者列表:毛宇琛,黄文,钱彦旻
合作单位:上海交通大学,宇生月伴
研究背景
在语音安全、媒体取证与内容审核等真实场景中,语音深度伪造定位(Speech Deepfake Localization)需要在检测精度、时间分辨率与泛化能力之间取得平衡——尤其是在局部篡改(partial spoofing)场景下,伪造往往只发生在若干关键片段,使得检测难度显著提升。相比整句伪造,这类攻击更加隐蔽,对模型的细粒度建模能力提出了更高要求。
现有方法大多依赖帧级分类(frame-level detection)或边界感知(transition-aware)策略,通过捕捉真实与伪造语音之间的拼接痕迹来定位篡改区域。然而,这类方法往往将注意力集中在“边界异常”上,而忽略了伪造语音在片段内部的连续结构,容易产生“shortcut learning”,即模型学会依赖数据中的拼接模式而非真实伪造特征,从而在复杂或跨数据场景中性能下降。
针对这一瓶颈,本文提出 Segment-Aware Learning(SAL),一种面向语音深度伪造定位的片段级建模框架。其核心思想是:不再仅依赖边界信息,而是通过显式建模语音片段的内部结构,使模型能够理解“整段伪造”的本质特征,从而实现更稳定、更泛化的定位能力。
SAL 的关键在于将原本的帧级二分类任务,拓展为具有结构信息的片段感知学习过程。一方面,通过引入片段位置感知监督(Segment Positional Labeling),让模型学习每一帧在片段中的相对位置;另一方面,通过跨片段混合(Cross-Segment Mixing)打破数据中的固定拼接模式,迫使模型关注真实的语音内容特征而非边界伪迹。这种设计使得模型能够从“检测拼接点”转向“理解伪造内容”。
SAL 的优势可以总结为:
片段级建模能力:从帧级判断升级为结构感知,提高对连续伪造区域的识别能力;
缓解 shortcut learning:降低对边界 artifact 的依赖,提升模型鲁棒性;
强泛化能力:在跨数据集场景中依然保持领先性能;
即插即用:无需复杂结构修改,可直接集成到现有 SSL + Conformer 等主流框架中;
工程友好:仅引入轻量级监督与数据增强策略,训练成本可控。
核心方法
SAL 的最大亮点在于:它既不是单纯强化边界检测,也不是额外设计复杂的伪造先验,而是通过一种片段感知学习机制(segment-aware learning),显式引导模型理解伪造语音片段的内部结构。换句话说,SAL 关注的不只是“哪里发生了拼接”,更关注“这一整段为什么是假的”。
从整体结构上看,SAL 并没有大幅改动现有的伪造定位框架,而是在标准的 SSL Encoder + Conformer + 分类头 的基础上,引入了两个关键设计:Segment Positional Labeling(SPL) 和 Cross-Segment Mixing(CSM)。其中,前者负责提供更细粒度的监督信号,后者负责打破训练数据中的固定拼接模式,从监督和数据两个层面共同缓解模型对边界 artifact 的依赖。论文第 2 页的框架图对这一设计给出了清晰展示:相比传统 frame-level detection,SAL 额外增加了 position logits 分⽀,并通过跨片段拼接增强训练样本的多样性。
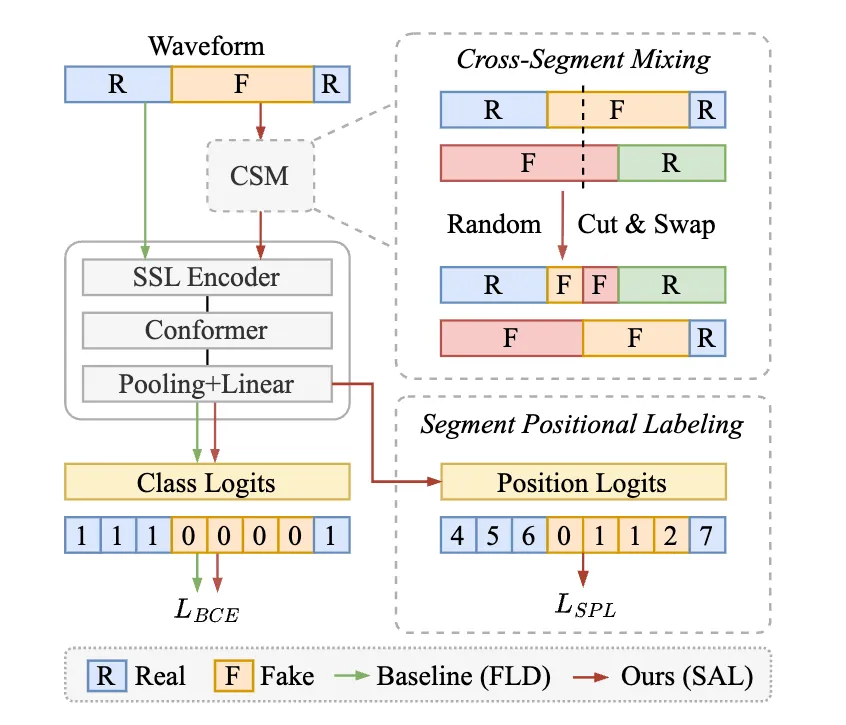
图 1: SAL 方法示意图
SAL 的关键之一在于 Segment Positional Labeling(SPL)。传统方法通常只给每一帧打上 “real / fake” 的二值标签,这种监督虽然简单,但过于稀疏,难以迫使模型学习连续片段内部的结构一致性。为此,SAL 进一步刻画每一帧在其所属片段中的相对位置:Start、Middle、End、Unit。再结合真实/伪造两类标签,最终形成 8 类更细粒度的监督目标。这样一来,模型学习的就不再只是“这一帧是真是假”,而是“这一帧是某个真实/伪造片段中的哪一部分”。这种设计等于把原来的逐帧二分类,升级为一种带有局部结构建模能力的多任务学习过程。
SAL 的另一个关键模块是 Cross-Segment Mixing(CSM)。这一模块的出发点非常直接:现有 partial spoof 数据集中的伪造片段长度、位置和拼接方式往往存在固定分布,模型很容易“记住”这些模式,而不是真正学会伪造语音的本质特征。CSM 通过从不同训练样本中随机切分并交换片段,构造出新的训练语音及对应标签,从而生成更加丰富的 segment pattern。更重要的是,当拼接点两侧属于同一类别时,SAL 不会把它错误地当成边界,而是将其标记为连续 segment 的中间位置,避免模型对“伪边界”产生过度敏感。这样,CSM 不仅提升了数据多样性,也进一步强化了模型对连续片段一致性的理解。
从训练机制上看,SAL 可以理解为:SPL 负责告诉模型“片段内部有结构”,CSM 负责告诉模型“边界模式不可靠”。前者增强监督,后者增强数据,两者结合后,模型被迫把注意力从边界尖峰转移到整个伪造片段本身。论文中的 Grad-CAM 分析也验证了这一点:相比传统方法主要在 transition 处产生尖锐激活,SAL 会在 spoofed segment 的内部区域维持更稳定、更持续的高响应,这说明模型真正学到了伪造内容的内在属性,而不只是拼接痕迹。
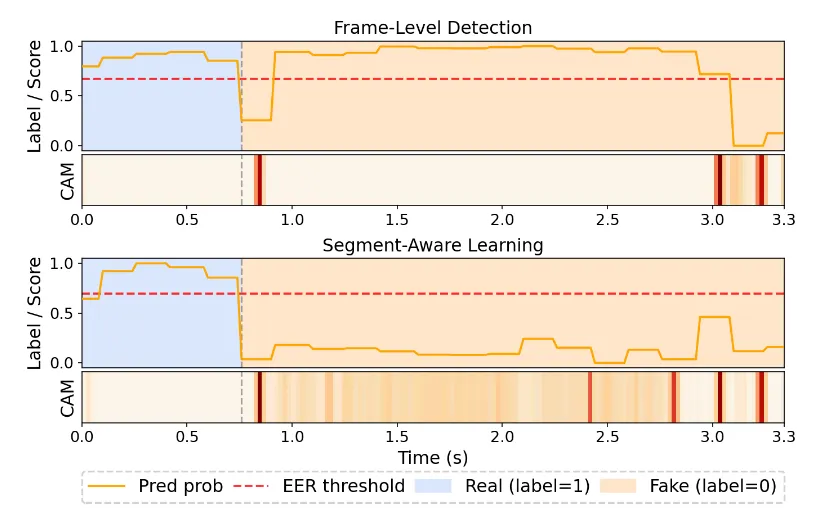
图 2: 基线与 SAL 在同一音频下的 Grad-CAM 可视化对比
从工程角度来看,SAL 还有一个很大的优点:简单、轻量、易于集成。它不依赖额外的大模型,不需要复杂的多阶段推理,也不引入明显的部署负担。无论是基于 Wav2Vec2-XLSR 还是 WavLM 的前端特征提取器,都可以较容易地接入 SAL 训练框架。也就是说,你可以把它看作是一种通用的训练增强范式:在不显著增加系统复杂度的前提下,让语音深度伪造定位模型从“边界驱动”迈向“片段驱动”。
实验结果与分析
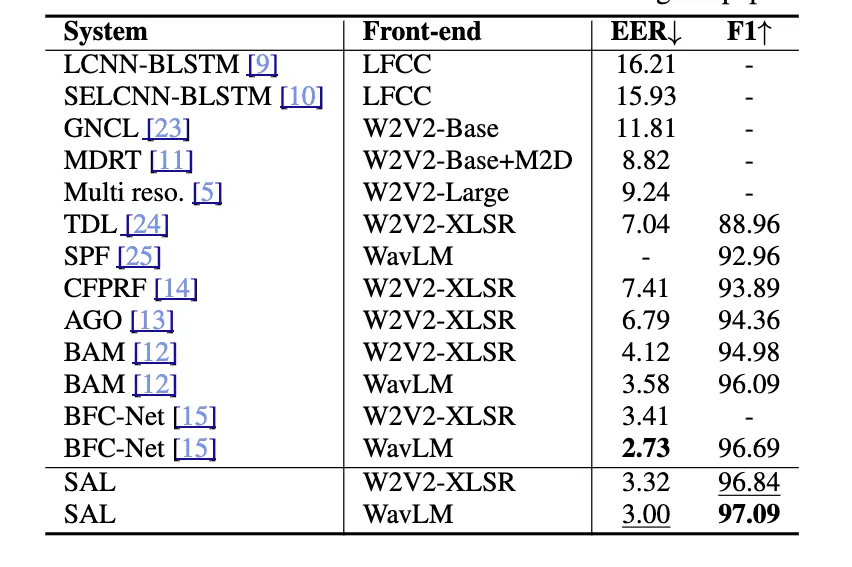
表 1: SAL 与其他方法在 PS 数据集上的性能比较
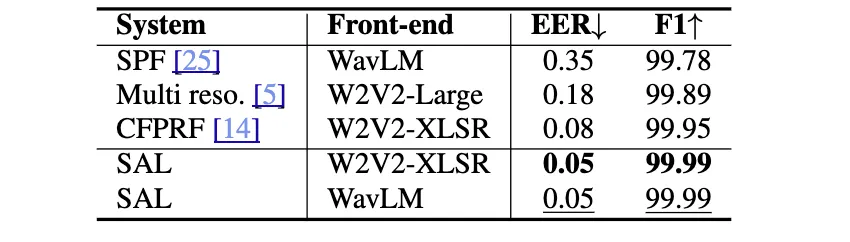
表 2: SAL 与其他方法在 HAD 数据集上的性能比较
在多个数据集上的实验结果表明,SAL 在语音深度伪造定位任务中表现出显著优势。在 PartialSpoof 基准上,SAL 取得了当前最优的 F1-score(97.09%),同时保持了与主流方法相当的 EER 水平,体现出更优的精度与召回平衡。在更简单的 HAD 数据集上,SAL 进一步将性能推至接近上限(EER 0.05,F1 99.99),全面超过现有方法,展现出强大的建模能力。
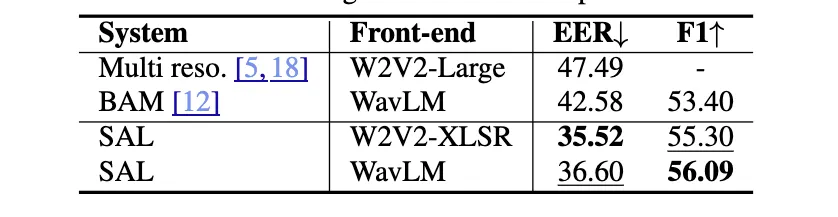
表 3: SAL 与其他方法在 LPS 数据集上的性能比较
更重要的是,在跨数据集评估(PartialSpoof → LlamaPartialSpoof)中,尽管所有方法均出现性能下降,SAL 仍然保持领先,说明其并未依赖特定数据分布,而是学到了更具普适性的伪造特征。
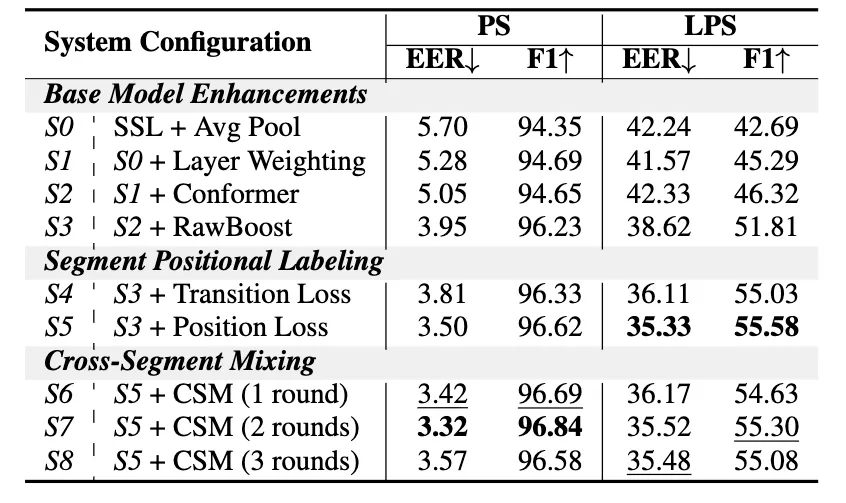
表 4: SAL 方法消融实验
这一点也在消融实验中得到验证:无论是引入片段位置建模(SPL),还是跨片段混合(CSM),都能稳定提升性能,其中位置建模带来的增益尤为显著,表明“理解片段内部结构”比单纯强化边界更关键。
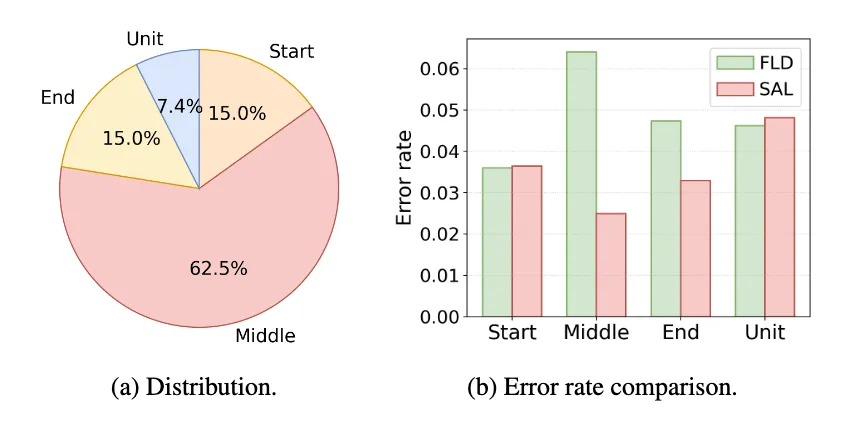
图 3: (a) 局部伪造音频中不同类型帧的分布 (b) 基线与 SAL 对不同类型帧的等错误率对比
从模型行为角度来看,Grad-CAM 可视化进一步揭示了 SAL 的本质优势:相比传统方法主要在拼接边界产生响应,SAL 的注意力能够覆盖整个伪造片段内部,并在长段区域保持稳定激活。这一变化直接带来了在中间片段(占比最高且最难检测)上的显著性能提升,说明模型已经从“依赖边界痕迹”转向“理解伪造内容本身”。
本文总结
SAL 用一个看似简单但关键的思路,将语音深度伪造定位问题,从“检测拼接痕迹”转化为“建模片段结构”。通过引入位置感知监督与跨片段混合机制,模型不再依赖脆弱的边界特征,而是学会捕捉伪造语音的内在属性。这项工作不仅提升了 partial spoofing 场景下的检测性能与泛化能力,也为语音安全任务提供了一种更具本质性的建模范式:从局部线索驱动,迈向结构与内容驱动。
参考文献
[1] Zhang L, Wang X, Cooper E, et al. The partialspoof database and countermeasures for the detection of short fake speech segments embedded in an utterance[J]. IEEE/ACM Transactions on Audio, Speech and Language Processing, 2022, 31: 813-825.
[2] Zhong J, Li B, Yi J. Enhancing partially spoofed audio localization with boundary-aware attention mechanism[J]. arXiv preprint arXiv:2407.21611, 2024.
[3] Luong H T, Li H, Zhang L, et al. Llamapartialspoof: An llm-driven fake speech dataset simulating disinformation generation[C]//ICASSP 2025-2025 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2025: 1-5.
[4] Babu A, Wang C, Tjandra A, et al. XLS-R: Self-supervised cross-lingual speech representation learning at scale[J]. arXiv preprint arXiv:2111.09296, 2021.
[5] Chen S, Wang C, Chen Z, et al. Wavlm: Large-scale self-supervised pre-training for full stack speech processing[J]. IEEE Journal of Selected Topics in Signal Processing, 2022, 16(6): 1505-1518.
供稿 | 毛宇琛,编辑 | 方楠,审核 | 钱彦旻
