
 语音小管家
AI与人的长期关系,需要在一次次交流中建立起来。
昨天聊过的内容,可以帮助AI理解今天的对话;今天的对话,也会成为它下一次回应的依据。
AGI Being所指向的,正是一种能够在长期相处中逐渐了解一个人的智能存在。
而在实时语音中,AI怎样才能快速找到相关记忆,又自然地接上话?
2026年3月,Salesforce AI Research在VoiceAgentRAG论文中,将检索称为语音链路中的“关键延迟瓶颈”。研究者指出,在生产环境中,一次向量数据库查询,单是网络往返通常就需要50—300毫秒,再加上其他处理环节,很容易超出自然对话的时延预算。
长期记忆也会遇到类似的问题。
VoiceMem论文指出,常规记忆检索与处理往往需要2—3秒,而实时对话能够接受的额外时延约为100—200毫秒。
AI需要结合之前的对话,才能更好地理解用户。但如果每次查找记忆都要花上几秒,对话就很难保持流畅。
记得住,还必须及时起来。
围绕这个矛盾,VoiceMem给出了一套可行的解法。
来自南洋理工大学、新加坡国立大学、清华大学、香港中文大学和Open Interaction Lab的研究者,共同提出了这套面向语音交互的无延迟“流式双脑”记忆框架。
这项工作也延续了论文第一作者谢之非的研究主线:他是目前大音频语言模型、实时语音交互与多模态AI领域内非常活跃的研究者之一。
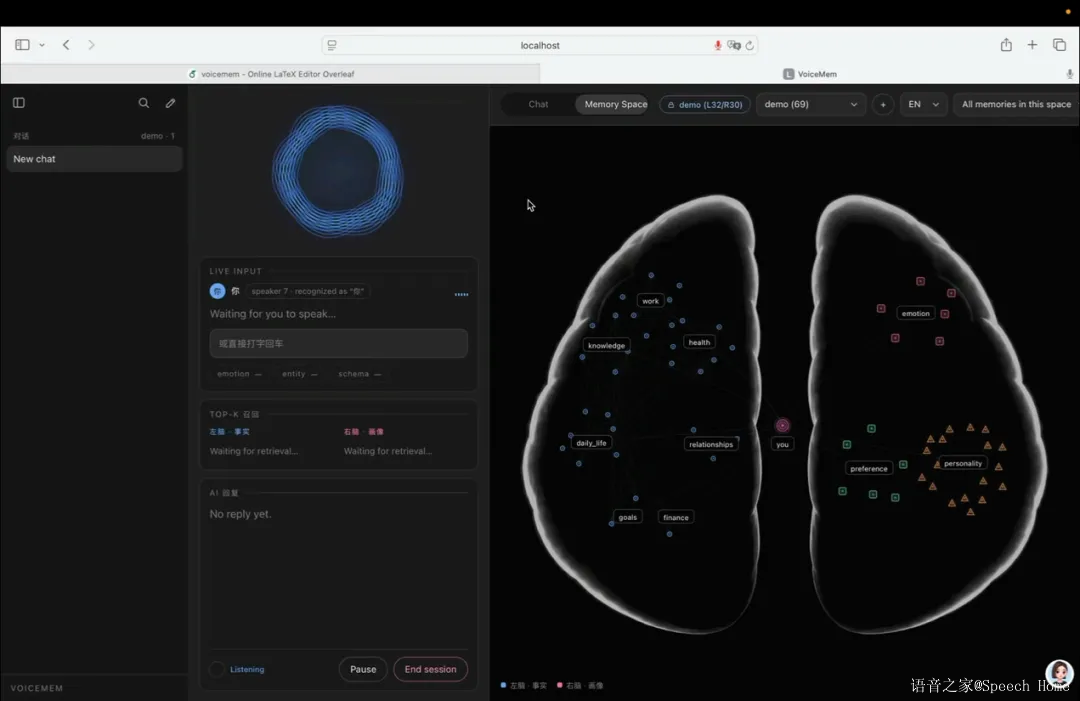
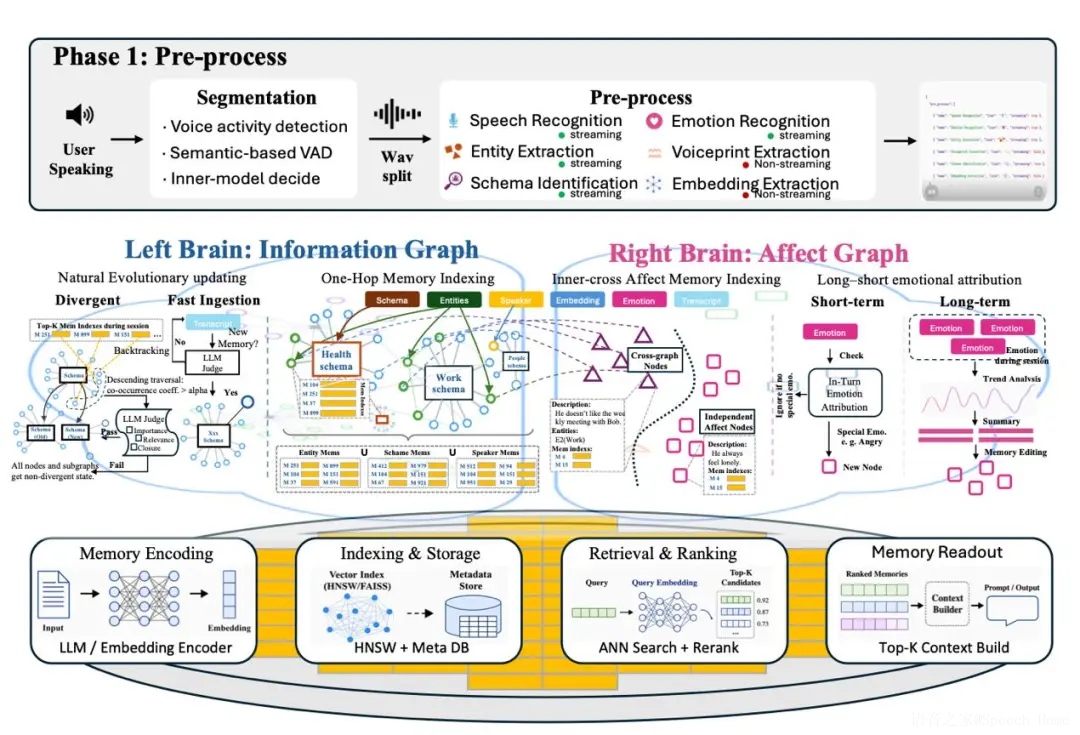
它将人物、事件和事实交给信息左脑组织,将相对稳定的人格,以及对不同对象的态度和情绪交给情感右脑维护。两套记忆协同调用,让过去发生的事情和用户当时的感受,都能够成为理解当前对话的依据。
为了让记忆及时参与回应,VoiceMem在用户仍在说话时就提前启动处理,把记忆访问叠进系统判断用户是否结束发言的等待窗口。论文指出,双脑记忆检索耗时134毫秒,结合流式调度实现了近乎零延迟——几乎不再为对话增加额外等待。
速度之外,它也提高了有限检索预算下的准确率。
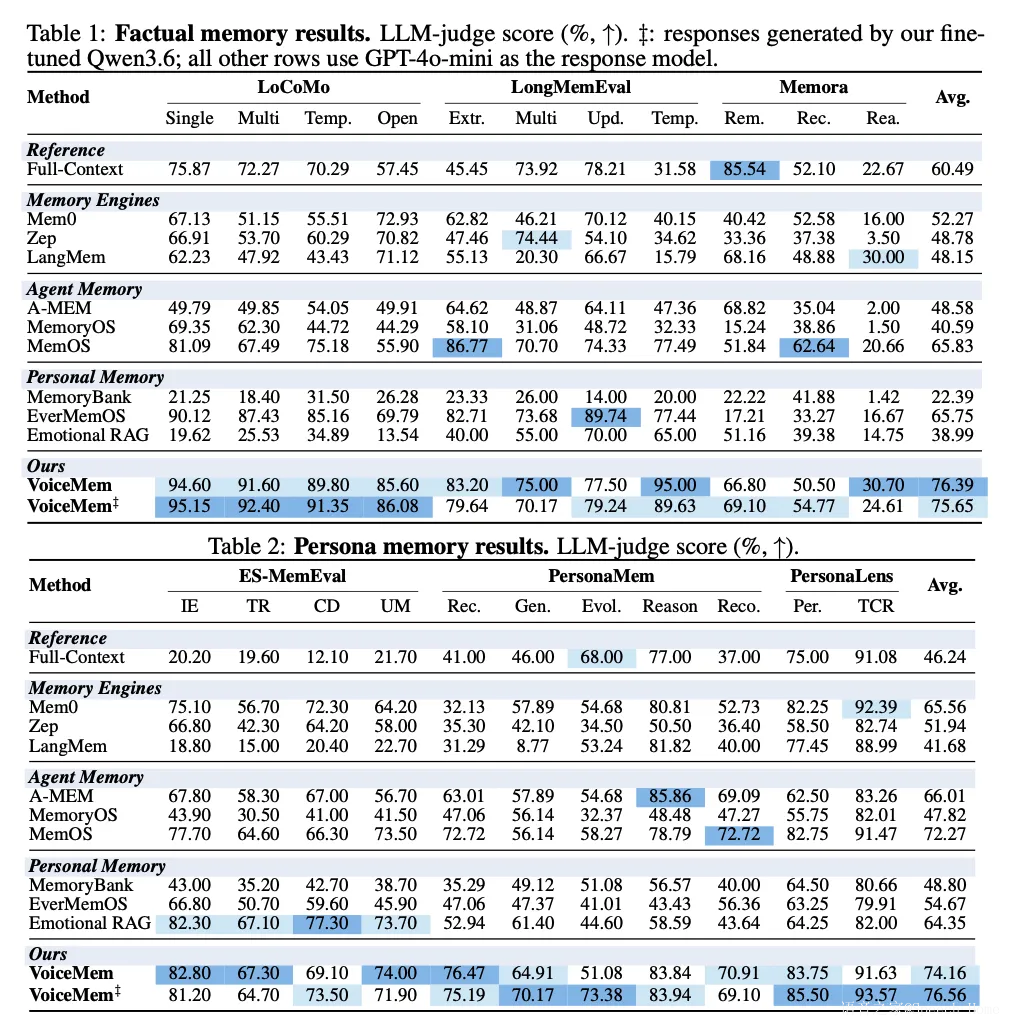
在LoCoMo上,VoiceMem仅取回5条记忆便取得91.2分,比Mem0取回200条高出29.52分;人格记忆平均得分达到74.16分,比论文对比中此前最强的基线MemOS高1.89分。
这让事实回忆、人格理解和实时回应,能够在同一套系统中协同工作。
目前,VoiceMem已经开源,提供可安装的 voicemem 包、流式调用示例、交互式Demo、模型、数据集和评测入口。Qwen Audio Agent也已提供VoiceMem接入方案,支持将其作为可选记忆系统,在新的语音会话中继续召回用户偏好与长期事实。
对于AGI Being,长期相处的意义,也正在这里。
一个人的选择会变化,情绪会变化,对同一件事的看法也会变化。能够长期陪伴的AI,需要在这些变化中不断更新认识,并让积累下来的理解影响之后的回应。
VoiceMem向前推进的一步,就是让共同经历能够在自然的对话节奏中被重新调用。
当AI能够带着过去的理解参与今天的交流,再从今天的交流中继续认识你,人与AI之间才有了可以持续积累的关系。AGI Being所指向的长期共生,也就有了更加具体的起点。
- Project page: https://xzf-thu.github.io/VoiceMem
- Code: https://github.com/xzf-thu/VoiceMem
- Report:https://arxiv.org/pdf/2608.26005
- Model Adapter:https://huggingface.co/zhifeixie/VoiceMem_MF_Qwen3_6_35B_A3B_Qlora
- Dataset:https://huggingface.co/datasets/zhifeixie/VoiceMem-ChatMem400k
⏩ ⼀句话看懂VoiceMem
两个脑,⼀套流式检索:
- 信息左脑:通过Schema和Entity组织事实记忆,回答“过去发⽣过什么”;
- 情感右脑:通过⼈格节点管理⻓期特征、情感和态度,回答“⽤⼾是⼀个怎样的⼈”;
- 流式检索:⽤⼾说话时持续完成ASR,根据已经听到的内容提前圈定记忆范围,再利⽤⽤⼾说完后的⾃然停顿完成搜索。
两个脑在存储时各⾃分⼯,在检索时彼此协作。右脑可以利⽤左脑已经激活的⼈物、事件或概念,缩⼩⼈格与情感记忆的搜索范围。这样,系统找回的不只是“⽤⼾曾经提到过某个项⽬”,还可以找到⽤⼾对这个项⽬⻓期表现出的态度。
⏩ 为什么⽂本Agent的记忆不能直接搬过来?
Mem0、Zep、MemOS等系统已经可以为⽂本Agent提供⻓期记忆,为什么不能直接接到语⾳模型后⾯?
问题⾸先出在速度。
传统记忆流程通常需要2―3秒,⽽⾃然的实时对话只能容许约100―200毫秒的额外时延。⼀次明显的停顿,就⾜以破坏语⾳交互的节奏。
第⼆个问题是检索数量。
⽂本Agent可以⼀次取回Top-100甚⾄更多记忆,再交给模型筛选。但语⾳模型的上下⽂容量和响应预算更加有限,⼤量记忆会带来额外的token成本。
如果直接把Top-100缩减到Top-5,真正有⽤的信息⼜可能被⼏条“看起来相关”的结果挤出去。因此,问题并不是简单地“少返回⼏条”,⽽是:
如何在只保留五个位置的情况下,让每⼀条记忆都更有⽤?
除此之外,现有记忆系统主要保存“⽤⼾说过什么”,却很少进⼀步区分:
- ⽤⼾⾃⾝相对稳定的性格和⾏为模式;
- ⽤⼾对具体⼈物、事件或概念的情感;
- ⼀次短暂情绪与⻓期⼈格之间的差别。
VoiceMem正是围绕准确率、情感建模和实时性,对记忆的组织与检索流程进⾏了重新设计。
⏩ 技术要点⼀:信息左脑,先路由再排序
⽇常记忆检索最容易出现的问题,是“搜得到,但搜不对”。
例如⽤⼾问:“上次体检结果怎么样?”
仅按照⽂本相似度检索,系统可能找回多条包含“体检”的记忆,却漏掉真正记录检查结果的那⼀条。问题不只发⽣在排序阶段,也发⽣在排序之前划定的搜索范围。
VoiceMem的信息左脑使⽤两级Schema―Entity索引组织事实记忆:
- Schema负责粗粒度语义路由;
- Entity负责定位具体的⼈物、事件和概念;
- 底层记忆项则连接在相应的Entity之下。
查询到来后,系统先匹配相关Schema和Entity,再沿强、弱⼀跳关系进⾏扩展。底层记忆引擎不会搜索完整记忆库,⽽是只在已经缩⼩的候选池中寻找Top-K。
⼀句话概括:
先找到正确的记忆区域,再在⼩范围内完成排序。
记忆还会⾃动更新
每轮对话结束后,异步更新器会提取新的事实,并结合附近的已有记忆执⾏:
- ADD
- UPDATE
- DELETE
- KEEP
对应的Schema、Entity和关系也会在对话主流程之外更新,不占⽤⽤⼾等待回复的时间。
分类不是提前全部写死的
记忆不断增加后,⼀个类别可能越⻓越⼤,内部信息密度随之下降;但如果频繁按照固定规则拆分,⼜可能割裂原本相关的记忆。
VoiceMem因此引⼊了Cluster Emergence,簇涌现机制。
系统观察哪些Entity会在实际查询中反复被共同激活,再根据共同检索模式形成候选⼦图。随后,LLM从相关性、重要性和完整性三个⽅⾯进⾏判断,只有满⾜条件的⼦结构才会被提升为新的记忆簇。
在论⽂对运⾏后记忆结构的分析中,左脑存储包含510条记忆和6个预设类别。系统运⾏后,⼜有两个⾮预设类别从语义图中涌现,共覆盖254条记忆,占整个存储的49.8%。
新的组织⽅式不是提前规定出来的,⽽是从⻓期使⽤和检索模式中逐渐形成的。
⏩ 技术要点⼆:情感右脑,区分“此刻的情绪”和“⻓期的你”
“⽤⼾不喜欢每周例会”和“⽤⼾容易焦虑”,属于两种不同的记忆。前者与⼀个具体对象有关,后者描述相对稳定的⽤⼾特征。如果把两者混在⼀起,系统可能记住“焦虑”这个标签,却不知道这种情绪因谁⽽起、在什么情境下出现。
VoiceMem因此设置了两类⼈格节点:
1. Independent persona nodes
记录⽤⼾⾃⾝相对稳定的特征,包括⻓期性格、⾏为规律和情感倾向。
2. Cross-entity persona nodes
记录⽤⼾对具体⼈物、事件或概念的情感,并连接到左脑中的相应Entity。前者回答“这个⼈通常怎样反应”,后者保留“这种情绪与谁、与什么事情有关”。在此基础上,右脑同时进⾏短期和⻓期情感归因。
短期归因
处理“此刻发⽣了什么”,保存当前情绪、情绪针对的对象以及产⽣的原因。
⻓期归因
处理“这种反应是否反复出现”。⼀段会话结束后,系统联合分析多轮情绪证据,将持续出现的情感与⾏为模式沉淀为稳定的⼈格记忆。
它不会因为⽤⼾今天有点不耐烦,就永久写下“这是⼀个暴躁的⼈”。
论⽂强调,⻓期归因并不是累积每⼀个瞬时状态,⽽是识别反复出现、能够解释⽤⼾⻓期⾏为的模式。实验也说明,看⻅全部对话历史,并不等于真正理解⽤⼾。
在ES-MemEval中,Full-Context基线已经能够读取完整历史,但在冲突检测和⽤⼾建模任务上分别只有12.10分和21.70分;VoiceMem对应达到69.10分和74.00分。
关键不只是模型有没有看⻅这些信息,⽽是有没有把分散在⻓期对话中的证据组织成对⼀个⼈的认识。
⏩ 技术要点三:流式记忆架构,把134毫秒检索藏进VAD等待时间
真正的“零耗时”并不存在。
VoiceMem的做法,是让记忆检索更早开始。
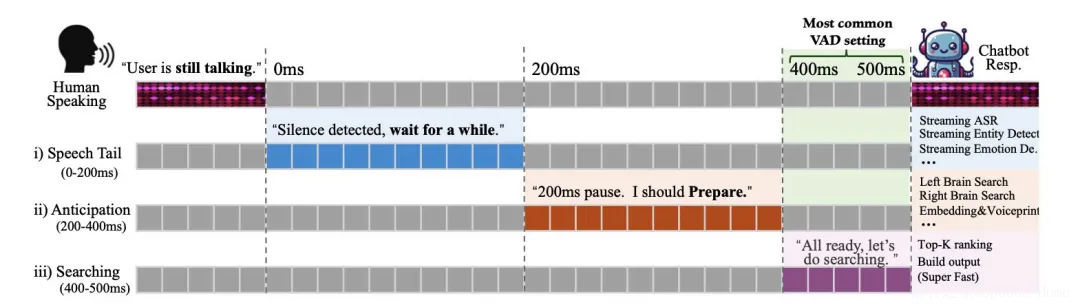
整个流式检索过程被拆成四个阶段:
1. Listening
⽤⼾仍在说话时,系统已经在流式完成ASR、说话⼈识别,以及左右脑中的Schema、Entity和⼈格节点匹配。
2. Speech Tail:0―200毫秒
系统检测到静⾳,但暂不判断⽤⼾已经结束表达。此前的流式识别和节点匹配结果继续积累。
3. Anticipation:200―400毫秒
当静⾳达到200毫秒,系统假设回复即将开始,提前计算查询Embedding,并展开左右脑的上层图。
4. Searching:400―500毫秒
此时只剩下底层记忆搜索,以及左右脑结果的合并与输出。
常⽤VAD阈值约为500毫秒。论⽂指出,这可以在回复开始前留下约400毫秒的处理窗⼝,⽽VoiceMem的密集双脑检索只需要134毫秒。
等VAD正式确认⽤⼾说完时,相关记忆已经基本准备好。
所以,VoiceMem所说的near-zero added latency并不是物理耗时为零,⽽是记忆检索⼏乎不再增加额外、可感知的对话等待。
⏩ 效果怎么样?
论⽂在7个主要Benchmark上,与10种记忆系统或基线进⾏⽐较。除特殊实验外,VoiceMem默认只检索K=5条记忆。
信息记忆
VoiceMem在11类信息任务中的7类取得领先,平均得分为76.39。
相⽐之下:
- ⽐作为底层存储后端的Mem0⾼24.12分;
- ⽐直接读取完整历史的Full-Context⾼15.90分;
- 在需要同时找回多条记忆的时间推理任务上,优势尤其明显。
在LoCoMo上,VoiceMem仅检索5条记忆就达到91.2分;论⽂指出,Mem0即使检索到Top-200,成绩仍⽐VoiceMem低接近30分。
⼈格记忆
VoiceMem在⼈格记忆评测中的平均得分为74.16,⽐此前最强基线MemOS⾼1.89分。
移除右脑后,LoCoMo、ES-MemEval、ChatMem-Bench和Memora分别下降6.3、4.3、5.4和4.4分。
这说明⼈格与情感并不只是给回答增加⼀点“情绪价值”,其中确实包含事实记忆⽆法提供的信息。
⻓期真实语⾳评测
为了进⼀步验证记忆系统在真实、⻓期语⾳环境中的表现,研究团队构建了ChatMem-Bench。
它包含:
- 316个问题;
- 15314轮对话;
- 约53⼩时⾳频;
- 4个能⼒维度;
- 14类细分任务。
四个维度分别是信息记忆、⼈格理解、情感归因,以及副语⾔与环境声⾳。
VoiceMem在14类能⼒中的11类取得领先。
差距最⼤的,是⽂字转写⽆法直接提供答案的声学任务。在三个声学类别中,⽂本系统的得分为3.23―26.92,VoiceMem达到45.16―53.84。
准确率、token和时延
在LoCoMo上:
- VoiceMem在K=5时取得91.2分;
- 只使⽤430个记忆token;
- 检索耗时134毫秒。
对⽐中最强的基线EverMemOS需要检索Top-10,使⽤1899个token,得分为83.13。
也就是说,VoiceMem的记忆token⽤量仅为EverMemOS的约23%,同时得分⾼出约8.1分。
⏩ 给谁⽤?
- 做语⾳Agent、数字⼈或陪伴机器⼈的团队:希望系统能够在⻓期交互中持续认识⽤⼾;
- 做全双⼯语⾳交互的开发者:需要在严格时延预算下接⼊记忆能⼒;
- 做智能硬件或多说话⼈系统的团队:需要保存声纹、环境声⾳和副语⾔信息;
- 做Agent Memory研究的开发者:希望在Mem0、LangMem或Zep等后端之上增加更精确的组织与路由机制。
VoiceMem把记忆层与底层搜索引擎解耦,开发者可以替换记忆后端,也可以把记忆结果接⼊⾃⼰的语⾳模型。
⏩ 写在最后
VoiceMem并不试图直接回答“AI何时会成为Being”。
它做的是更具体的⼀步:把“记忆必须跟上实时交互”从⼀个抽象设想,推进成可以实现、评测和持续优化的⼯程问题。
如果说实时交互让Digital Being能够出现在⼈⾯前,那么记忆决定了它下⼀次出现时,还是不是“同⼀个它”。
⏩ 作者介绍
论文第一作者为谢之非,尾作及通讯作者为颜水成。
谢之非现为南洋理工大学LV-Lab博士生,研究聚焦实时音视频交互。第一作者研究成果获超600次引用,其相关开源项目已累计获得8.5K+ GitHub Stars,曾主导首个端到端语音对话模型 Mini-Omni 系列,FFASR leaderboard rank-1 的Mega-ASR全场景语音识别等项目。
颜水成现任新加坡国立大学计算机学院杰出教授,曾任Sea集团首席科学家,是新加坡工程院院士及AAAI、ACM、IEEE和IAPR会士,连续十年入选全球高被引科学家。其Google Scholar总引用超过13.6万次,曾提出Network In Network(NIN)架构,并采用全局平均池化替代传统全连接层。
从Mini-Omni解决端到端实时语音对话,到Audio-Reasoner和Audio Interaction Model推进音频推理与主动交互,再到VoiceMem补上长期记忆,这项工作延续了他围绕实时语音Agent,逐步完善感知、推理、交互与记忆能力的研究路线。
