
 语音小管家
论文题目:SimulS2ST-Omni: Data-Efficient Streaming Speech-to-Speech Translation via Explicit Trajectory Supervision
会议名称:EMNLP 2026 Main Conference
论文链接:https://arxiv.org/abs/2607.19810
项目主页:https://github.com/hasaki321/SimulS2ST-Omni
模型权重:https://huggingface.co/HA-SA-ki/SimulS2ST-Omni
在线 Demo:https://hasaki321.github.io/SimulS2ST-Omni.demo/
设想一场没有预先分句的英文直播:系统既不知道一句话会在何处结束,又必须持续输出中文语音。流式语音到语音翻译(Streaming S2ST)不仅要决定“翻译什么”,还要不断判断“继续听、暂时等,还是现在说”。现有方案主要面临三道障碍:
1. 难以摆脱句子边界:级联系统容易累积延迟和误差,许多端到端模型仍需要完整话语;早期流式方法也往往依赖于分段语音、句子边界或特定对齐结构,难以稳定处理不断延伸的长语音流。
2. 缺少明确的读写路径:模型必须根据不完整输入自主做出“读取—等待—输出”决策,而语音语义码一经生成并播放便无法收回。仅有文本侧轨迹并不足够,文本和语音还需要共享一致的发射节奏。
3. 成对数据稀缺且存在模态冲突:S2ST 模型需要同时学习语音理解、文本规划和密集语音码预测,但成对跨语言语音远少于 ASR、MT 或 TTS 数据。现有长时系统通常依赖数万小时成对语音、专家对齐或复杂强化学习,低数据方案则常对超参数和离线对齐较为敏感。
因此,本文聚焦的问题并不只是“怎样让翻译更快”,而是:能否在成对 S2ST 数据有限的条件下,让模型学会一条稳定、可控,并能同时驱动文本与语音输出的长时流式路径?
SimulS2ST‑Omni 提出一套全新训练流程与模型架构,仅依托约 2000 小时跨语言 S2ST 配对数据,便可同时胜任句子级翻译与长语音流实时同传任务。即便将配对语音数据预算削减 90%,依靠辅助多任务训练机制,系统性能依旧保持稳健。
我们通过三项关键技术,让高质量 “边听边译” 流式语音翻译落地成为可能。
1️⃣联合文本-码轨迹监督:让模型学会“何时出声”
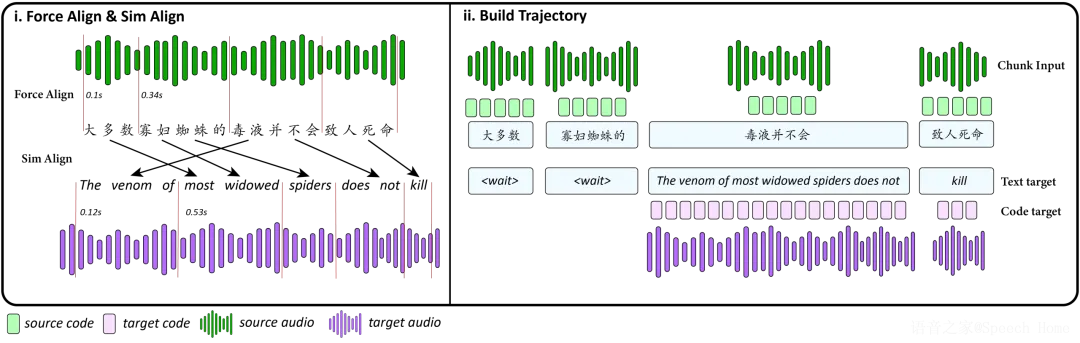
流式联合文本-码轨迹监督轨迹构造流程
流式翻译的难点不仅是生成正确译文,还包括决定何时读取、等待和输出。SimulS2ST-Omni 首先对源语音、目标文本和目标语音进行词级及跨语言对齐,并把目标语音转换为离散语义码。随后,目标文本和对应的语音语义码继承相同的单调化时间边界,共同组成一条增量式的文本—语义码承诺路径。
通过这种显式轨迹监督,模型能够在训练中直接学习:读到多长的源语音后,可以输出哪一段目标文本及其语音语义码。文本输出和语音输出因而共享同一套节奏,无需再额外训练独立的语音侧发射控制器。
2️⃣双流 Thinker-Talker 分解架构:术业有专攻
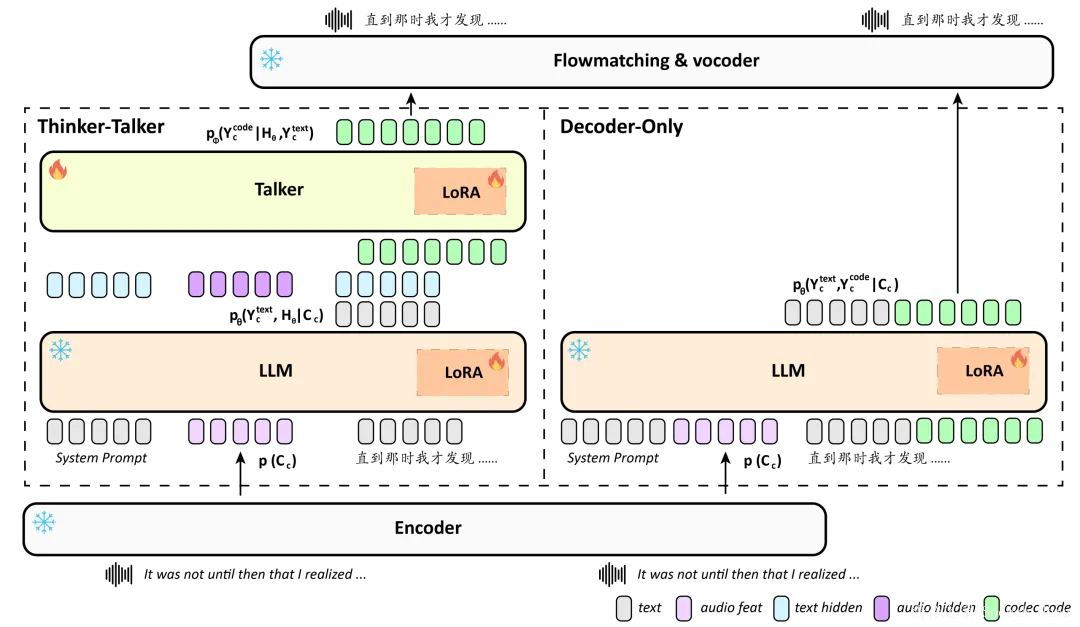
统一解码器与Thinker-Talker结构对比
语音翻译本质上包含两个截然不同的任务:
- 语言推理(“这句话是什么意思?该怎么翻?”)
- 声学预测(“这句话用目标语言说出来,声音波形应该是什么样的?”)
如果让同一个解码器同时承担两类任务,文本推理和密集语音码预测可能在共享表示中相互干扰,彼此会“抢资源”。我们选择把它们拆开:
- Thinker(思考者):专注语言推理(“说什么”),基于 Qwen2.5-Omni 保障高质量文本翻译;
- Talker(表达者):专注声学预测(“怎么说”),是一个轻量级的语义码生成器,负责把文本转换成语音表达。
- 冻结的 Flow Matching 与声码器后端进一步将语义码还原为目标语音。
两条路径各司其职,使语言推理不必直接承担高密度语音码预测,同时让语音生成获得明确的文本和隐藏状态条件。实验证明,这种“各司其职”的设计,在 ASR-BLEU 指标上相比统一解码器基线高出 4.0 分,翻译内容更准确、更完整。
3️⃣显式轨迹监督:一个模型,适配所有延迟档位
不同的场景对延迟的要求不同——直播需要极低延迟,讲座可以容忍稍高延迟换取更高品质。过去,每换一个延迟档位就要重新训练一个模型。
我们通过引入一个延迟乘数,在训练时让模型在不同延迟档位下都能获得监督信号。最终训练出的单个模型,即可在 m1、m2、m3、m4 等多个延迟档位间平滑切换,无需为每个档位单独训练,让模型自主学会“何时输出”的决策。
为全面评估 SimulS2ST-Omni 在流式同传任务上的综合能力,我们从流式实时翻译性能、离线翻译效果、架构取舍和数据效率等多个维度开展对比实验与消融分析。实验既与开源学术基线和闭源商用系统进行横向比较,也针对 Thinker–Talker 架构、轨迹筛选和辅助监督等核心设计验证其有效性,综合考察翻译质量、流式延迟与训练数据效率。
- 比肩商用标杆:在 RealSI 和 ACL60/60-dev 等真实场景流式翻译基准上,SimulS2ST-Omni 取得了极具竞争力的质量—延迟权衡。
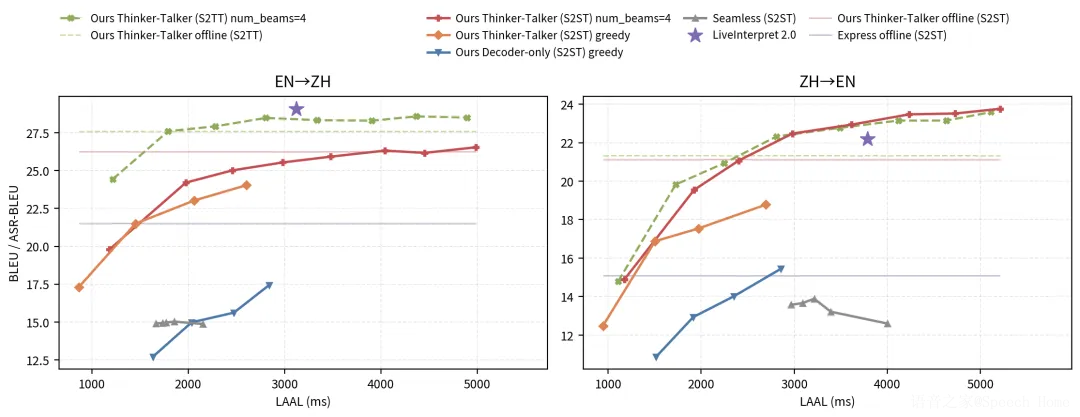
RealSI句子级流式语音到语音翻译 质量-延时曲线
流式 S2ST:在 RealSI 句子级和长时测试中,Thinker–Talker 在各延迟档位均优于匹配的统一解码器基线;与 LiveInterpret 2.0 相比,系统在句子级 Zh→En 的部分中高延迟档位以及长时 En→Zh 的多个档位上达到或超过其 ASR-BLEU,其他方向也保持接近的竞争力。
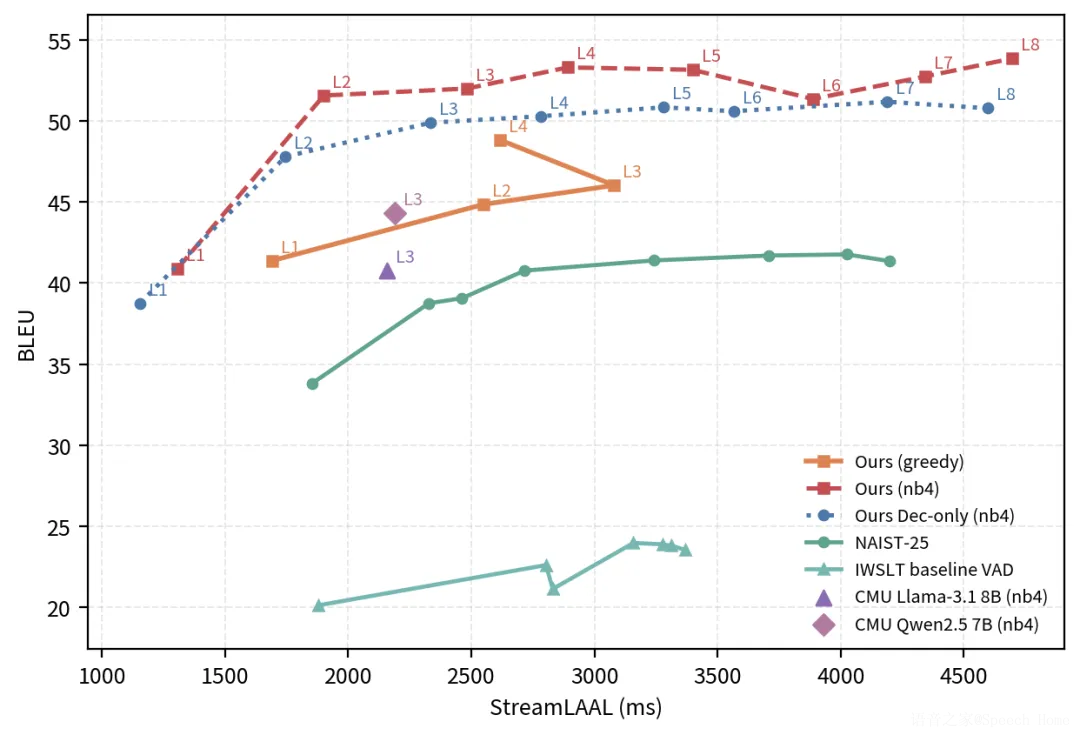
ACL60/60-dev长流式语音到文本翻译 质量-延时曲线
流式 S2TT:在 ACL60/60-dev 长时 En→Zh 测试中,标准束搜索配置在 m3 档位达到 52.30 BLEU;在相近延迟区域,整体质量—延迟曲线优于所比较的外部学术基线。
- 离线能力同样出众:在 CVSS-T 离线 En→Zh 任务中,相比匹配的统一解码器基线,Thinker–Talker 的 Text-BLEU 提升 2.14,ASR-BLEU 提升 4.0,说明双流解耦能够改善文本规划和目标语音中的内容保真度。
- 一模型覆盖多场景:无需改动模型权重,只需调节延迟乘数,即可让同一个模型检查点覆盖多个质量—延迟工作点,适配直播等低延迟场景,以及允许等待更多上下文、追求更高翻译质量的会议或讲座场景。
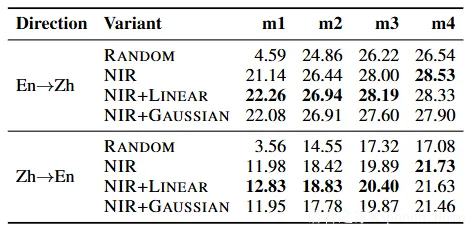
数据采样方法与轨迹采样方法的消融实验
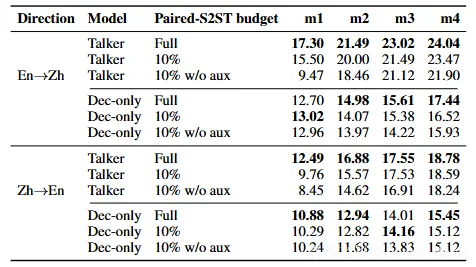
降低数据规模和辅助任务的消融实验
当成对 S2ST 数据缩减至完整规模的 10% 时,只要保留 ASR、S2TT、MT 等辅助轨迹监督,Thinker–Talker 在中高延迟档位上的性能仍接近完整数据模型。移除辅助任务后,低延迟条件下的性能下降更加明显。
另一组消融实验显示,面向单调性的轨迹筛选对于低延迟性能尤为重要。与随机选择训练轨迹相比,基于归一化逆序率(Normalized Inversion Rate,NIR)的筛选能够显著减少低延迟翻译崩溃。这说明,流式监督数据的对齐质量与难度控制,往往比简单增加轨迹数量更加关键。
长流式语音‑语音翻译是自动同传、跨国远程会议、跨境实时音视频交互场景的关键底座。但受限于数据成本、长序列稳定性、模态干扰等问题,开源端到端方案距离工业级商用仍存在不少差距。
SimulS2ST‑Omni 带来了几个值得关注的新路径:
- 在配对语音数据稀缺的条件下,借助多任务辅助监督,依然有机会训练出效果优秀的流式 S2ST 模型,为低资源语种、中小企业的语音同传研发提供新思路;
- 利用统一的文本‑声学码显式轨迹监督,替代独立的发射控制模块,简化流式系统链路,减少多模块串联带来的不稳定;
- Thinker‑Talker 解耦架构,把语义推理和声学生成进行分离,为后续语音大模型做流式语音生成提供架构参考。
我们正将语音翻译从“先听后翻再合成”的串行流程,推向一个“边听、边想、边译、边说”的同步智能新时代。
当然目前工作依旧存在可以继续拓展的空间,例如更多语种的泛化验证、进一步优化极低延迟条件下的翻译质量、对噪声真实录音的鲁棒性优化等,也值得后续研究者持续跟进。
