语音小管家
投机解码(Speculative Decoding)可以在不改变模型输出的前提下加速自回归解码。本文介绍我们在 ASR 和 TTS 两类语音任务上的投机解码实践:ASR方向,Qwen2-Audio-7B和 Qwen3-Omni-30B 使用投机解码分别实现了 1.73 倍和 1.60 倍的无损加速;TTS方向LLM-based TTS 系统在音质不下降的前提下,可以实现 2 倍左右的语音 token 生成速度提升。
⏩背 景
投机解码使用一个小的draft 模型每步并行猜测 k 个token,由原模型(verifier)做单次前向验证,猜对token越多加速越明显。贪心解码下输出与原模型完全一致,随机采样下通过拒绝采样保证输出分布不变,因此是无损的加速方法。本文用到的指标:
接受长度:每个解码步平均实际产出的 token 数(含 verifier 自己的 1 个 bonus token,上限k+1)。
位置 0 接受率:draft猜的第 1 个 token 被接受的比例,反映 draft 预测质量;
on-policy / off-policy 数据:off-policy指用数据集里的真实标注做训练标签;on-policy指让 verifier 自己生成标签。draft推理时预测的是 verifier 的输出,所以 on-policy 数据才是正确的训练目标。
本文涉及三种 draft 架构:
| 出草稿方式 | ||
⏩一、ASR
ASR 的输出是低熵的受约束文本:给定完整音频,每个词的预测是确定的,draft容易猜对,是投机解码的理想场景。我们在两个不同规模的模型上做了实验,serving框架均使用sglang,单张 Hopper GPU,greedy解码,报告的 WER/CER 均与 baseline 一致,验证了投机解码可以无损加速的特性。
1.1 Qwen2-Audio-7B
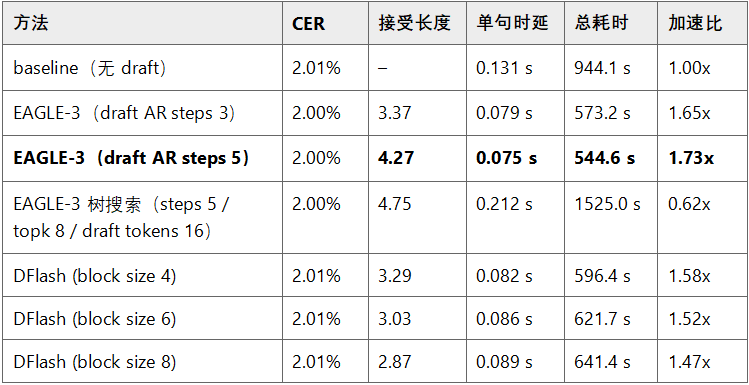
Target 模型为使用 AISHELL 训练集全量微调以后的 Qwen2-Audio-7B 模型,draft模型也使用 AISHELL 数据训练。在 AISHELL test set(7176条,约十小时音频)、并发 1 的结果如下:
结果分析:
7B 规模的 target 模型上,draft链可以适度加深:EAGLE-3 draft steps 5 将接受长度从 3.37 提升到4.27,加速比达到 1.73 倍。verifier前向开销小,多验证几个 token 的代价可以忽略;
EAGLE-3 树搜索(topk > 1)不适合ASR:转写任务分支度很低,top-1延续几乎总是正确的,树搜索的接受长度提升有限,而 verify 侧要打分的 token 数成倍增加,最终吞吐比 baseline 还差;
DFlash 同样可以实现加速,block size 4 效果最好:block 4 / 6 / 8 三个 checkpoint 的加速比分别为 1.58 / 1.52 / 1.47 倍。
1.2 Qwen3-Omni-30B
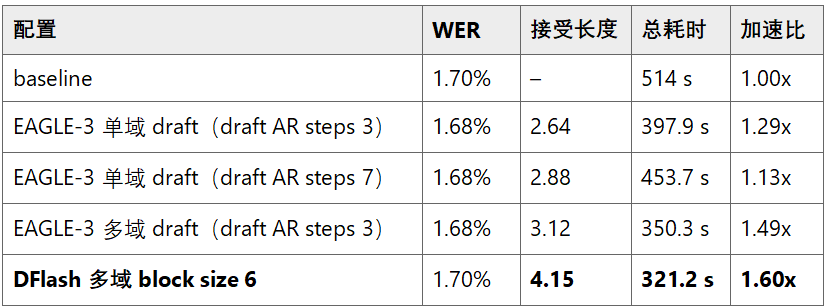
Target 换成Qwen/Qwen3-Omni-30B-A3B-Instruct,draft模型分别用两种数据进行了训练:先只用 LibriSpeech train-clean-100(28.5k条)训练了单域的EAGLE-3;之后把数据扩到 6 个英文 ASR 数据集共约 500k 条(GigaSpeech-s、AMI-ihm、SPGISpeech-S、Earnings22、LibriSpeechtrain.100、VoxPopuli-en),训练了多域的 EAGLE-3 和DFlash。测试集使用 LibriSpeech test-clean(2620条)、并发 1 的结果如下:
结果分析:
大 MoE target 上 draft 预测步数要适当减少:EAGLE-3用 steps 3 更优;加深到 steps 7 接受长度可以涨到2.88,但每多一步 draft 都会带来额外开销,整体反而变慢,加速比下降到 1.13 倍。
DFlash 方法加速效果在 Qwen3-Omni 实验上超过了EAGLE-3;
multi-domain 训练数据更好:LibriSpeech上接受长度从 2.64 提升到3.12;
1.3 并发数量与音频长度对投机解码加速的影响
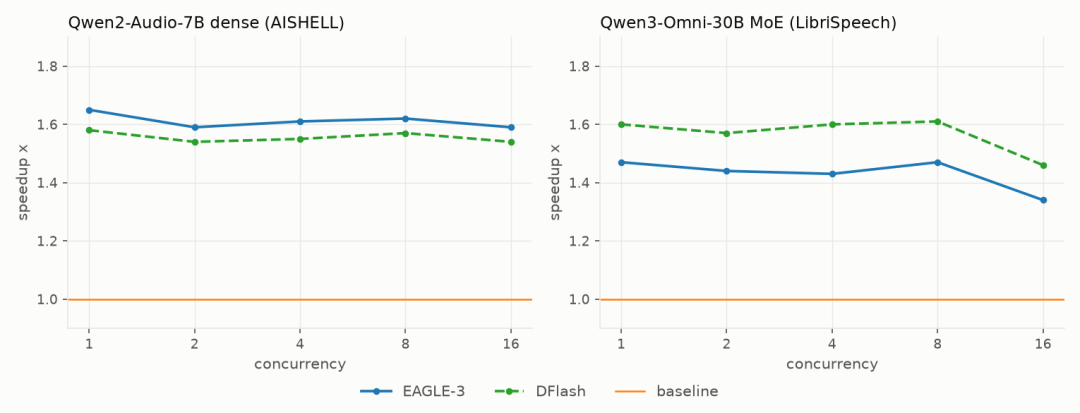
上面的结果都是并发 1 下测得的。实际部署中更关心两个问题:多路并发时投机解码是否还有收益(verify侧多出来的计算在高负载下是否会产生影响),以及加速比与音频长度的关系。本节对这两个变量做了分析。
ASR 加速比随并发的变化
加速比对并发不敏感:接受长度在并发 1 到 16 之间基本不变,说明 batching 不会影响 draft 预测质量。Qwen2-Audio-7B到并发 16 加速比仍保持 1.59–1.65 倍;Qwen3-Omni-30B在并发 16 时 GPU 开始从 launch-bound 转向throughput-bound,加速比从 1.60 回落到 1.46 倍,但加速效果仍然明显。
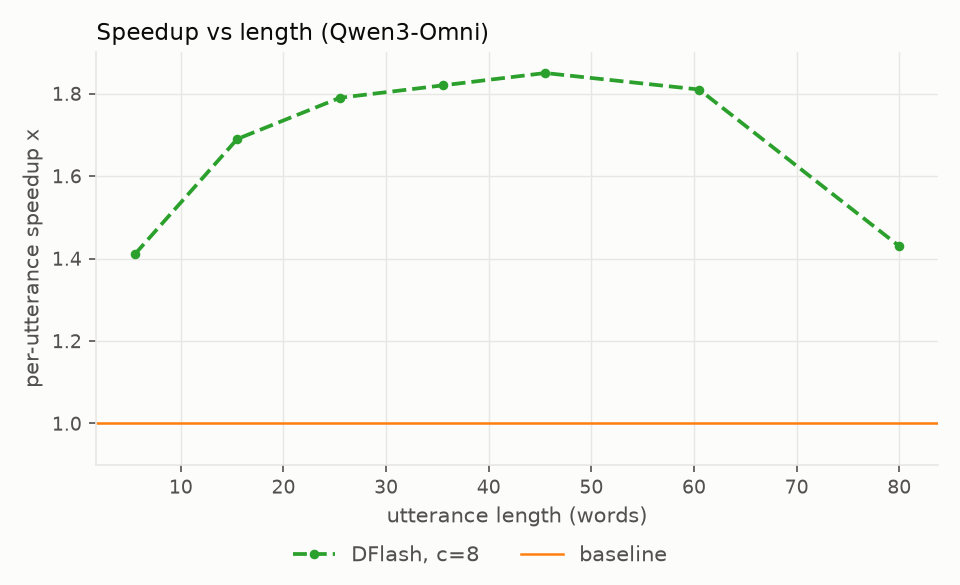
ASR 加速比随句长的变化
短句加速比偏低:speech encoder 以及 prefill 阶段的计算不被投机解码加速,短句中它们占比更大;长度约 20 词以上的句子,其解码的 decode time 开始占据主导地位,加速比稳定在 1.8 倍左右。但是,最右侧 70 词以上的长句加速比下降:因为接受长度本身开始下降,draft模型训练集多为较短音频,长音频上 draft 模型的预测效果下降。
1.4 Out of Domain 数据
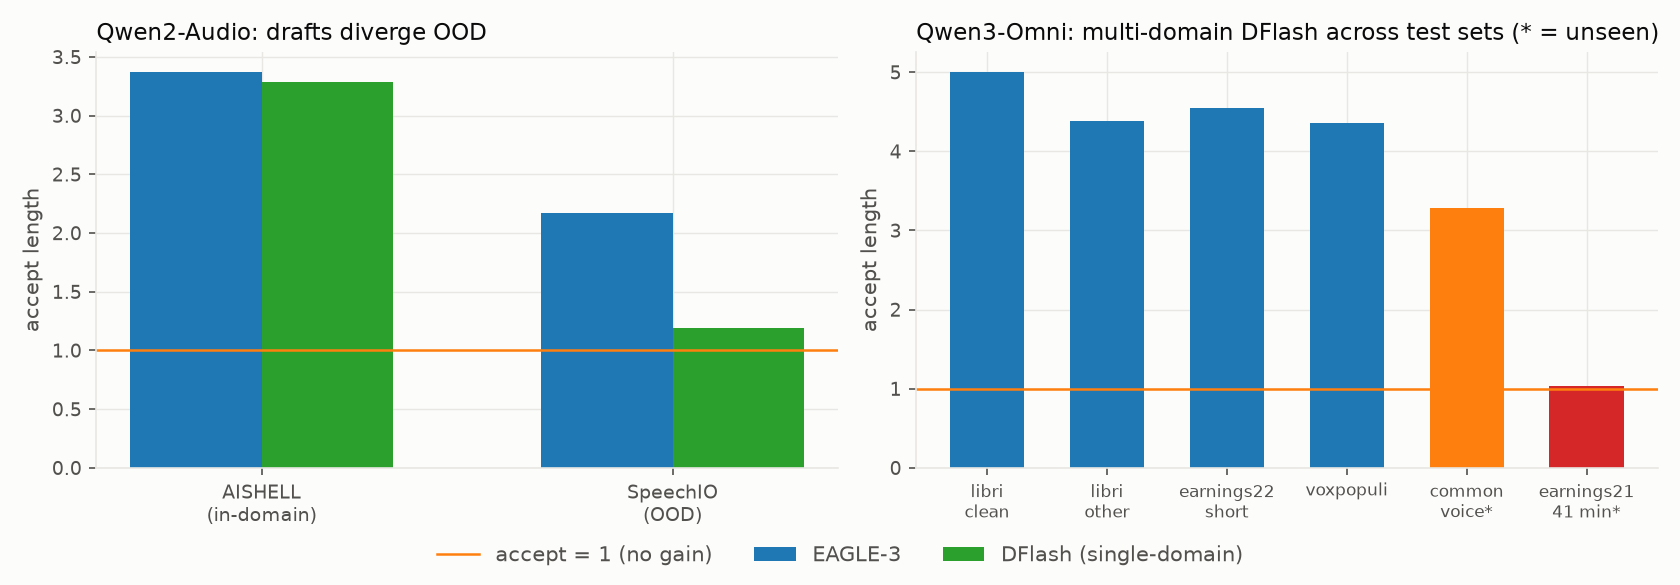
域外与跨测试集的接受长度对比
左图为 Qwen2-Audio 的域外测试:只用 AISHELL 数据训练的两个draft,在 OOD 的 SpeechIO 测试集(广播电视、长句)上预测准确率发生了下降。EAGLE-3接受长度从 3.37 下降到2.17,加速比大概为1.53倍,DFlash加速比则降到 0.93 倍,比 baseline 还慢(接受长度 3.29 → 1.19)。说明EAGLE-3相比 DFlash 方法,对分布偏移更鲁棒,在 OOD 的数据上表现更好.
右图说明这一问题可以通过混合多 domain 训练数据缓解:换成多域数据(6个 ASR 数据集共 500k 条)训练的 DFlash 模型,训练覆盖过的 domain 都稳定在 1.6 倍左右(接受长度4.3–5.0),完全没见过的 common_voice 测试集也保持 3.28 接受长度/ 1.36 倍加速。相同架构下,使用 multi-domain 训练数据比 single domain 的接受长度高 27%。
长音频场景(右图最后一列) draft 预测准确度很差:41分钟的 earnings21 音频(约 32k audio token)上,所有 draft 模型的接受长度都降到约1.0,推理速度比 baseline 还慢(0.85倍)。说明问题出在序列长度的分布偏移,需要在 draft 训练数据中加入长序列样本。
1.5 混合不同模态数据训练 draft 模型
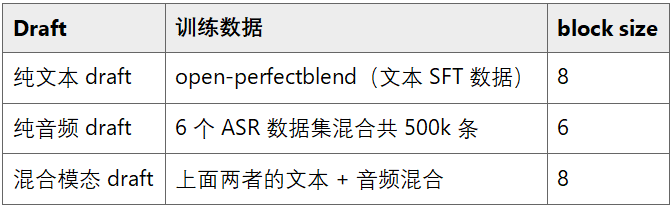
Qwen3-Omni 模型不只能处理音频任务。我们训练了三个不同数据配方的 DFlash draft,探究不同模态训练数据的混合对 draft 效果的影响。三个 draft 模型的训练配置如下(标签均为 on-policy regen):
在五个任务上的对比结果如下,表中数字为接受长度 / 加速比:
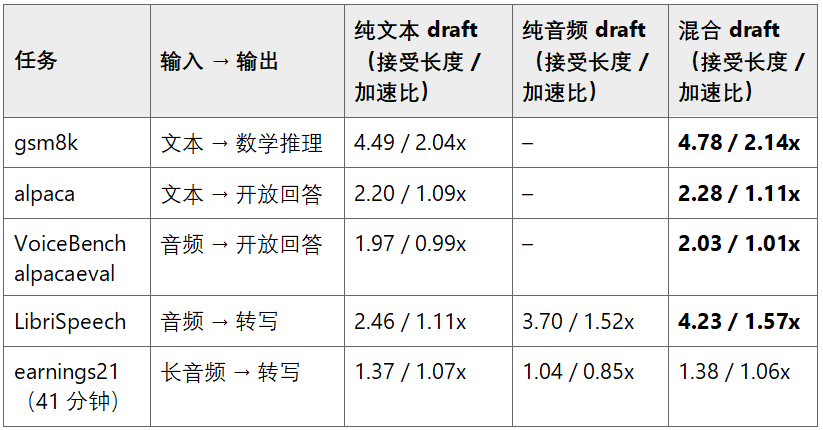
混合模态数据有帮助:五个任务上混合 draft 预测准确度全部最优,文本预测能力不下降的情况下,音频任务上也超过纯音频数据训练的draft;
接受长度由输出熵主导:低熵的受约束任务(数学推理接受长度约4.8、ASR约4.2)明显好于高熵的自由生成任务(开放回答约2.0–2.3)。
⏩二、TTS
TTS 方向的 target 模型选择了 CosyVoice2/3 的 0.5B LLM,serving使用vLLM。与 ASR 相比有两个不同:verifier小了一个数量级,draft的相对开销显著放大;推理时必须配合温度采样(temp 0.8 / top_p 0.95),repetition penalty 等,投机解码通过标准的 min(1, q/p) 拒绝采样保证输出分布不变。
2.1 CosyVoice2
我们在 CosyVoice2 上依次做了三组实验:draft架构的选择(自回归的 EAGLE-3 还是并行的 DFlash / DSpark)、训练数据的选择(真实录音的 speech token 还是 verifier 自己生成的 on-policy 数据)、以及数据规模的影响。主要实验如下:
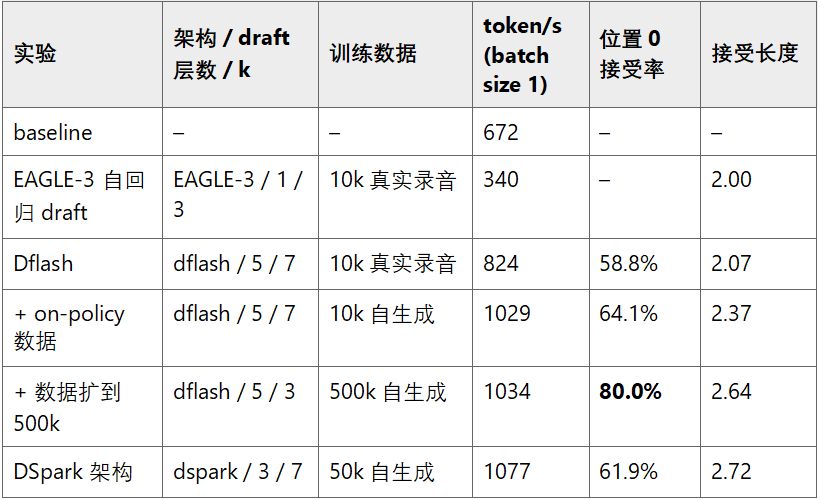
训练数据方面,我们最初直接用数据集里真实录音对应的 speech token 做训练标签,接受长度只有2.07;draft部署时要预测的是 verifier 的输出而不是真实录音,于是改为让 verifier 按部署采样参数自己生成标签(on-policyregen),接受长度提升到2.37;在此基础上继续扩大 on-policy 数据规模(10k→ 50k → 500k),接受率进一步提升。
结果分析:
0.5B verifier 上自回归 draft 无正收益:EAGLE-3每步的 draft 开销相较于target 模型不可忽略,最终速度只有 baseline 的一半,换成非自回归的并行 draft 后才有正收益。
on-policy 数据是必须的(吞吐+25%):draft需要学习的是 verifier 的输出分布,不是真实录音的分布;
DSpark 的 Markov 头使块内深位置的条件接受率不衰减(稳定在65–77%),接受长度相比 DFlash 或者 EAGLE-3 更长。
2.2 Seed-TTS 测试集结果
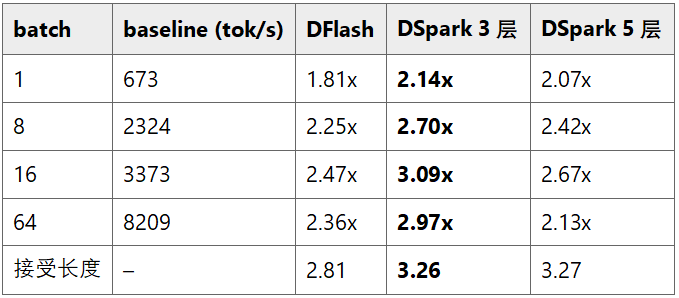
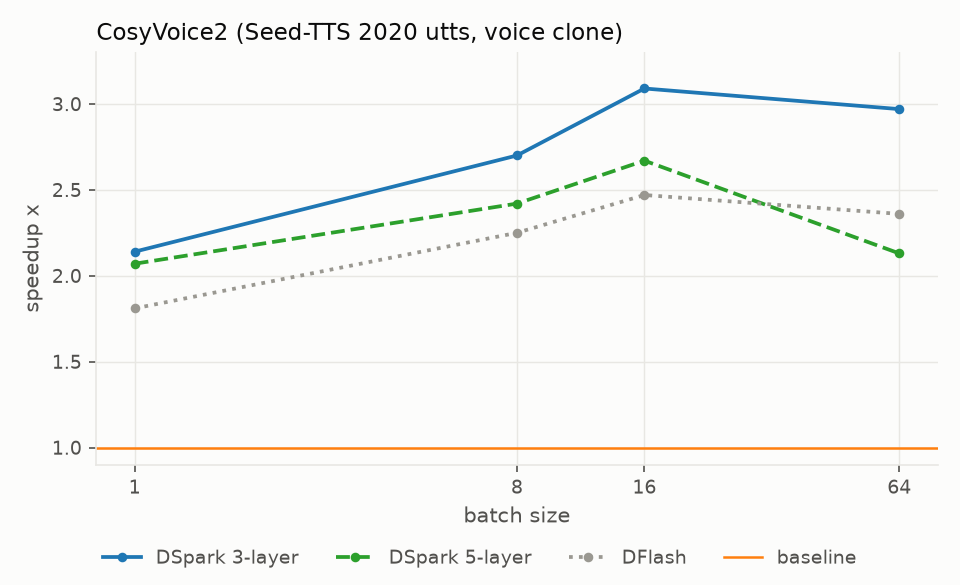
使用 Seed-TTS test_zh 全量 2020 条数据,我们在 batch size 1 到 64 下测试了三个 draft 的加速效果,其中 DSpark 3 层和 5 层是 draft 层数的消融(层数越多 draft 容量越大,但每步前向也越耗时):
CosyVoice2 加速比随 batch size 的变化
如上表所示,DSpark 3 层在所有 batch 下最优(2.1–3.1倍):5层版本接受长度与 3 层持平但 draft 前向更耗时,各 batch 下都会更慢。
2.3 CosyVoice3
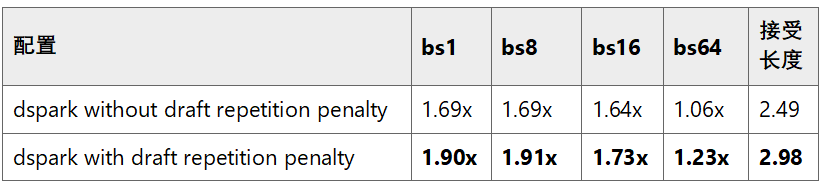
CosyVoice3 LLM 解码必须开启 repetition penalty 比如设置为1.1,否则生成音频有几率会失控。这给投机解码带来一个问题:拒绝采样比较的是 draft 分布 p 和 target 分布q,而 q 被 penalty 修改过、p没有。TTS输出中大量存在的重复 token 在 q 侧被压低,draft的预测频繁被拒绝,接受率下降。
我们的解法是在 vLLM 中对 draft logits 使用和 target 模型相同的采样函数。
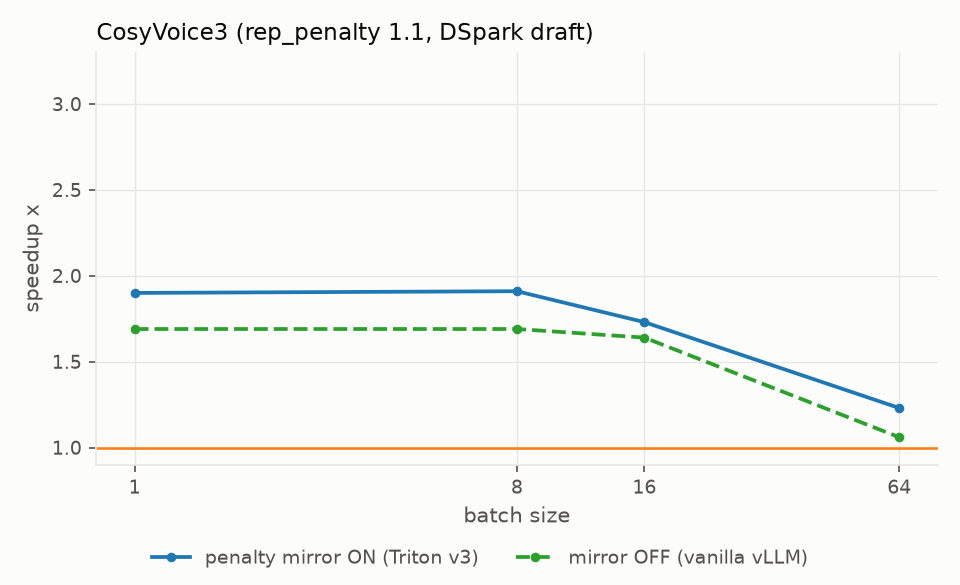
CosyVoice3 draft 模型 repetition penalty 对加速比的影响
对 draft 模型 logits 也使用 repetition penalty 后接受长度从 2.49 提升到2.98,各 batch 的加速比都有提高。
⏩复现流程
本文的 draft 模型、serving配置和端到端 benchmark 脚本都已整理到 github.com/yuekaizhang/SpeechSpec 仓库,包含三个部分:
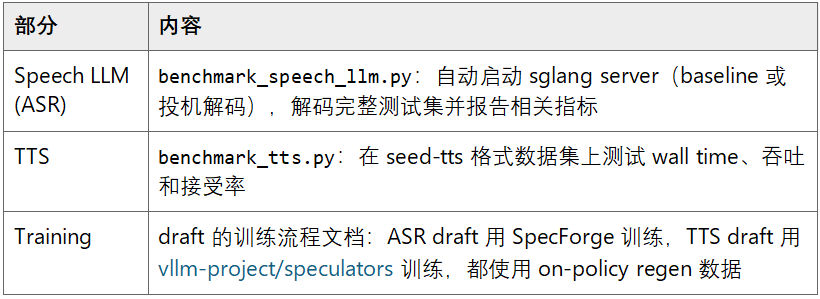
以 Qwen3-Omni 为例,复现本文结果只需要:
# EAGLE-3 投机解码python3 benchmark_speech_llm.py --target-model Qwen/Qwen3-Omni-30B-A3B-Instruct \--draft-model yuekai/qwen3_omni_30b_a3b_instruct_eagle3_audio \--dataset librispeech --output-dir results/omni_eagle3
⏩总 结
本文介绍了我们在 ASR 和 TTS 两类任务上,使用投机解码对推理进行加速的实验结果,欢迎关注和交流。