
 语音小管家
多语言语音识别在向低资源语言扩展时,通常需要按顺序适配多种新语言,如何在学习新语言的同时不损害已有语言的性能至关重要。近期,清华大学语音与音频技术实验室(SATLab)提出了一种融合语言均衡梯度投影与经验回放的统一持续学习方法(UGP),利用语言均衡的参考梯度来抑制主导语言偏差,可以有效缓解多语言顺序适配中的灾难性遗忘。该论文已被 Interspeech 2026 录用。
Z. Ren, G. Lin, Y. Ai, K. Tan, and W.-Q. Zhang, "Unified Gradient Projection: Language-Balanced Continual Learning for Multilingual Low-Resource ASR," in Proc. INTERSPEECH, 2026. arXiv:2607.11163.
论文链接:https://arxiv.org/pdf/2607.11163
背景介绍
以 Whisper 为代表的大规模预训练语音识别模型在多语言场景下展现出了强大的泛化能力,但在众多低资源语言上的识别性能仍有明显不足。通过微调来适配低资源语言是常见的解决思路,然而当需要顺序适配多种语言时,模型在学习新语言的过程中往往会破坏已有语言的关键表征,导致之前学会的语言性能大幅下降,这一现象被称为灾难性遗忘。
持续学习(Continual Learning)旨在解决上述可塑性与稳定性之间的矛盾,现有方法大致分为三类:参数隔离方法(如 LoRA)通过模块化参数避免冲突;正则化方法(如 EWC)通过惩罚重要参数的变化来保护旧知识;回放方法(如经验回放 ER)通过混合历史数据进行联合训练。其中,基于梯度投影的方法通过约束参数更新方向来减少跨任务干扰,但在多语言场景下面临一个关键挑战:回放缓冲区中各语言的数据量往往不均衡,参考梯度容易被高资源语言主导,导致低资源语言更容易被遗忘。
问题分析与方法提出
研究团队发现,现有梯度投影方法(如A-GEM)在多语言语音识别场景中表现不稳定,根本原因在于参考梯度估计存在主导语言偏差:当从历史数据中随机采样计算参考梯度时,数据量更多的语言会对参考梯度产生更大的影响,使得梯度投影对高资源语言更为保护,而低资源语言仍然容易被遗忘。
为此,研究团队提出了统一梯度投影(UGP)方法,核心设计包含两个层面:
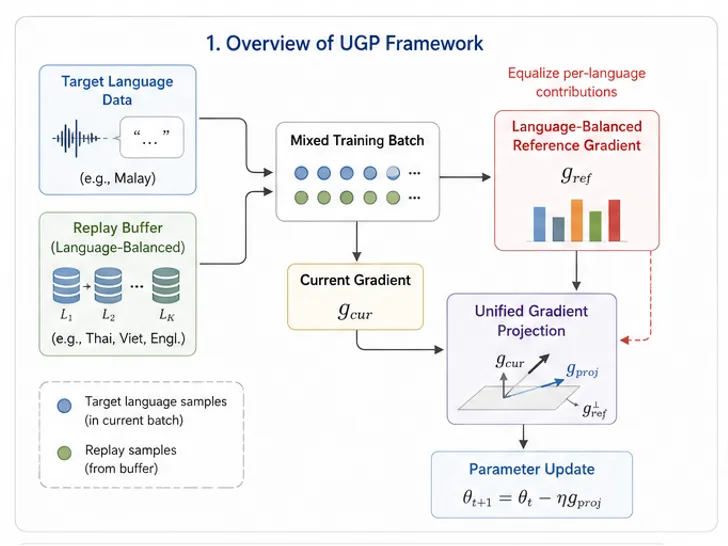
梯度层面——语言均衡投影。在模型每一步训练迭代中,UGP 会从回放缓冲区为各类历史语种均匀抽取等量样本,据此计算兼顾所有语种、分布均衡的全局参考梯度。借助批次内均等采样策略,各历史语种在梯度投影约束中能够获得同等权重贡献,避免训练过程偏向数据体量更大的语种。若当前语言的训练梯度与参考梯度产生冲突(即二者内积为负),算法会将当前梯度投影至参考梯度的正交补空间,剔除会损害历史语种性能的无效更新分量。
数据层面——经验回放融合。 在梯度投影的基础上,UGP 将经验回放(ER)深度整合为统一框架。ER 通过混合当前语言与历史语言的数据来锚定参数更新,防止表征漂移;同时,这种多语言联合训练机制还能促进跨语言的正向知识迁移。
两种机制形成互补,实现了稳定性与可塑性的同步提升。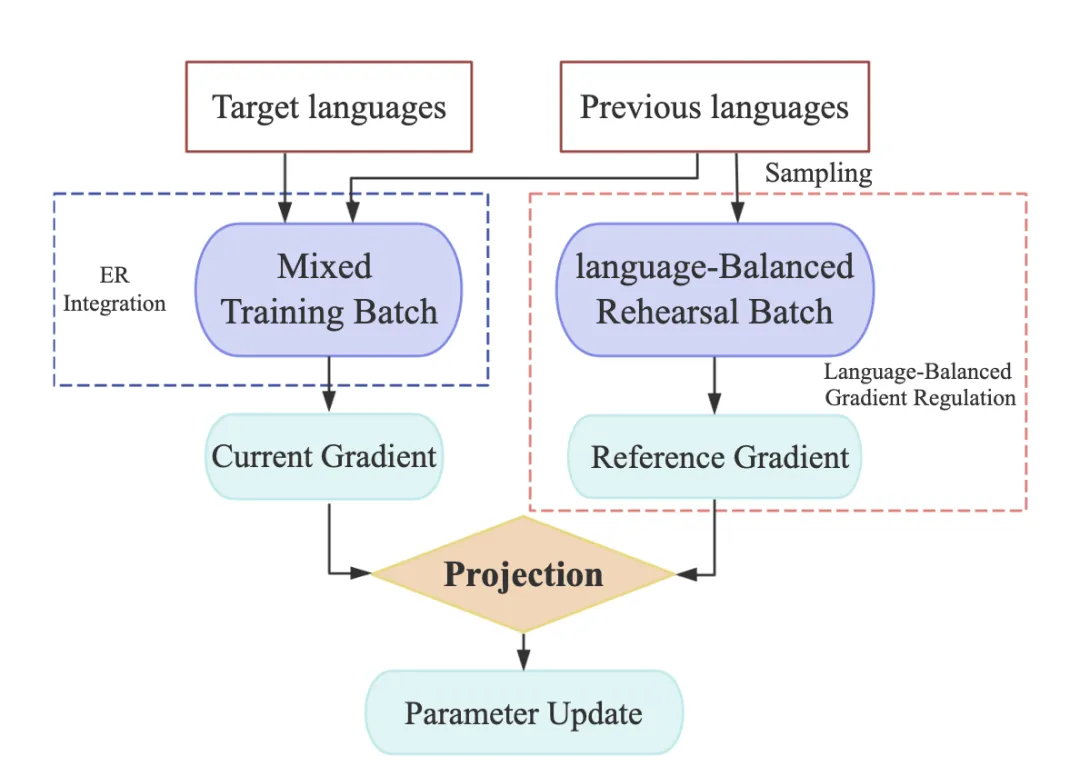 实验结果
研究团队在 FLEURS 和 CommonVoice 数据集上,针对东南亚、非洲、中东等多个低资源语言组,在Whisper-small、medium 和 large-v3三种规模上进行了系统评估。
跨尺度核心结果。 在核心实验集上,UGP 在所有规模下均取得了最优的整体性能(AWER)。在 Whisper-large-v3 上,UGP 将平均遗忘率(FWER)降低至 0.04%,接近零遗忘,同时目标语言错误率(TWER)达到 12.91%,整体平均错误率(AWER)为 9.80%,显著优于标准经验回放(11.81%)和 A-GEM(19.32%)。值得注意的是,UGP 的优势随模型容量的增大而更加显著:在 Whisper-medium 上遗忘率为 10.05%,到 large-v3 直接降至 0.04%,表明更大的表征空间为 UGP 的梯度解耦提供了更充裕的正交子空间。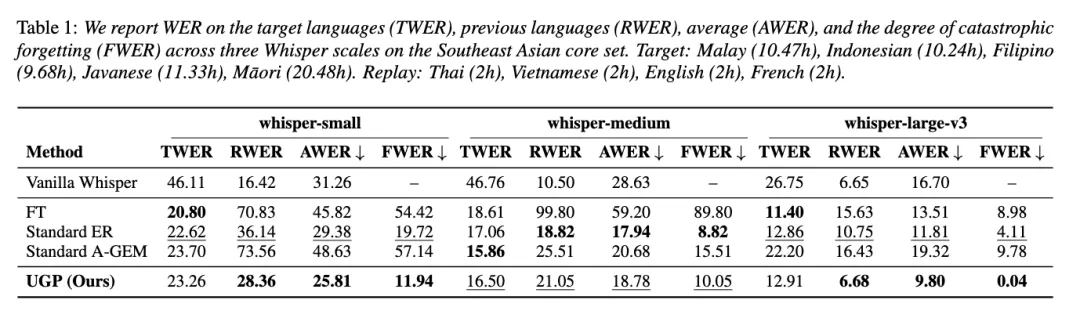
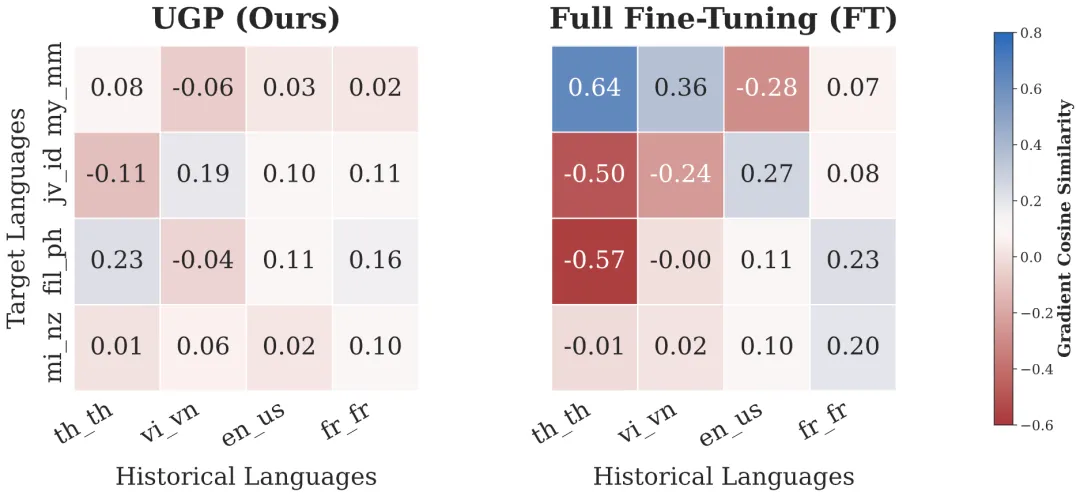
消融实验进一步验证了各组件的贡献:仅使用梯度投影或仅使用经验回放,遗忘率均高于完整UGP;两者结合才能实现稳定性与可塑性的同步提升。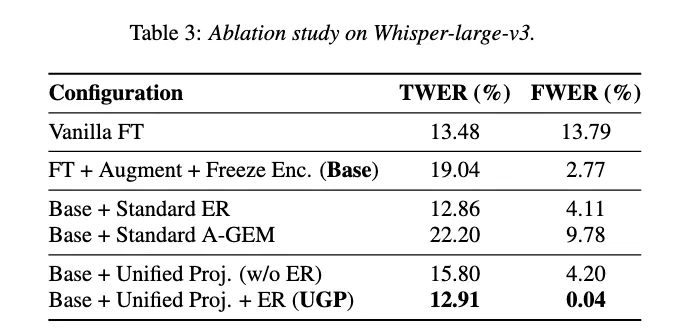 梯度余弦相似度分析也表明,UGP在收敛后使不同语言的梯度趋向正交,从结构上减少了跨语言干扰,而标准微调的模型则存在明显的梯度冲突。
在极端数据稀缺场景(每语言仅5小时数据)下,UGP同样保持了最低的遗忘率,展现出良好的鲁棒性。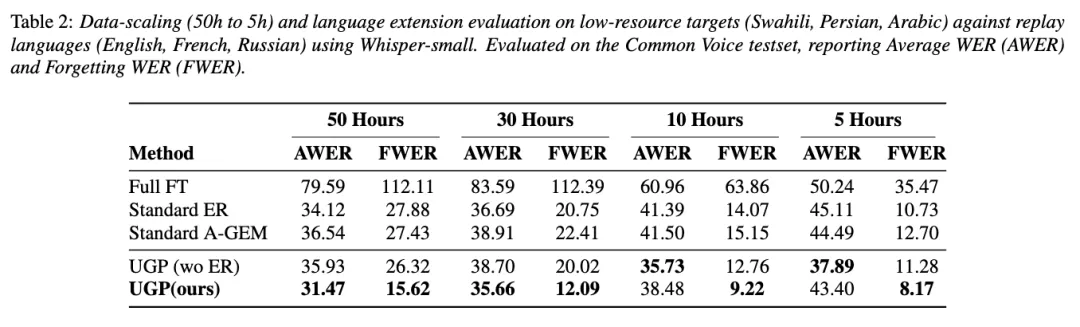
结 论
本文针对多语言低资源语音识别中的灾难性遗忘问题,提出了统一梯度投影(UGP)方法。通过语言均衡的参考梯度构建与经验回放的深度融合,UGP有效克服了现有方法中主导语言偏差的问题,在Whisper-large-v3上实现了接近零的平均遗忘率,为大规模基础模型的多语言持续适配提供了高效可行的解决方案。
第一作者信息
任子昂
清华大学语音与音频技术实验室(SATLab)实习生,北京理工大学四年级本科生。
林国栋
清华大学语音与音频技术实验室(SATLab)三年级硕士生,主要研究方向为多语种语音识别。
Interspeech 2026丨统一梯度投影:面向多语言低资源语音识别的语言均衡持续学习
评论 0

文明发言,友善讨论
还没有评论,发表你的看法,来抢沙发~