
 语音小管家
MOSS 开源 MOSS-Transcribe-Diarize-0.9B。这是一个专为真实复杂语音场景打造的端到端多说话人语音转录模型。它不需要像传统方案一样,将 ASR、Speaker Diarization、Alignment 拆成多个模块依次处理;也不需要把一场几十分钟甚至一个多小时的会议切成大量片段,再进行复杂的拼接和后处理。
一个 0.9B 模型,直接从整段音频生成带有时间戳和说话人标签的结构化转写结果。
更重要的是,在 AISHELL-4 等多说话人会议 benchmark 上,MOSS-Transcribe-Diarize-0.9B 在多个核心指标上取得领先表现。
⏩0.9B,能做什么?
真实世界里的语音,从来不是干净、规整的实验室数据。一场会议里,可能有十几个人轮流发言;有人说到一半突然被打断;两个人同时说话;有人距离麦克风很远;背景里还有空调声、键盘声和回声。
对于传统 ASR 来说,“听清楚说了什么”已经不是一件简单的事情。而多说话人转录还需要额外解决两个问题:
谁说的?
什么时候说的?
如果音频从几分钟进一步扩展到几十分钟甚至一个小时,问题会更加复杂。模型需要在很长的上下文中持续追踪不同说话人的身份,同时保证文本和时间戳不会随着音频长度增加而逐渐漂移。这也是为什么长期以来,多说话人语音转录更多被当成一个复杂的系统工程问题。但这一次,MOSS 选择了另一条路线。
用一个 0.9B 模型,把这三个问题统一起来。
MOSS-Transcribe-Diarize-0.9B 支持:
语音转写
说话人识别
时间戳预测
重叠语音处理
热词增强
并且可以在一次生成过程中直接输出结构化结果:
[0.11] [S01] Good morning! [1.03]
[1.11] [S02] Morning, guys! [1.34]
从音频到最终结果,不需要再经过多个模型之间的结果传递。
⏩超长语音,不切片也能直接转
长音频转录最麻烦的地方,从来不只是“让模型听得更久”。真正困难的是:让模型在听了很久之后,依然记得前面发生了什么。传统长音频 ASR 通常需要将音频切成多个 chunk。例如,一场 60 分钟的会议可能被拆成几十甚至上百个片段,分别进行识别,再通过后处理将结果重新拼接起来。
这样做虽然工程上成熟,但也会带来一系列问题:
chunk 边界处出现文本断裂;同一个说话人在不同片段中被分配不同 ID;时间戳在拼接过程中产生偏移;上下文信息无法跨 chunk 传递;长距离的说话人关系难以保持。
切得越碎,系统越容易失去全局信息。MOSS-Transcribe-Diarize-0.9B 从模型设计上直接针对这一问题进行了优化。模型拥有 128K token 上下文窗口,能够支持最长约 90 分钟的连续音频输入。也就是说:一场完整会议,可以直接作为一次输入。
不需要切片。
不需要拼接。
不需要额外的说话人 ID 对齐。
不需要针对每一个 chunk 做复杂的后处理。
模型可以在统一上下文中持续建模:谁在说话 → 说了什么 → 什么时候说 → 接下来是谁说
这对于会议、访谈、播客等具有连续对话结构的场景尤其重要。
⏩为什么 0.9B 也能做到?
如果只看参数规模,0.9B 并不是一个“大模型”。但多说话人转录的关键,并不只是参数量。更重要的是,模型到底被训练成了什么。
MOSS-Transcribe-Diarize-0.9B 采用:Whisper-Medium 配置音频编码器 + Qwen3-0.6B 风格 Causal Decoder的多模态架构。其中,音频编码器负责从长时、多说话人语音中提取声学信息。随后,Causal Decoder 不再只生成普通文本,而是直接生成包含:文本 + 时间戳 + Speaker ID的结构化序列。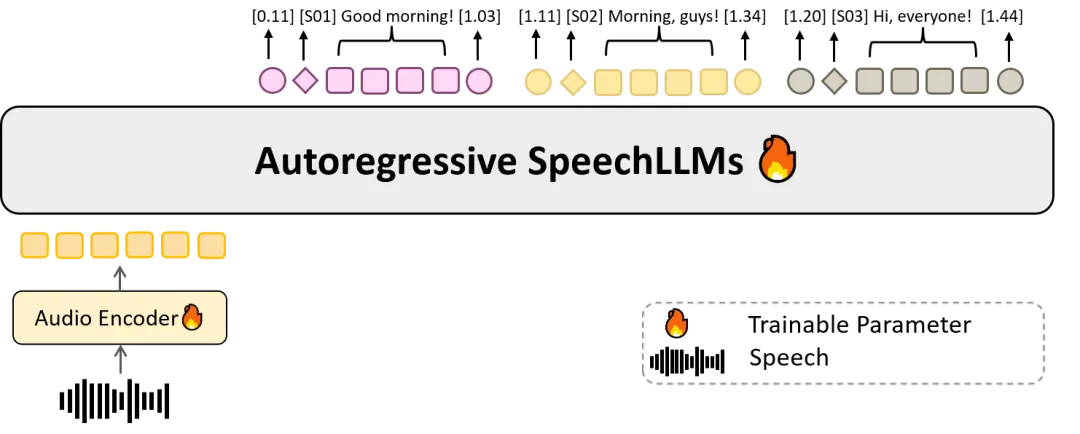 这意味着模型训练的目标不再只是:“这段音频说了什么?”
而是:“在什么时间,由哪个说话人,说了什么?”最终,转写、说话人归属和时间信息被统一成一个自回归生成任务。
⏩Benchmark:0.9B 也可以做到领先
架构最终还是需要 benchmark 来证明。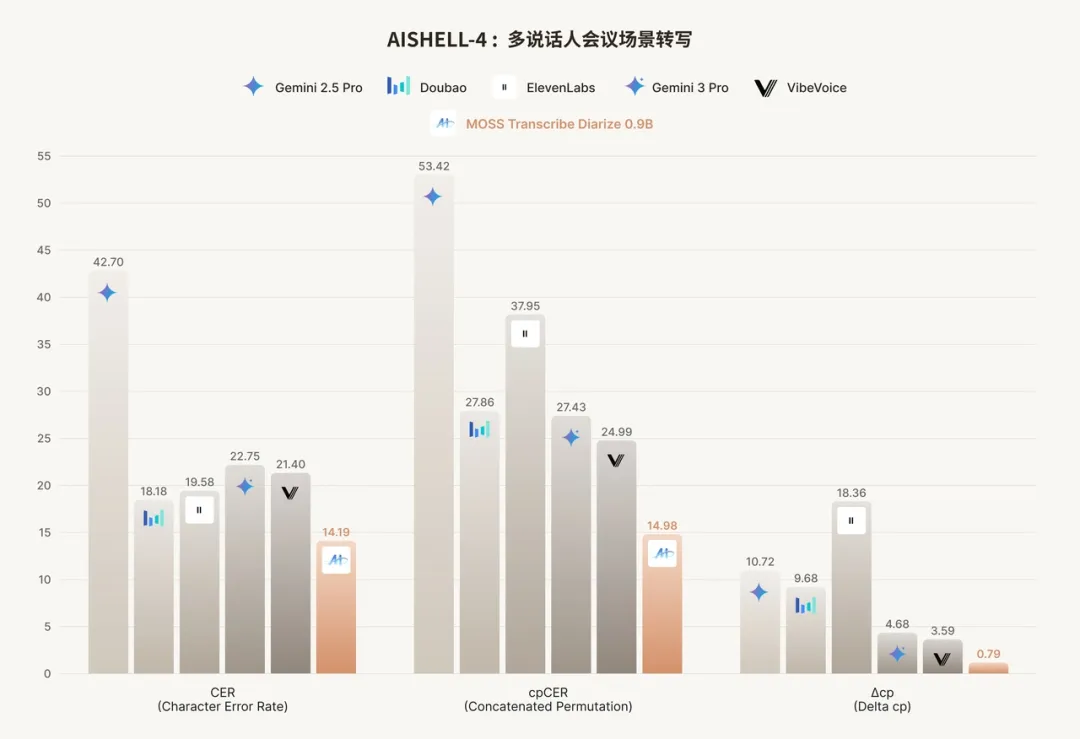 在 AISHELL-4 多说话人会议转录 benchmark 上,MOSS-Transcribe-Diarize-0.9B 在多个核心指标上取得领先表现。其中:
cpCER:14.98%
Δcp:0.79
其中 cpCER 用于衡量多说话人场景下的整体转录错误,而 Δcp 则进一步反映说话人归属随上下文变化的稳定程度。尤其值得关注的是:
Δcp 仅为 0.79。
这意味着随着会议时间不断增加,模型依然能够较好地保持说话人身份的一致性。对于多说话人长音频来说,这一点往往比单纯降低几个百分点的 CER 更重要。因为真实会议最终需要的不是一段“看起来正确”的文字。而是一份真正能够使用的会议记录:
谁,在什么时候,说了什么。
⏩不只是准确,更要足够快
对于实际部署而言,模型准确率只是第一步。如果一个模型需要大量 GPU、推理速度又很慢,那么它依然很难真正进入生产环境。MOSS-Transcribe-Diarize-0.9B 在轻量化方面同样进行了重点优化。在 NVIDIA RTX 4090 单并发环境下:
生成速度最高约 100 token/s
RTF 约 0.017
5–10 分钟的音频可以在约 30 秒内完成转录。这意味着对于大量企业会议、访谈、播客以及客服录音场景,模型不仅能够完成复杂的多说话人理解,同时也具备较低的部署成本。
0.9B,不只是“小”。它更意味着:更低的显存需求、更快的推理速度,以及更容易落地的部署成本。
⏩热词增强:让模型听懂你的“专业语言”
通用 ASR 模型经常会遇到一个非常现实的问题:普通词汇识别得很好,但一旦进入企业真实业务场景,就开始出现大量专有名词错误。例如:
产品型号;
公司名称;
项目代号;
人名;
地名;
技术缩写;
行业专业术语。
对于会议纪要和客服质检来说,一个产品型号识别错误,可能比普通词汇识别错误更加严重。因此,MOSS-Transcribe-Diarize-0.9B 支持热词增强能力。
用户可以根据业务场景提前配置关键词,让模型在识别阶段提高对目标词汇的关注。例如企业可以提前加入:产品型号 + 客户名称 + 项目名称 + 技术术语
这样最终得到的不只是:“会议里说了什么?”
还可以进一步实现:“哪个人在什么时间讨论了哪个项目、哪个产品,以及具体讨论了什么?”这让多说话人 ASR 从单纯的“语音转文字”,进一步走向真正的结构化语音理解。
⏩从会议到客服,多说话人转录正在成为基础能力
MOSS-Transcribe-Diarize-0.9B 并不是只针对某一个 benchmark。它真正面向的是大量真实世界中的复杂语音场景。
企业会议:自动生成带有说话人和时间戳的会议纪要。
客服质检:快速定位客服与客户的具体对话内容,并追踪关键业务节点。
访谈整理:自动区分采访者与受访者,减少人工整理成本。
播客与内容生产:直接获得带 Speaker ID 和时间戳的结构化文本。
企业知识库:将会议、访谈、沟通记录进一步转化为可检索、可分析的知识资产。
这些场景有一个共同特点:用户真正需要的,从来不只是一段文字。而是:谁 + 什么时候 + 说了什么。
⏩MOSS,不止一个模型
这次,同步更新了 MOSS 的多说话人语音转录产品矩阵。除了本次开源的:
MOSS-Transcribe-Diarize-0.9B
也同步更新了旗舰模型:
MOSS-Transcribe-Diarize Pro
Pro 版本基于更大规模模型能力,在说话人区分、上下文理解、转写一致性以及多语言能力方面进一步增强。针对企业级应用,我们同时提供 API 服务,可以直接用于:
企业会议转录;
客服质检;
访谈分析;
内容生产;
企业知识库构建。
与此同时,还推出了面向复杂英语场景的:
MOSS-Transcribe
针对标准英语、多样口音、低声和耳语等真实语音场景进行专项优化。在 OPENASR Leaderboard 上,MOSS-Transcribe 已取得开源模型领先成绩。
从中文多说话人会议,到全球英语 ASR,再到端到端长音频转录,MOSS 正在构建完整的语音基础模型能力。
⏩相关地址
项目主页:https://github.com/OpenMOSS/MOSS-Transcribe-Diarize
在线 Demo:https://moss-transcribe-diarize-demo.mosi.cn/
技术报告:http://arxiv.org/abs/2601.01554
Hugging Face:https://huggingface.co/OpenMOSS-Team/MOSS-Transcribe-Diarize
AtomGit:https://ai.atomgit.com/OpenMOSS/MOSS-Transcribe-Diarize
SGLang-Omni:https://github.com/sgl-project/sglang-omni
vLLM:https://github.com/vllm-project/vllm
MLX-audio:https://github.com/Blaizzy/mlx-audio
