以下文章来源于乐百一家

论文题目:A Survey of Full-Duplex Spoken Dialogue Systems: Architectural Hierarchy, Interaction Ontology, and Decision State Machine

作者:Jingyu Lu、Yuhan Wang、Jianming Luo、Yifu Chen、Tianle Liang 等

作者单位:浙江大学、阿里通义千问、腾讯混元、字节跳动

论文版本:https://arxiv.org/abs/2606.19453v1
项目地址:https://github.com/DuplexLM/DuplexSurvey

交互演示:https://duplexlm.github.io/DuplexLM/demo.html

在上一节里讲了全双工决策在哪里做的问题,并且提出了L0–L3 架构层级,没看过的小伙伴点这里:万字长文详解全双工口语对话系统综述:架构层级、交互本体与决策状态机,下面接着讲剩下的部分:

01、T × I × R Interaction Ontology:不是所有重叠语音都叫“打断”
架构层级告诉我们“决策在哪”,但还没有告诉我们“系统应该处理什么”。
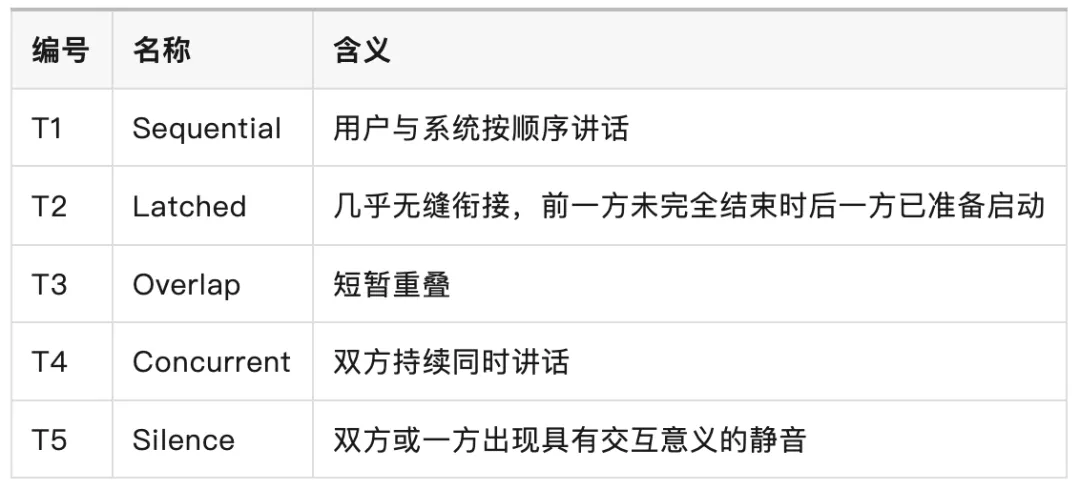
论文用三个相互正交的轴定义交互。
5.1 T:Temporal,时间关系
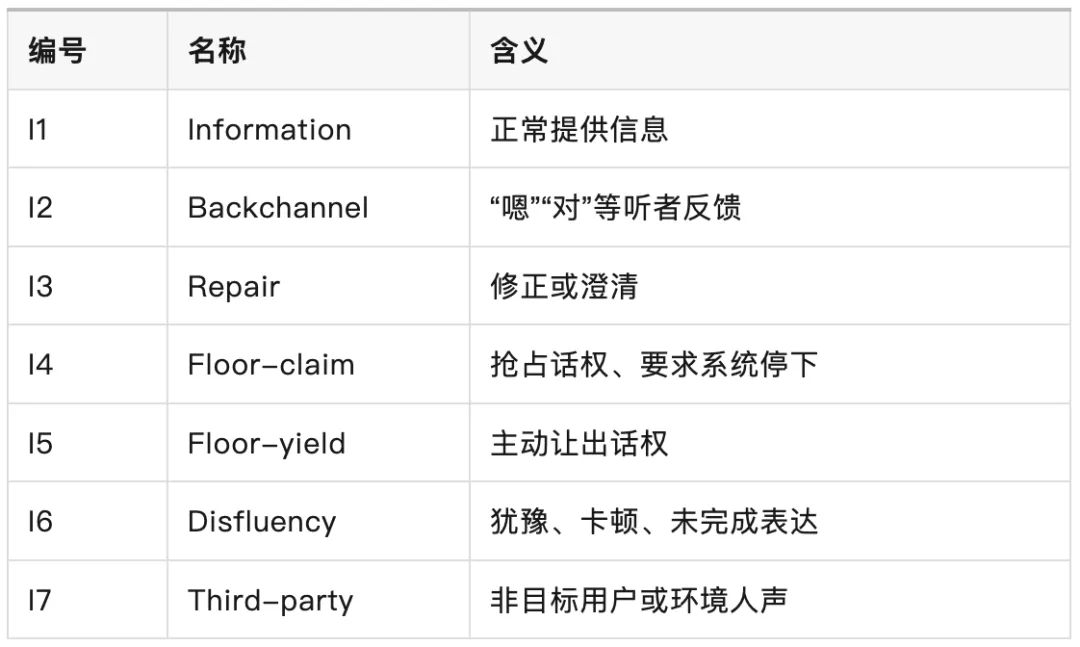
5.2 I:Intent,用户意图
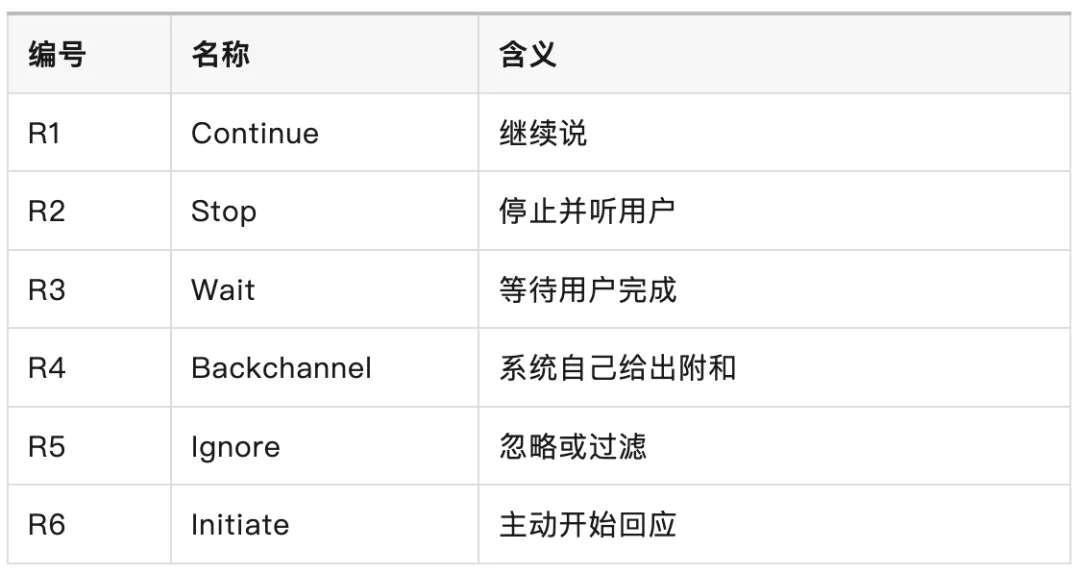
5.3 R:Response,系统动作
理论组合是:

5 × 7 × 6 = 210 个名义单元

但很多组合不具备物理或语用意义。例如系统本来没有说话时,R1 Continue 就没有意义。所以真正需要关心的是几十个有效交互单元。
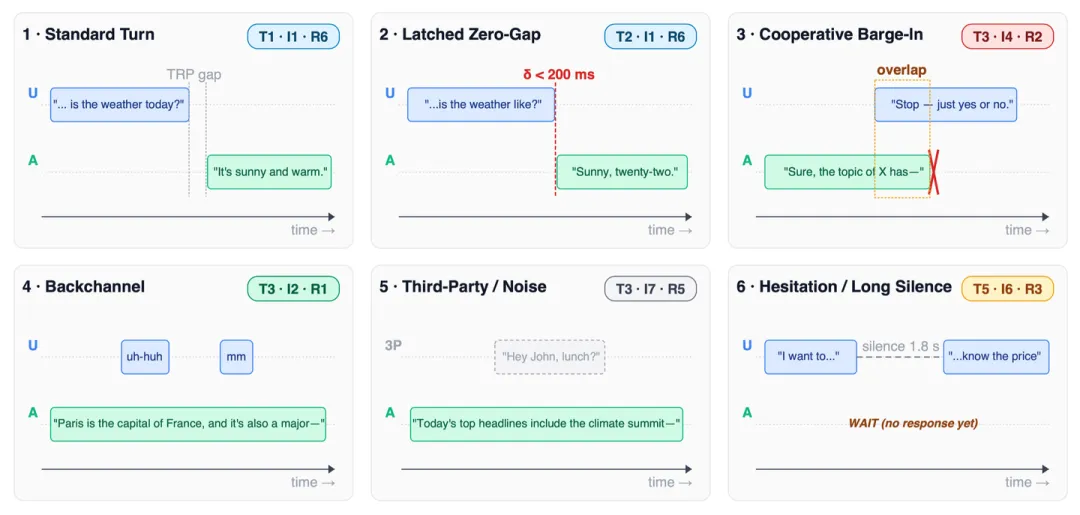
5.4 Six Acid-Test Cells:最能区分真假全双工的六个场景
场景一:Standard Turn (T1, I1, R6)
用户正常说完,系统在 Transition-Relevance Place 开始回应,通常间隔约 200~600 ms。
这是所有系统都会的基线。如果一个系统只能完成这一类,它本质上仍是传统半双工。
场景二:Latched Zero-Gap (T2, I1, R6)
用户刚说完,系统几乎零间隔启动。
要做到这一点,系统不能等用户完全静音后才开始所有计算,而要:
  • 提前做 Semantic EoT Prediction;
  • Speculative Generation;
  • 甚至提前准备 TTS 首 Chunk。
论文认为 Moshi、MinMo、FireRedChat 可以一定程度到达这一场景;传统级联系统因为先等静音再判 EoT,通常做不到真正零间隔。
场景三:Cooperative Barge-In (T3, I4, R2)
助手正在说话,用户明确要求拿回话权。
为了让交互感觉自然,助手通常应在约 200 ms 内停止。
这也是 GPT-4o 演示最让人印象深刻的场景。但“听到声音就停”并不等于正确 Barge-in,因为系统还必须避免把附和当成打断。
固定 Chunk 设计或关键词触发系统可能在当前 Chunk 中继续生成,因此不满足严格 Causal Influence Criterion。
场景四:Backchannel During System Speech (T3, I2, R1)
用户说:
  • “嗯嗯”;
  • “对”;
  • “我明白”;
  • “然后呢”。
这通常表示“我在听,请继续”,而不是“你停下,我来说”。系统应该继续,必要时调整韵律,但不能直接闭嘴。
这是用户反馈中最常见的失败之一。Naïve VAD 只看到“用户通道有能量”,无法理解意图,因此会在句子中间被频繁切断。
区分 I2 与 I4,必须从单纯声学检测走向 Intent Classification。
场景五:Third-Party / Noise (T3, I7, R5)
系统说话时,旁边的人说了一句话,或者电视里传来人声。正确动作是忽略,而不是中断当前回答或把背景语音当新指令。
可用机制包括:
  • pVAD;
  • Speaker Embedding;
  • LLM-level Relevance Gate;
  • 所谓 Semantic Denoise。
FireRedChat、Ant Group 与 Alibaba L0 管线都明确瞄准这一问题。
场景六:Hesitation with Long Silence (T5, I6, R3)
用户说:

“我想订一张……嗯……下周三去上海的票。”

中间虽然有较长静音,但句法和语义都表明还没说完。系统应该等待。
固定 500 ms 左右 VAD 阈值会提前触发。要处理好,通常需要:
  • Semantic EoT;
  • LLM-conditioned Predictor;
  • Prosody + Partial Transcript 联合判断。
5.5 为什么这套本体有用?
TIR 可以同时用于三件事:
  • 作为训练数据标签:不再只统计“有多少小时双通道语音”,而要统计每个单元有多少样本。
  • 作为评测切片:可以明确报告:
    • (T3, I4, R2) Stop Latency;

    • (T3, I2, R1) Backchannel Accuracy;

    • (T3, I7, R5) Third-party Rejection。

  • 作为系统故障描述:“模型不是总能全双工”几乎没有诊断价值;“模型在 Backchannel Cell 上把 I2 错分成 I4”则可以直接指导修复。

02、Decision State Machine:五个状态、十一条转移,把对话变成可测轨迹

L0–L3 是静态架构分类,TIR 是交互事件分类。FSM 进一步回答:系统每一刻在做什么?
6.1 五种状态
  • IDLE:用户和系统都没有产生语音。
  • LISTEN:只有用户说话,系统静默编码。
  • SPEAK:只有系统说话,用户通道无有效语音或低于噪声阈值。
  • WAIT:系统认为用户还没完成,暂停自身行动并监控用户是否继续。WAIT 很重要,因为传统两状态 LISTEN / SPEAK 无法区分“正在听用户说”和“用户暂时停了,但系统主动选择继续等待”。
  • DUAL:双方音频都活跃,而且系统正在进行有效的 Mutual Integration。DUAL 不只是“麦克风里同时有两路声音”。如果系统完全忽略用户流,或者只是延迟到 Chunk 末端才处理,就不能算稳定有效的 DUAL。
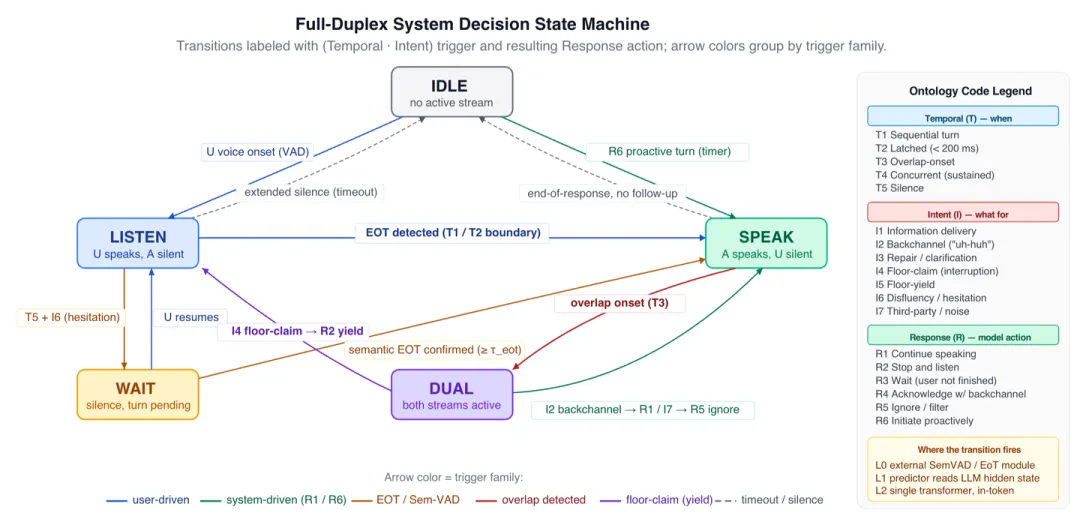
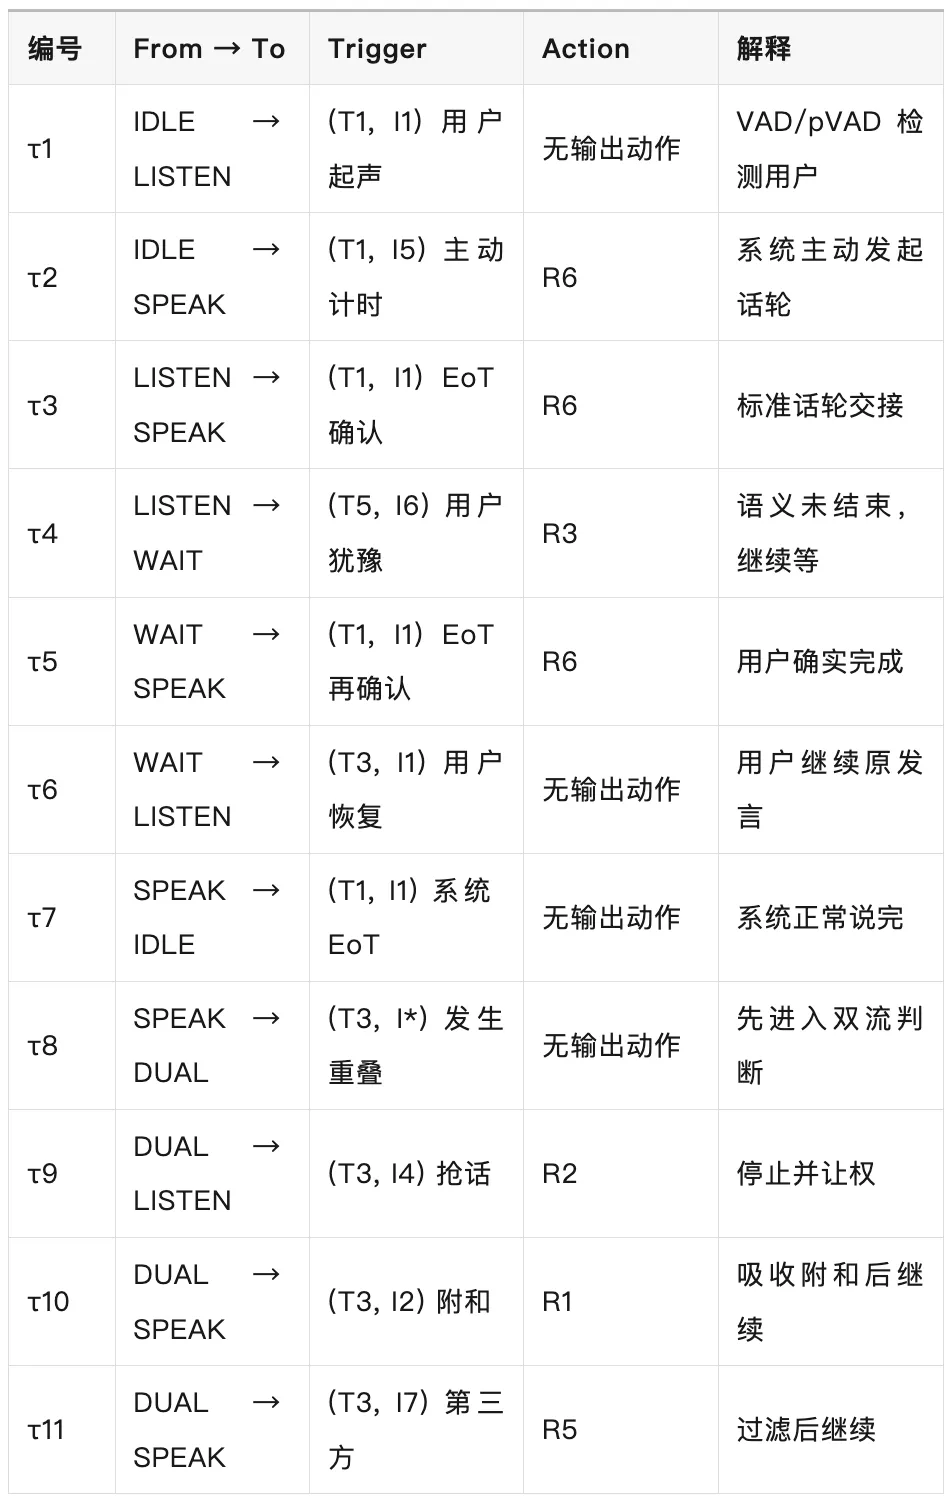
6.2 11 条状态转移
其中 τ1、τ6、τ7、τ8 是 Perceptual Transition:系统只更新状态,不一定立即输出动作。
6.3 三类转移
  • Onset Transitions:τ1:用户开始;τ2:系统主动开始。
  • Turn-Handoff Transitions:τ3~τ7,在单说话人状态间转移,重点涉及 EoT、Silence、Hesitation。
  • Overlap Transitions:τ8~τ11,真正区分全双工与半双工。
一个简单半双工系统面对重叠时,常把 τ8 直接变成“无条件停止并监听”,也就是无法区分 τ9、τ10、τ11。这正是“不能区分附和和打断”的形式化解释。
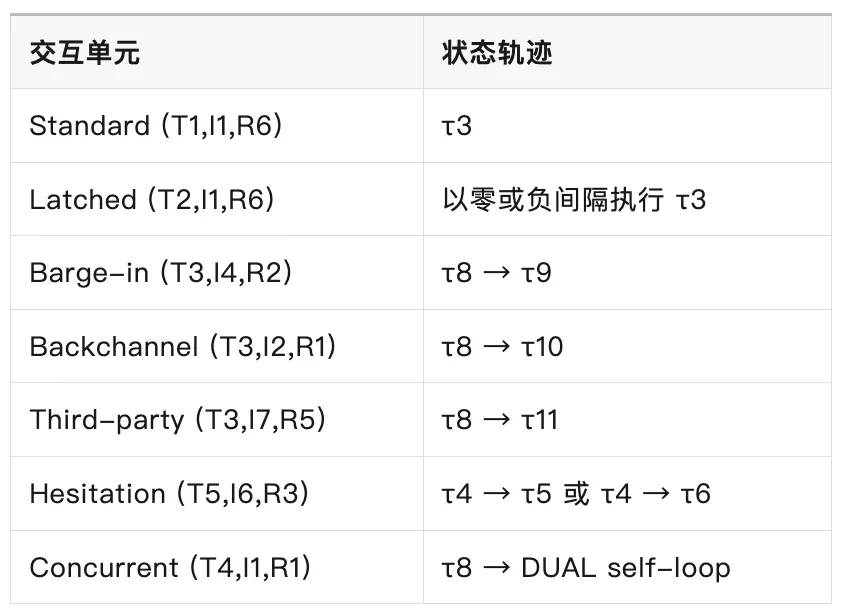
6.4 TIR 单元怎样映射到状态转移?
这样,如果某 Benchmark 在 Third-party 上失败,我们可以进一步定位:
  • 是没有进入 τ8?
  • 还是把 I7 判成 I4?
  • 或者没有正确执行 τ11?
6.5 六条系统轨迹
Trace 1:所有系统都会的标准轮次

IDLE--τ1→ LISTEN--τ3→ SPEAK--τ7→ IDLE

差异主要是 τ3 触发早晚,而不是轨迹本身。
Trace 2:MinMo / FireRedChat 的犹豫处理

LISTEN --τ4→ WAIT --τ5→ SPEAK

MinMo 在 L1 通过 semantic hidden-state predictor 实现;FireRedChat 在 L0 通过 EoT Classifier 实现。
这说明:同一外部行为可以由不同层级实现。
没有显式 semantic EoT 的 L2 系统,可能把 τ4 退化成延迟更久的 τ3。从结果看,它只是响应慢,但内部并没有真正建模 WAIT。
Trace 3:Moshi 的 Cooperative Barge-in

SPEAK --τ8→ DUAL --τ9→ LISTEN

Moshi 始终预测用户流,因此可视为持续具备进入 DUAL 的通道。用户抢话时,模型压制助手音频流并继续处理用户流。
最低时间粒度由 12.5 Hz Codec 决定,即约 80 ms,再加少量识别延迟。
Trace 4:OmniFlatten 的 Backchannel

SPEAK --τ8→ DUAL --τ10→ SPEAK

用户短暂说“嗯”,模型通过序列中的静音或流协调吸收这段重叠,再继续原回答。
缺少 τ10 的系统会错误走:

τ8 → τ9

于是把附和当成抢话。
Trace 5:FireRedChat 的 Third-party Voice

SPEAK --τ8→ DUAL --τ11→ SPEAK

pVAD 判断声音不是目标用户,Dialogue Manager 选择忽略并继续。
轨迹与 Backchannel 相同,差别在于 Intent Classification 和响应语义。
Trace 6:没有系统稳定完成的 Sustained Concurrent

SPEAK --τ8→ DUAL → DUAL → DUAL → ...

状态机允许 T4 · I1 · R1 的 DUAL self-loop,但当前系统无法稳定维持:
  • Chunk-alternation 结构上难以表示真正同步;
  • Multi-stream 架构上能表示,却没有从数据中稳定学到;
  • 最终常退化成让权,或在几帧后出现声学质量下降。
6.6 不要过度解读这套 FSM
论文给出三个非主张:
  1. FSM 不是具体控制器。它描述可观察行为,不规定 L0/L1/L2 怎么计算;
  2. 11 条转移难度不相等。τ3、τ7 基本解决,τ10、τ11 和 T4 self-loop 仍困难;
  3. 它不是所有对话事件的最终全集。未来如果加入长时间笑声等 I8,状态机也可继续扩展。

03、The Data Bottleneck:真正缺的不是更多单通道音频,而是双通道互动数据

论文在这一章提出很强、但有边界的判断:

在当前成熟的 L0–L2 系统中,真正限制全双工行为上限的,往往不是架构名称,而是训练数据覆盖了哪些 TIR 单元。

7.1 支持数据瓶颈论的三条证据
证据一:同为 L2,行为覆盖并不按子架构整齐分组
Moshi、LSLM、OmniFlatten、SyncLLM、Mini-Omni2 原则上都能进入相似状态,但实际覆盖不同。
例如 OmniFlatten 和 SyncLLM 结构不同,却都声称支持 Backchannel 与 Overlap;Mini-Omni2 与 Flatten 家族接近,却没有展示同样能力。
与行为更一致的变量,是 Post-training Data。
证据二:Moshi 明确用 Fisher 学 Turn-taking
Moshi 把 Fisher 作为 Full-duplex Fine-tuning 的主要真实 Multi-stream 数据,并认为该阶段形成 Turn-taking 能力。虽然缺少 remove-Fisher 消融,但这是很强的过程证据。
证据三:MinMo 的小 Predictor 背后是 4000 小时数据
MinMo 的 Predictor 只有单层 Transformer,却能获得实用的 Barge-in / Backchannel 行为。关键支撑是 4000 小时对话混合数据和启发式标签。
7.2 三类训练数据
Type A:Single-Stream Speech
普通单通道 ASR 数据。它能教会模型音频 Token 与文本的关系,但没有双方时间结构,不能直接教 Duplex Dynamics。
Type B:Single-Stream Dialogue / Instruction
例如:
  • VoiceAssistant-400K;
  • InstructS2S-200K。
它能教模型“收到问题后用语音回答”,但仍没有真实重叠与话权协商。
Type C:Two-Stream Time-Synchronous Dialogue
用户与对话伙伴分通道,并有帧级时间对齐。代表:
  • Fisher;
  • Switchboard;
  • CANDOR;
  • 部分 Easy Turn 数据;
  • 工业呼叫中心语料。
只有 Type C 直接包含:
  • 谁在什么时候说;
  • 何时重叠;
  • 哪段是附和;
  • 哪段是抢话;
  • 停顿后是否继续。
它也是最昂贵的数据类型,需要双人采集、双通道设备、时间戳、内容标注和隐私合规,每小时成本远高于普通 ASR。
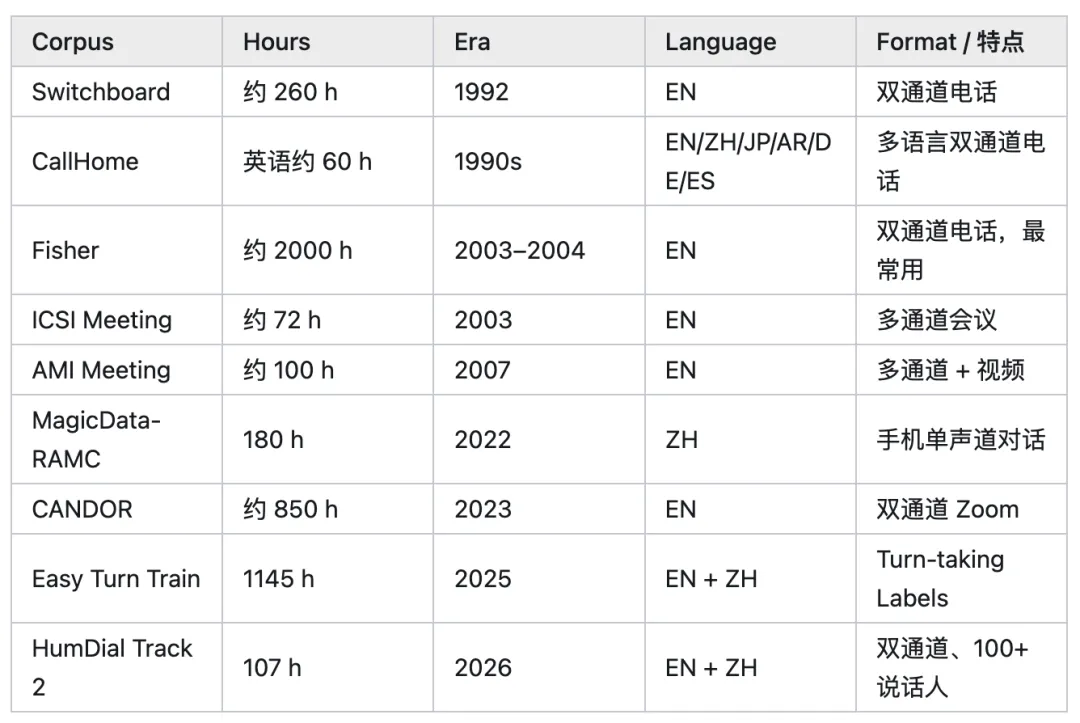
7.3 公开 Type-C 语料全景
公开资源总计约 5000 小时,而且仍由英语电话数据主导。
中文公开覆盖集中在 MagicData-RAMC 与 HumDial Track 2,合计不足 300 小时。这个分布和今天语音 Agent 的真实使用环境并不匹配:真实产品大量运行在手机麦克风、噪声环境和中文场景。
7.4 Public vs Industrial:两条无法对齐的数据轨道
Track A:Public
特点:
  • 每次发布约千小时量级;
  • 相对可复现;
  • 偏向 T1 / T2 / T5;
  • T3 只按自然分布出现;
  • T4 基本缺失;
  • 更新周期可能长达 5~10 年。
从 Fisher 2003 到 CANDOR,再到 Easy Turn 2025,公开数据迭代非常慢。
Track B:Industrial Proprietary
来源包括:
  • 呼叫中心;
  • 智能音箱;
  • App 内语音功能;
  • 真实客服和消费场景。
它可能规模更大,也可能包含更多重叠,但:
  • 总时长通常不公开;
  • TIR 单元分布不公开;
  • 许可封闭;
  • 复现性为零;
  • 每个业务还有自己的分布偏差。
因此,“工业模型比开源模型更会聊天”可能既来自数据规模,也来自特定产品分布,而公开研究无法逐单元验证。
7.5 五类合成管线
真实 Type C 太贵,于是多数系统使用合成。
方案一:Dual-Role TTS
LLM 生成轮流对话脚本,再让两个 TTS 声音合成。
只能覆盖干净的 T1,因为脚本本身仍是 A 说完、B 再说。
方案二:Overlap Injection
在轮次边界随机注入重叠。
可以增加:
  • T2 Latched;
  • 部分T3·I4Barge-in。
MinMo 使用 T ~ N(0.6, 0.4²) 一类启发式 inter-turn 分布,是这类思路的实例。
方案三:Backchannel Insertion
从真实或已有对话中识别短 Backchannel,再随机插入助手讲话区间。
它能增加 T3·I2,但存在循环依赖:要合成自然附和,源数据本身往往就要包含附和。
方案四:Silent-Token Augmentation
OmniFlatten 用 silent_speech_token 标记系统应该保持沉默的位置,让T5与等待行为进入Token监督。
方案五:Time-Anchor Self-Supervision
SyncLLM 在 Chunk 边界加入 [S0]/[S1],让模型显式学习时间位置。
它主要帮助 Streaming Architecture 同步,不一定直接扩展新的交互单元。
仍然难以合成的两个单元:
  1. T4 Sustained Concurrent:要生成两个语义连贯、持续同时又相互影响的独白,本身就很难;
  2. T3·I7 Third-party:需要第三说话人、环境混响和“并非对系统说”的语义关系。
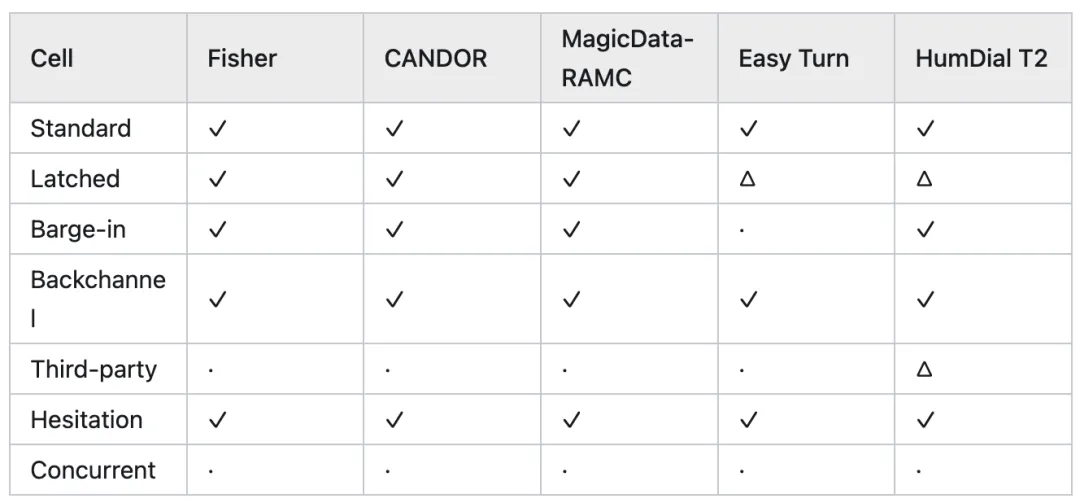
7.6 Corpus × Cell Coverage:公开数据到底缺什么?
这里最重要的结论有三个。
1. T4 是最严重的数据空白
没有公开 Corpus 真正包含大量持续并发的双人连贯讲话。于是所有系统都缺乏训练,也缺乏可靠评测。
2. Third-party 到 2026 年才开始被专门覆盖
HumDial Track 2 设计了 Third-party Speech 和 Speech Directed at Others 子任务,但训练子集仍很小。论文举例:相关 Train Split 中约 120 条 Third-party Item,而 Directed-to-Others 甚至可能为 0。
3. 组合公开语料可以覆盖七个关键单元中的六个
一个现实的 Open-source Mix 可以组合:
  • Fisher:电话规模;
  • CANDOR:视频通话声学;
  • MagicData-RAMC:中文手机环境;
  • Easy Turn:Turn Class Label;
  • HumDial Track 2:Rejection / Third-party 子场景。
唯一无法补齐的仍是 T4。
7.7 六个数据研究方向
方向一:第三方与背景人声合成
结合:
  • 单说话人 Voice Library;
  • Multi-speaker TTS;
  • Room Impulse Response;
  • 距离与方位随机化。
作者认为这是短期工程任务,可在 Person-month 级别构建千小时合成数据。
方向二:Ontology-Driven Synthesis Pipeline
构建统一开源工具,用可控概率决定:

p(T2), p(T3·I4), p(T3·I2), p(T3·I7), p(T4)

这样数据不再依赖自然分布,而可以按目标覆盖生成。
方向三:跨数据集对齐
用TIR统一标注Easy Turn、Fisher 等资源,形成ontology-typed corpus。
论文提到 FDB-v1.5 是评测资源,不应直接与训练 Corpus 混为一谈,但其标签体系可为对齐提供参考。
方向四:T4 定向真人采集
可能场景包括:
  • Conference Call;
  • Group Discussion;
  • Debate;
  • Family-room Recording。
因为合成难以达到真实交互质量,中期仍需要真人采集。
方向五:Agent-vs-Agent Self-Play
让两个 Full-duplex Agent 自行对话,通过 Ontology Sampling 触发不同事件。
风险是两个模型可能放大彼此偏差,因此必须有过滤和目标分布约束。
方向六:用训练目标补偿数据不足
包括:
  • Reinforcement Learning with Conversational Rewards;
  • 同时评分语义质量与 Turn-taking Robustness 的 Dual-axis Reward Model;
  • Auxiliary Turn-aware Objective。
这是唯一不要求立即新增真实数据的方向,因此对开源团队短期最有吸引力。
7.8 数据瓶颈论的边界
论文没有说“架构不重要”。它明确限定:
  1. 结论只适用于 L0–L2,L3 首先是范式创新;
  2. 架构会影响 Sample Efficiency;
  3. 工业团队采集数据的成本可能高于改架构;
  4. 当前结论依赖现有静态 Turn-taking Benchmark;未来若强调复杂推理,情况可能变化。
最准确的表述是:

数据设置行为上限,架构决定学习增益和抵达上限的效率。

04、Evaluation and Realization Gap:别再用一个总分概括“会不会全双工”

8.1 为什么 WER、MOS、BLEU 都不够?
  • WER 测 ASR;
  • MOS 测 TTS 自然度;
  • BLEU 测文本生成;
  • EoT Latency 测轮次切换。
它们都有价值,但都默认对话由离散的“用户事件 → 系统事件”组成。
全双工真正的问题是:

用户还在讲话、系统也在讲话时,系统每一帧应该做什么?

WER 不测系统能否被自然打断;MOS 不测系统会不会错误抢话;单一 EoT Latency 在 T4 中甚至没有清晰 Turn Boundary。
8.2 两套容易混淆的 FDB
Series A:Full-Duplex-Bench(FDB)
Lin 等人的版本化系列:

FDB v1 → v1.5 → v2 → v3

重点是 Behavior-level 与 Per-cell Evaluation。
Series B:FD-Bench
Peng 等人的独立 Pipeline:
  • Configurable Scenario Generator;
  • Test-case Construction;
  • Scoring Scripts;
  • Throughput、Latency、Robustness。
两套不是同一个 Benchmark,数字不能直接比较。引用时应写明作者或版本。
8.3 Benchmark 逐个介绍
1. Talking Turns
它用 Switchboard 真人对话训练 Supervised Judge,逐帧评估系统行为:
  • Speak;
  • Pause;
  • Backchannel。
优点是锚定真实人类 Turn-taking 分布。
局限是主要覆盖 T1、T2 和部分 T3·I4,对 Listener Backchannel 与 Third-party 覆盖不足。
2. FDB v1
四个轴:Pause、Backchannel、Turn-taking、Interruption。
对应:T5·I6·R3、T3·I2·R1、T1·I1·R6、T3·I4·R2。
局限:单轮、英语为主、静态测试集。
3. FDB v1.5
它把 Overlap 拆成四种场景:
  1. User Interruption;
  2. User Backchannel;
  3. Talking to Others;
  4. Background Speech。
这几乎一一对应 T3 的不同 Intent。
它的 Stop-latency Metric 是当前最接近 substantive-FD 的公开指标之一。
一个很有意思的发现是,系统常落入两种策略:
  • Response-first:停得快,但容易把 Backchannel 当打断;
  • Floor-holding:不易被干扰,但合法 Barge-in 时停得慢。
本质上,这是 τ9 与 τ10/τ11 的权衡。
4. FDB v2
FDB v2 从静态测试走向 Multi-turn Automated Examiner。
包含四类任务:
  • Daily;
  • Correction;
  • Entity Tracking;
  • Safety。
每类还有 Fast / Slow 两种节奏。
论文报告系统常在以下组合上遇到问题:
  • Concurrent Speech;
  • Mid-turn Correction,即 T3·I3;
  • Multi-turn Entity Tracking。
这些失败恰好与训练数据缺失单元重叠,为数据瓶颈论提供独立证据。
5. FDB v3
v3 把全双工放进 Tool-using Voice Agent:
  • 用户犹豫;
  • Tool Call 中途打断;
  • 恢复和纠错。
它更适合评测完整 Agent Stack,而不只是核心 FD Architecture。
6. MTR-Duplex
MTR-Duplex 关注:
  • Dialogue Feature;
  • Dialogue Quality;
  • Instruction Following;
  • Safety。
可以简单理解:
  • FDB v2 更关心“什么时候说”;
  • MTR-Duplex 更关心“说了什么”。
7. FD-Bench(Series B)
它是可配置工程 Pipeline,不是单一固定 Test Set,适合测试:
  • 端到端吞吐;
  • 部署延迟;
  • 系统鲁棒性;
  • 场景配置能力。
8. Easy Turn Test Set
评测四分类:
  • Complete;
  • Incomplete;
  • Backchannel;
  • Wait。
它提供开放 Baseline,便于 Turn Detector 横向比较。
9. HumDial Challenge 2026
计划提供:
  • Dual-channel 真人对话 Corpus;
  • Public Leaderboard;
  • Standard Evaluation Protocol。
论文把它视为 2026 年重要开放评测事件。
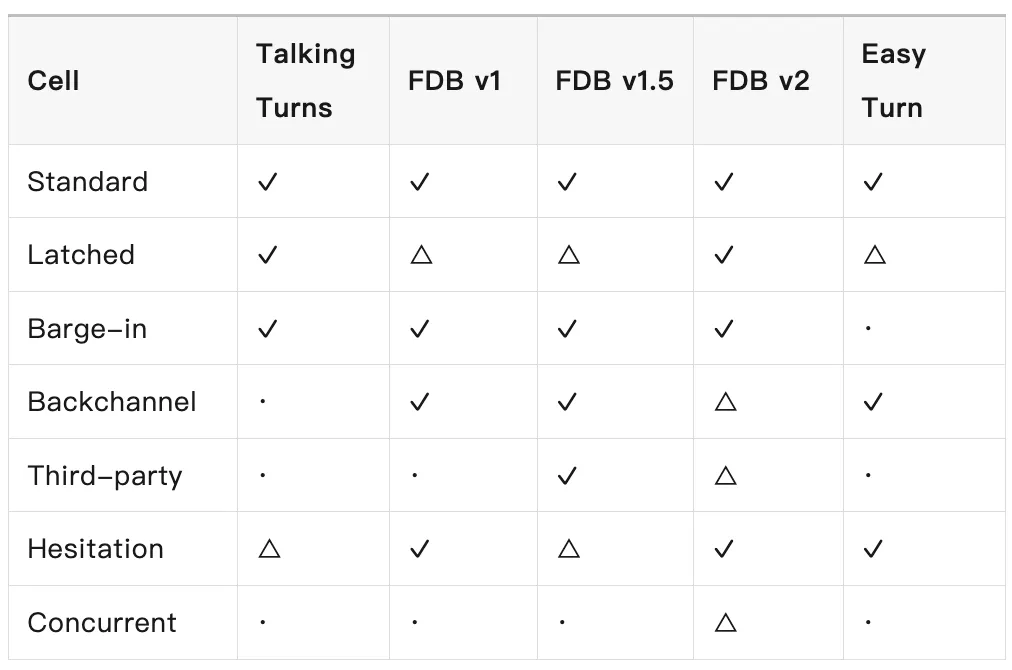
8.4 Benchmark × Cell Coverage
结论很直观:
  • Standard 和 Barge-in 已被反复测试;
  • FDB v1.5 是当前 T3 分解最有用的 Benchmark;
  • T4 只有 FDB v2 部分触及;
  • 没有公开 Benchmark 把 T4 作为主要独立指标。
训练侧缺 T4,评测侧也缺 T4,这会形成闭环:没人有足够数据训练,也没人有统一方式证明自己解决了。
8.5 Realization Gap:架构能做,不等于模型已经会做
论文的核心定义是:

Architectural Capacity

↓ 经过训练数据与目标

Demonstrated Behavior

两者差异 = Realization Gap

Mini-Omni2 与 OmniFlatten 都属于 L2 Flatten 相关路线,架构理论可达范围相近,但:
  • Mini-Omni2 没有展示 Backchannel 和 Concurrent;
  • OmniFlatten 声称支持两者。
差异位于“架构之后、评测之前”,也就是训练数据及目标。
因此,论文建议每个 FD 系统报告三部分:
  1. Architecture Profile:L0/L1/L2/L3、时间粒度、可达状态。
  2. Training Data Cell Profile:T1/T2/T3/T4/T5 分布、I2/I4/I7 的样本量、真实与合成占比、自动标注方式。
  3. Demonstrated Behavior Profile:在 FDB v1.5/v2 等协议上逐单元结果、不只给 Aggregate Score。
一个总分会把三个问题混在一起:
  • 架构根本做不到?
  • 数据没有教会?
  • 还是 Benchmark 没有正确测到?
8.6 当前评测的三个结构性缺口
缺口一:静态测试集不是真正互动
大多数 Benchmark 使用预录音频。系统的回答不会改变测试者下一步行为。
但真实对话是递归的:你刚才是否抢话,会改变对方接下来怎么说。FDB v2 的 Examiner 是进步,但仍主要遵循脚本化任务族。
缺口二:语言和声学环境单一
公开评测以英语、电话或 Zoom 风格音频为主。工业环境则大量包含:
  • 手机麦克风;
  • 远场;
  • 环境噪声;
  • 中文和其他语言。
缺少标准化测试,使开源—工业差距被进一步放大,而不是被准确测量。
缺口三:缺少 substantive-vs-apparent 因果探针
真正的因果问题是:

如果在系统说到一半时,改变用户当前音频,系统当前输出会不会立刻产生对应变化?

Chunk-alternation 系统可能 Stop Latency 不差,但只在固定边界响应。现有 Benchmark 很少用 Controlled Counterfactual 明确区分这一点。
论文认为下一代评测应组合:
  • Adaptive Multi-turn Protocol;
  • Explicit Causal-influence Probe;
  • Multilingual / Multi-acoustic Conditions。

05、Frontiers and Conclusion:T4 是数据前沿,L3 是架构前沿

论文最后区分了两个层面的未解问题。
9.1 T4:理论上可以靠数据补上的缺口
在 L0–L2 范围内,持续并发语音 T4 的最大问题是:
  • 公开训练数据几乎没有;
  • 合成方法不成熟;
  • Benchmark 没有主要指标;
  • 系统因此无法稳定学习和证明。
作者认为,这个问题原则上仍可通过定向真人采集、交互合成与新评测逐步解决。
9.2 L3 Hypothesis:更深层的架构前沿
L3 要把用户和助手的边界溶解进共享连续 latent,让 DUAL 成为原生状态。
论文提出三个候选架构。
方向一:Continuous-Latent Autoregressive Streaming
MAR 证明 Autoregressive Transformer 可以通过小型 Diffusion / Flow-Matching Head 预测连续值 Token。
如果迁移到语音对话:
  • 用户与助手共享连续 latent;
  • 不再受每帧 K 个离散 Codebook 约束;
  • DUAL 只是同一 latent 中两路活动,而不是额外控制机制。
Kimi-Audio Streaming Flow-Matching Detokenizer 和 SALMONN-omni Codec-free 表征,是合成侧的部分先行探索。
方向二:JEPA-Style Dual-Stream Prediction
JEPA 不是重建原始信号,而是从可见上下文预测 masked latent region。
Dual-stream Audio JEPA 可以:
  • 从 User + Assistant 联合上下文预测 Assistant Latent;
  • 原生整合 T3·I* Overlap;
  • 从无标注双通道音频自监督学习;
  • 减少对人工 Turn Annotation 的依赖。
这条路线的吸引力在于,它可能把“理解重叠”变成表征学习问题,而不是外部 Stop/Yield 分类。
方向三:World-Model-Conditioned Dialogue
世界模型学习的不是表面信号,而是可控状态。
应用于对话时,latent 可以编码:
  • 谁持有 Floor;
  • 刚才表达了什么;
  • 对方下一步可能做什么;
  • 当前 Dialogue Goal;
  • 系统可采取哪些行为。
IDLE / LISTEN / SPEAK / WAIT / DUAL 将不再是外部状态,而可能成为 latent space 的不同区域。
9.3 L3 仍然面临的三道门槛
  • 生态门槛:离散 Tokenizer、Cross-Entropy 训练和 AR 推理工具链已经成熟,连续 latent 必须替换大量基础设施。
  • 实时性门槛:当前 L2 系统已能做到约 200~500 ms 级别。Streaming Flow Matching 与 Continuous AR 尚未稳定达到同等实时水平。
  • 定义门槛:学界还没有统一回答 L3 latent 应该编码什么。三种候选方向目前仍是并列假说,而不是完整理论。

06、论文结论:把二元标签换成结构化能力画像

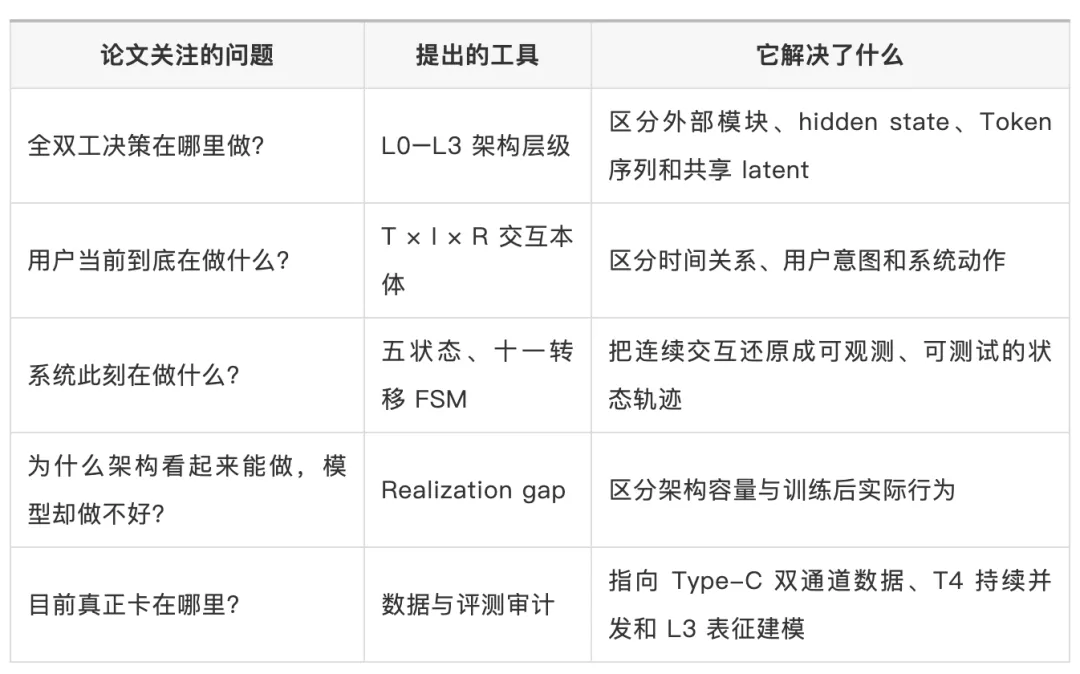
这篇论文最终贡献了三套框架:
  1. L0–L3 Architectural Hierarchy;
  2. T × I × R Interaction Ontology;
  3. Five-state Decision State Machine。
并围绕它们完成三类审计:
  1. Architecture Audit;
  2. Training-data Audit;
  3. Evaluation Audit。
它最重要的改变,是把:

“这个系统是不是全双工?”

换成:
  • 决策位于哪一层?
  • 它能处理哪些 TIR 单元?
  • 它能走过哪些状态转移?
  • 训练数据覆盖了什么?
  • Benchmark 真正证明了什么?
  • 架构能力和行为之间还有多大 realization gap?
对于研究者,这是一套论文组织和对比语言;对于工程团队,它也可以直接变成开发清单。
例如要做一个客服 Voice Agent,可以依次检查:

架构:L0、L1 还是 L2?

数据:是否包含真实 Backchannel、Hesitation、Third-party?

状态:τ9、τ10、τ11 是否能被分别触发?

评测:是否有因果 Probe,而不是只测停止延迟?

作者承认的局限
论文有两个主要限制。
第一,系统能力审计大量依赖论文自述
作者没有在统一硬件、统一数据和统一协议下独立复现所有系统。部分工业 L1/L2 系统还是闭源的。因此表中的 ✓/△/· 更准确地表示“公开证据强度”,而不是最终能力判决。
第二,三套框架仍然以现有 L0–L2 为基础
真正 L3 系统尚未出现。若 L3 带来完全不同的交互方式,当前 TIR 和 FSM 可能需要扩展,而不是简单套用。
最后,用十句话记住这篇论文
总结就是:
  1. 全双工不是“能被打断”这么简单。
  2. 同样是用户开口,可能是附和、抢话,也可能是第三方声音。
  3. L0–L3 的核心是看 Duplex Decision 在哪里发生。
  4. L0 并没有过时,它在解释性和部署成本上仍有优势。
  5. L1 是跨产品目标反复出现的结构吸引点。
  6. L2 数量最多,但 Parallel、Flatten、Chunk-alternation 的因果粒度差异很大。
  7. T × I × R 把模糊的“交互能力”拆成可训练、可评测的单元。
  8. 五状态 FSM 把每个能力进一步还原成可测试的状态转移。
  9. 架构可达不等于训练后实现,这中间就是 realization gap。
  10. 当前最大数据空白是 T4 Sustained Concurrent,最大架构前沿是 L3 Shared Representation。

07、结语

过去几年,语音模型的重点一直是“让 AI 说得更像人”。但全双工研究把问题往前推进了一步:

真正自然的语音交互,不只是声音自然,而是系统懂得什么时候该说、什么时候该停、什么时候该等,以及什么时候只需要继续听。

从这个角度看,全双工的难点甚至不完全在“语音”本身,而在于实时社会互动中的意图理解与行为决策。
这篇综述没有给出一个包打天下的模型,但它提供了一套相当清晰的地图:L0–L3 标出架构位置,T × I × R 标出交互类型,五状态机标出行为路径,realization gap 则提醒我们不要把“理论上可以”误当成“实际上已经做到”。
对一个仍在快速变化、术语尚不统一的研究方向来说,这种地图本身就很有价值。