在进入正文之前,可以先用一张“阅读地图”概括全文。 | | |
|---|
| | 区分外部模块、hidden state、Token 序列和共享 latent |
| | |
| | |
| | |
| | 指向 Type-C 双通道数据、T4 持续并发和 L3 表征建模 |
全双工行为 ≈ 架构可达性 × 训练数据的交互覆盖 × 每时刻决策策略- 架构能进入DUAL,但训练数据从未出现 backchannel,模型仍可能把“嗯嗯”当成打断;
- 数据和架构都具备,评测却只测普通轮次,那系统的真实能力依然无法被证明。
论文把这三者之间的差距称为realization gap,即“实现差距”。这个概念贯穿全文,也是理解当前全双工研究现状的关键。02、Introduction:为什么“是不是全双工”已经不是一个好问题?
“全双工”这个概念来自通信系统:双方可以同时发送和接收信息。放到语音对话里,它通常意味着系统在自己说话时仍保持监听,并且用户音频能实时改变系统后续行为。不过,论文提醒我们,全双工语音对话并不是大模型时代才出现。a. Google Duplex:先让大众看到“AI 可以打电话”2018 年 Google I/O 上,Google Duplex 展示了 AI 给理发店和餐厅打电话、完成预约的场景。它没有正式公开完整学术技术细节,但影响非常大:在 GPT-4o 之前六年,它就已经让大众相信 AI 可以参与一场自然电话对话。Google Duplex 背后的思路仍然是典型模块化路线:ASR → 语义理解 / 对话管理 → 响应规划 → TTS
再加上针对口语停顿、话轮切换和自然语气的工程优化。b. 蚂蚁集团与阿里 DAMO:工业 L0 的早期形态阿里 DAMO 2022 年的工作进一步引入 speaker-conditioned personalized VAD,也就是 pVAD,用于排除背景中的其他说话人;同时把“用户有没有说完”建模为对部分句子的学习式二分类,而不只是等待固定静音时长。VAD + EoT + Dialogue Manager
所以,从技术历史看,GPT-4o 不是全双工的起点。它真正改变的是产品预期和架构想象:人们开始期待一个端到端 Speech-to-Speech 模型在自己说话时仍然听着,并能被自然打断。- Engineered Synchronization vs Learned Synchronization。
举个例子:Moshi、OmniFlatten 和 SyncLLM 都可以被放进 Token-level 或 End-to-End 一侧,但三者的实时行为完全不同:- Moshi 同时预测用户流和助手流,时间粒度约 80 ms;
- OmniFlatten 把多路信号摊平成一个 GPT 序列;
- SyncLLM 按固定 Chunk 交替预测,当前 Chunk 内无法立即响应用户变化。
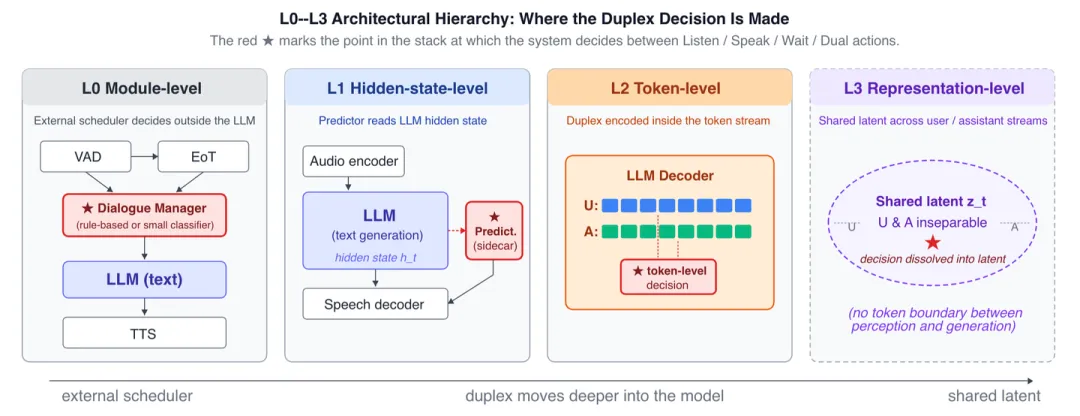
如果只给它们贴上“端到端全双工”标签,最关键的差异反而被隐藏了。第一项:L0–L3 Architectural Hierarchy作者按全双工决策点在系统栈中的深度,把现有系统分成四层:- L0 Module-level:在 LLM 外部决策;
- L1 Hidden-state-level:读取 LLM hidden state 决策;
- L2 Token-level:把决策编码到生成序列;
- L3 Representation-level:用户和助手共享连续潜在表征。
这个分类不是“L3 一定比 L0 好”的性能排名,而是设计选择的描述。第二项:T × I × R Interaction OntologyTemporal relation × User intent × Required response
T3 Overlap × I2 Backchannel × R1 Continue
T3 Overlap × I4 Floor-claim × R2 Stop
第三项:五状态、十一转移的 Decision State Machine作者使用五个状态:IDLE / LISTEN / SPEAK / WAIT / DUAL,并定义 11 条状态转移,把抽象能力落到逐时刻行为上。- Architectural capacity:设计原则上能表达什么;
- Demonstrated behavior:训练后的模型实际证明了什么。
作者不仅提出概念,还把同一套框架用于三个实证层面:这使三套框架不是只停留在“术语创新”,而是能用于系统设计、数据构建和评测诊断。- Primary targets:GPT-4o 之后明确声称支持全双工的系统;
- Historical baselines:2024 年以前的工业模块化系统;
- Taxonomy references:架构相近但不声称全双工的流式语音模型。
例如 Qwen2.5/3.5-Omni、Step-Audio R1.1、GLM-4-Voice 会作为分类参考出现,但不会被当成明确 FD 系统做完整逐单元审计。TTS-only、ASR-only、声音克隆和非对话音频生成则被排除。03、Foundations:全双工为什么绕不开 Audio Tokenizer?
论文第二章看似在讲基础设施,实际上它解释了 L2 系统为什么会长成今天这样。Transformer 原本处理的是离散文本 Token。要让它处理音频,首先必须回答:一段连续波形,究竟应该怎样变成 LLM 能读、能预测、还能实时生成的表示?2.1 Three Routes from Audio to LLM路线一:Discrete Audio Tokens最直接的办法,是把语音量化成整数 Token,然后像文本一样让 LLM 做 next-token prediction。代表系统包括:Mini-Omni、Moshi、OmniFlatten、GLM-4-Voice、SyncLLM。这条路线最大的优点是能复用现有 LLM 基础设施:但音频比文本密集得多。一秒语音可能产生几十帧,每帧又可能对应多个 Codebook Token,计算量和同步难度都会迅速上升。路线二:Continuous Audio Embeddings另一种办法是让流式 Speech Encoder 直接输出连续向量,再用 Projector 对齐到 LLM hidden-state 空间。典型例子是 LLaMA-Omni,Whisper Encoder 或自监督 Speech Encoder 负责提取连续声学表示,Projector 负责把维度和分布转换到 LLM 可消费的空间。SALMONN-omni 在 2026 年把这条 codec-free 路线带进全双工系统。路线三:Hybrid Text-Leads / Audio-Trails第三种路线让文本承担语义主干,音频稍后跟随,或者和文本并行输出。Moshi 的 Inner Monologue 是最典型的例子:模型先在内部文本轨道上明确“接下来要说什么”,再生成带音色和韵律的音频 Token。- 让文本领先,可以避免模型直接在海量声学 Token 上艰难规划语言内容。
2.2 Audio Tokenizer 的三代演化第一代:Semantic Units——懂“说了什么”,但还原不好“怎么说”代表模型包括:HuBERT、wav2vec 2.0、w2v-BERT、WavLM。这些模型先做自监督语音表示学习,再对 hidden state 做 k-means 等聚类,得到约 25~50Hz 的离散语义单元。Whisper 是监督式流式 Encoder 路线中的重要代表。SpeechGPT 和 AnyGPT 是第一代语义 Token 与 LLM 结合的典型系统。第二代:Neural Audio Codecs——声音还原好了,但语义组织不够友好SoundStream、EnCodec、DAC 把音频 Tokenizer 变成神经压缩系统:Encoder → Residual Vector Quantization → Decoder
典型配置可能是:75 Hz、每帧 8 个 RVQ Codebook、约 1~3 kbps。这类 Codec 能较好还原声音,但它的码本主要围绕重建误差组织,不一定围绕语言语义组织。同一帧里的多个 Codebook 没有明确的“先语义、后细节”优先级,LLM 在扁平化序列上学习时,容易花大量容量拟合声学细节。AudioLM 与 VALL-E 是这一代在生成侧的代表。第三代:Semantic–Acoustic Fused——让第一层更像“语音里的文本 Token”SpeechTokenizer、Mimi、CosyVoice Tokenizer 开始显式安排语义与声学信息:- 后续 Codebook 负责音色、韵律等声学残差。
- 第一 Codebook 从 WavLM 蒸馏语义信息;
12.5 Hz 意味着每帧约 80 ms。这个速率足够低,使自回归 Transformer 有机会实时生成;同时第一 Codebook 又有较强语义性,模型不必完全淹没在声学细节中。WavTokenizer 走的是平行的单 Codebook 低码率路线。论文认为,第三代 Tokenizer 工程成熟,是 2024 年后 L2 系统集中出现的重要上游条件。2.3 K-Tokens-per-Frame:L2 架构分化背后的真正问题RVQ 的核心问题是:每个时间帧不是 1 个 Token,而是 K 个 Token。K = 8
帧率 = 12.5 Hz
10 秒音频 = 125 帧
若完全串行展开 = 125 × 8 = 1000 Token
如果每个 Token 都经过主 Transformer 自回归预测,序列长度和推理开销会被放大 8 倍。
因此,Moshi、OmniFlatten、SyncLLM 的差别,很大程度上不是研究者凭空发明了几种同步方式,而是在回答同一个工程问题:同一帧的 K 个 Codebook 应该怎样排进自回归序列?- Moshi:时间维交给 Temporal Transformer,同一帧深度维交给小型 Depth Transformer;
- OmniFlatten:把多路 Token 直接沿时间轴摊平;
- SyncLLM:按固定时间块组织 Token,并用同步标记对齐。
a. Flow-Matching Streaming DetokenizerKimi-Audio 让 LLM 输入侧继续使用离散 Token,但输出语音不再依赖同一个 RVQ Decoder,而是使用分块式流匹配 Detokenizer。不必再绑定为同一套表示。输出自然度可以独立提升,也不必完全重训语言模型。b. Codec-Free RepresentationsSALMONN-omni 直接使用连续 Embedding,不再经过离散 Codec。它保留更多声学细节,但放弃了“audio as language”带来的训练复用便利。论文仍把它归到 L2,是因为作者对 L2 的定义不是“必须用整数 Token”,而是“决策发生在自回归输出序列层”。Tokenizer 不是无关紧要的前处理。它决定了 L2 能表达什么、延迟能做到多少;
L2 的各种子架构是上游表示约束的结果。尤其是 K-Tokens-per-Frame;
Token-level 不等于 discrete-only。连续值自回归序列也可以属于 L2。
04、A Brief History:全双工系统的三段历史与两个转折
ASR → NLU → Dialogue Manager → NLG → TTS
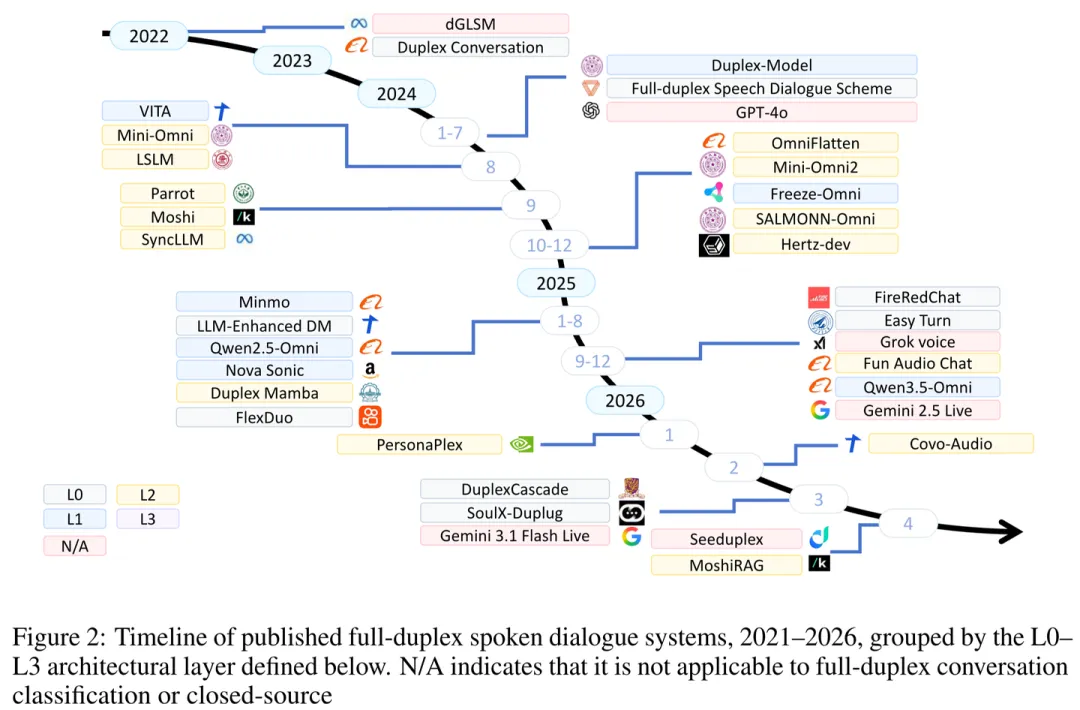
早期系统常用 VAD 能量阈值和约 300 ms 静音判断用户是否说完。这个方案处理命令式交互还可以,例如“打开空调”、“查询天气”,但面对真实对话会频繁失败:学术上,Sacks、Schegloff 和 Jefferson 1974 年关于 turn-taking 的经典研究,把话轮组织描述为 turn-constructional units 和 turn-allocation rules。Skantze 等人的后续工作,则逐渐把 Speaker Change 从静态阈值问题转成连续预测问题。工业界的 Google Duplex、Ant Group 和 Alibaba DAMO 把这套思路真正推到部署规模。3.2 第一个转折:Speech Became a Token离散 Audio Tokenizer 让波形可以进入 Transformer。随后出现:其中 dGSLM 在 2022 年就已经用双通道 Fisher 数据联合建模双方语音,甚至可以学习笑声、叹气和话轮节奏。它没有文本,也不能很好完成现代指令任务,但证明了“双方语音流可以被同一个生成系统联合建模”。同一时期,Qwen2-Audio、Step-Audio 等系统也在探索语音与 LLM 的深度耦合,只是目标更多是理解或单轮生成,而不是全双工对话。3.3 第二个转折:GPT-4o 把全双工变成产品预期2024 年 5 月 13 日,GPT-4o 展示用户可以在模型说到一半时插话,系统随后自然停止并转向新问题。这场演示的技术细节并不完全公开,但商业影响非常明确:用户开始把“能随时打断”视为端到端语音模型的基本能力。Mini-Omni、LLaMA-Omni、GLM-4-Voice 等开源系统很快出现。但有一点需要注意:这一批模型虽然是端到端 Speech-to-Speech,却大多仍以半双工方式工作。它们可能通过关键词或前端 VAD 被停止,但 Decoder 并没有持续联合处理用户和助手两路流。Wang 等人的 Full-Duplex LLM Scheme 和 THUNLP 的 Duplex-Model 则属于过渡性工作:把 VAD 调度机制接到 LLM 外面,但还没有统一到 Token 层。3.4 第三阶段:2024–2026 全双工路线快速分化- LSLM:让流式 SSL Encoder 与 Decoder-only TTS 在中间层融合;
- Moshi:同时输出用户音频预测、助手音频和 Inner Monologue 文本,实测约 200 ms。
- MinMo:hidden-state predictor 的 L1 路线;
- FireRedChat、FlexDuo、X-Talk:L0 模块化回归;
- Fun-Audio-Chat、Covo-Audio:工业 L2 平行流;
- SoulX-Duplug、FastTurn:可插拔模块;
- DuplexMamba:用 Mamba/SSM 取代 Transformer;
- SALMONN-omni:Codec-free 连续表示。
此外还有一些扩展工作,例如 PersonaPlex 强调角色与声音控制,MoshiRAG 引入异步知识检索,但它们不属于论文核心全双工审计范围。今天不是“端到端路线已经消灭模块化路线”,而是 L0、L1、L2 同时竞争,且各自服务不同工程目标。
05、Architectural Hierarchy:论文最核心的 L0–L3 架构地图
作者用一个简单问题重新整理所有系统:决定“听、说、等、同时处理”的那个动作,究竟发生在哪里?决策完全位于 LLM 外部。VAD、EoT、Dialogue Manager 等模块观察语音或部分转写,再控制 LLM 和 TTS。用户音频 → VAD / EoT / DM → LLM → TTS
4.1.2L1 Hidden-State-Level决策模块仍然独立,但它读取 LLM hidden state:用户音频 → Encoder → LLM hidden state h_t
├→ Speech generation
└→ Duplex Predictor
相比 L0,它能利用 LLM 已理解的语义,例如一句话虽然静音了,但句法结构还没完成,Predictor 可以选择继续等。不再有显式决策模块。系统是否继续说、输出静音、切换话轮,直接由 Token 或连续输出序列表示:联合序列 → [user token, assistant token, silence, shift, break ...]
这条路线理论上最容易让用户与助手流深度耦合,但效果高度依赖 Tokenizer、序列组织和训练数据。4.1.4 L3 Representation-Level用户和助手共享连续 latent,感知与生成不再通过离散 Token 边界协商:user stream + assistant stream → shared latent z_t
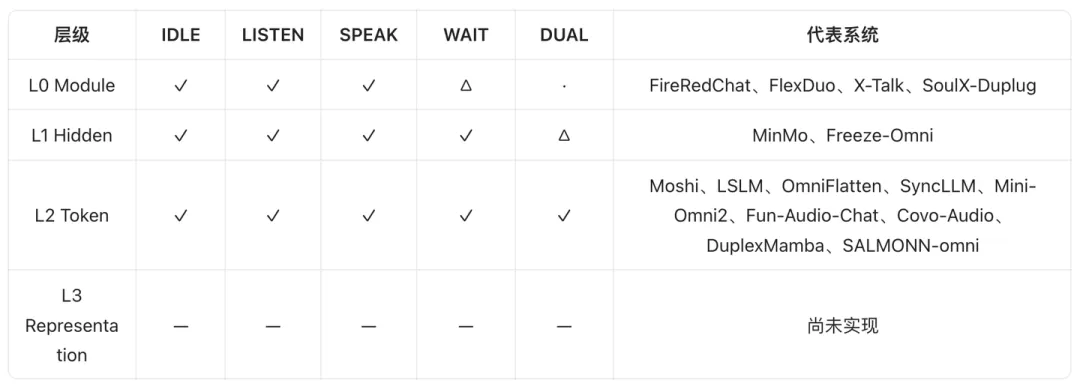
MinMo、Freeze-Omni 用L1做FD;Qwen2.5/3.5-Omni Thinker–Talker、Step-Audio R1.1 用相同形态做流式文本—语音生成。不同团队、不同目标反复收敛到“上游 LLM + 下游读取 hidden state 的语音模块”,说明这种结构并非偶然。但工业FD并没有统一停留在L1。Fun-Audio-Chat、Covo-Audio、OmniFlatten 又走向 L2,因此当前更像 L1/L2 双路线并存。FireRedChat、FlexDuo、X-Talk、SoulX-Duplug 都在 2025~2026 年继续推进 L0。模块化系统在延迟控制、解释性、迭代成本和业务接入方面仍有现实优势。所以 L0–L3 不能被理解成手机网络的“代际升级”。它更像数据库中的不同一致性设计:越深入不必然在所有场景都更划算。4.3 Cross-System Audit:不同层级能到达哪些状态?这里的 ✓ 表示“从结构上原生可达”,不表示“训练后一定做得好”。这正是论文后面 realization gap 的起点:Moshi、OmniFlatten、SyncLLM 都属于 L2,都能在纸面上进入 DUAL,但其时间粒度和真实行为并不相同。4.4 L0 Module-Level Systems:模块化路线的完整模型介绍4.4.1 FireRedChat:pVAD、EoT 和 Dialogue Manager 三层串联FireRedChat 使用三个模块驱动所有状态切换。pVAD 是带说话人条件的流式 Personalized Voice Activity Detection。普通VAD 只回答“现在有没有人声”,pVAD 还要回答“这个声音是不是目标用户”。这对应 TIR 中的第三方语音单元 (T3, I7, R5)。EoT 分类器读取流式 ASR 的部分结果,判断用户是否真正结束一轮发言。论文提到:中文准确率约 96%;英文准确率约 95%。因为它读取语义,而不是只看静音,所以能处理“我想要……”这类未完成句。Dialogue Manager 根据 pVAD 与 EoT 输出调度后端。FireRedChat 可在 Cascaded 与 Semi-Cascaded backend 间切换。- Cooperative barge-in:可通过快速声学触发实现;
- Backchannel:仍容易被当成打断,因为声学触发本身不理解用户意图。
- Barge-in response time:T90 ≈ 170 ms;
- End-to-first-response latency:P50 ≈ 2.34 s;
论文称这一表现与 LiveKit、Ten 等开放框架相比具有竞争力。它证明了模块化系统并不等于“低级”。当第三方过滤、可解释决策和业务稳定性很重要时,明确的 pVAD/EoT/DM 反而是一种优势。4.4.2 FlexDuo:把双工控制做成可插拔模块FlexDuo 的核心目标是让 Duplex Control 与底层 Dialogue System 解耦。它引入第三个 IDLE 状态:助手完成讲话后先进入一个静默缓冲区,系统在这里决定:需要特别注意,FlexDuo 文中的 IDLE 和本综述五状态机中的经典 IDLE 不完全一样。前者更像 SPEAK 与 LISTEN 之间的 inter-turn buffer。FlexDuo 的意义在于工程模块化:即使不修改主 LLM,也可以替换调度策略。4.4.3 X-Talk:不是一个单纯模型,而是一种路线主张X-Talk 是 SJTU X-LANCE 团队的 Position Paper。它明确反对“所有系统最终都应该走向 Token-level”的单线进化叙事。- 可以针对某个场景独立升级 pVAD、EoT 或 DM。
因此 X-Talk 在本综述中的作用,更像给模块化路线提供理论辩护。4.4.4 SoulX-Duplug:给冻结 LLM 外挂一个实时状态模块SoulX-Duplug 把 L0 重新包装成 Plug-and-Play Streaming State Prediction Module,可以接到冻结 LLM 上。4.4.5 Easy Turn:四状态 Turn Detector 与 1145 小时开放语料Easy Turn 严格来说不是完整 Speech Dialogue System,而是可以嵌入系统的轮次检测器。
更重要的是,Easy Turn 发布了 1145 小时开放轮次数据,是当前最大的公开 Turn-taking Corpus 之一。它既是模块,也为数据侧提供重要基础。4.4.6 FastTurn:在用户说完之前做出判断FastTurn 继续沿 L0 Turn Detector 路线发展,但更强调 Early Decision。- 语义路径:使用流式 CTC Decoder 持续输出 Partial Transcript。
两条路径融合后进入 Turn-decision Head,可区分话轮结束、犹豫、反馈语三类场景。相较 Easy Turn,FastTurn 的两个突出差异是:- 不必等待完整 EoT Token,可以基于正在进行的部分句提前决策;
- 声学与语义双路融合,在重叠和噪声条件下比 Acoustic-only VAD 或 ASR-only EoT 更稳健。
作者还发布了真人测试集,覆盖:Backchannel、Overlapping speech、Environmental noise、Pitch variation。论文报告其在更低中断延迟下获得更高 Turn Decision Accuracy。4.4.7 L0 Ceiling:为什么模块很快,整条链路还是慢?即使决策模块在约 100 ms 内完成判断,之后仍要经过:LLM Forward → Response token generation → TTS first chunk decoding
结果是实际响应延迟 δ*respond 往往被推到约 500 ms。这是 L1 把决策向 LLM 内部移动的直接动力。4.5 L1 Hidden-State-Level Systems:让 LLM 的语义状态参与双工判断Voice Encoder
↓
Input Projector
↓
Qwen LLM(LoRA)
├── Output Projector → Voice-Token LM → Token2Wav
└── Full-Duplex Predictor → 实时二分类决策
- 系统静默时:Respond now、Keep waiting。也就是区分标准轮次和用户犹豫。
- 系统正在说话时:Barge-in、Backchannel。这正好对应最容易混淆的 I4 Floor-claim 和 I2 Backchannel。
Speech-to-Text
→ Text-to-Speech
→ Speech-to-Speech
→ Duplex Interaction Alignment
Turn-taking 事件使用启发式规则自动标注。这个细节很重要:几千小时数据如果全部手工标注,成本几乎不可接受,因此 Auto-labeling 是现代双工训练的共同基础。- Speech-to-Text latency:约 100 ms;
- Full-duplex latency:理论约 600 ms;
MinMo 证明,双工决策不一定要完全进入 Token 序列。只要 Predictor 能读取 LLM 已形成的语义 hidden state,仍可以在较小改动下区分等待、响应、打断和附和。4.5.2 Freeze-Omni:冻结 LLM 的低成本 L1Freeze-Omni 不更新 LLM 主体,只在其周围训练 Audio I/O。- Multi-task Duplex Training。
第三阶段使用约 6 万条多轮 QA,总训练资源约 8 张 GPU。它在结构上属于 L1,但由于 Duplex Objective 没有更新 LLM 权重,论文把它视为 L0/L1 边界上的低成本方案。4.5.3 Qwen2.5-Omni / Qwen3.5-Omni Thinker–Talker:非 FD,但结构上非常重要Thinker 是文本 LLM,负责理解和推理;Talker 读取 Thinker hidden representation,再以双轨自回归方式流式生成文本和语音。文本输出 + 语音输出
但 Thinker–Talker 与 MinMo 的“LLM hidden state → 下游语音模块”结构高度相似。两个独立团队面向不同目标却收敛到同一形态,这就是作者把 L1 称为 structural attractor 的依据。4.5.4 Step-Audio R1.1:Articulation–Reasoning 双脑结构Step-Audio R1.1 同样不声称全双工。它的实时流式生成采用“双脑”拆分:- 一个 Articulator 读取上游 hidden state 并生成语音。
它与 Thinker–Talker 一起,为 L1 的跨目标复现提供额外证据。4.5.5 L1 Convergence:为什么这一层会反复出现?不过,论文并没有断言 L1 会成为最终标准。工业系统已经明显分成 L1 和 L2 两条路线。4.6 L2 Token-Level Systems:让双工行为进入生成序列L2 取消显式 Duplex Predictor。模型是否说话、是否静音、是否切换话权,直接体现在输出序列中。4.6.1 dGSLM:没有文本,也能学会双人对话节奏- 两路塔通过 Cross-Attention 交换信息;
- 采用 Next-frame Prediction;
由于没有现代 Instruction Following 能力,它不是实用助手,但它证明双流动态本身可以从音频中端到端学习,也是 Moshi multi-stream 的直接架构祖先。4.6.2 LSLM:Streaming SSL Encoder 与 Decoder-only TTS 的中层融合LSLM 于 2024 年 8 月发布,是最早公开的 LLM 时代 Dual-channel Duplex System 之一。- Token-based Decoder-only TTS 作为 Speaking Channel;
- Streaming SSL Encoder 作为 Listening Channel;
作者比较了Early Fusion、Middle Fusion、Late Fusion,结果是 Middle-layer Fusion 最好。为什么中层可能更合适?直观上,太早融合时声学表示还不够语义化,太晚融合时生成决策已经基本形成;中层恰好处于语义逐渐抽象、输出尚未定型的位置。LSLM 的 Channel Fusion 与 Moshi 的 Parallel Stream 不同,是 L2 中独立的一种子路线。4.6.3 Moshi:三路同步输出与约 200 ms 延迟组件一:Mimi Neural Audio Codec- 第一 Codebook 由 WavLM 蒸馏,承担主要语义;
Moshi 用两级 Transformer 处理 K-Tokens-per-Frame:- Temporal Transformer:沿时间建模;
- Depth Transformer:预测同一帧内多个 Codebook。
这样不必让大型主 Transformer 串行处理 8 倍长度。文本 Token 在对应音频 Token 前出现,并可带 Acoustic Delay。文本先承担语义规划,再让音频实现具体声音。- Predicted User-audio Token;
因为用户流一直被预测,用户突然开口不需要先经过独立 VAD 才“进入模型”。当用户开始抢话,助手流可以逐渐变成 Silence Token。- 约700 万小时公开音频预训练,并使用Whisper Transcript Supervision;
- 用 Speaker-diarized 数据做 Multi-stream Post-training;
- 用 Fisher Corpus 做 Full-duplex Fine-tuning;
- 用自家 TTS 合成的大规模对话做 Instruction Tuning。
论文特别把 Fisher 阶段视为 Turn-taking 能力形成的重要来源,不过 Moshi 原文没有报告移除 Fisher 的独立消融。Moshi 架构上非常适合进入 DUAL,但论文审计仍然保持克制:- Backchannel 更多出现在合成训练 Prompt 中,独立评测证据有限;
4.6.4 OmniFlatten:不改 GPT 架构,只重排 TokenOmniFlatten 将四路信息全部摊平成一条序列:用户文本 / 用户语音 / 助手文本 / 助手语音
并加入特殊的silent_speech_token,文本 Token 通常领先对应语音 Token,让语义先行。全双工不一定需要专门设计一个多流 Decoder,标准 GPT-style AR Model 加上合理 Token Arrangement 也可以实现。
silent_speech_token不是简单 Padding。它明确告诉模型:“在这个时间位置,助手应该保持沉默。”这使“什么时候不说话”也成为模型可学习的输出。4.6.5 SyncLLM:Chunk 边界同步与 apparent full-duplexSyncLLM 把时间切成固定 Chunk。论文评估了160 ms、200 ms、240 ms,最后基线使用 160 ms。Assistant Chunk → User Chunk → Assistant Chunk → User Chunk ...
并用 [S0] / [S1] 周期同步标记对齐。音频表示使用 25 Hz 去重 HuBERT Token,并做插值。问题在于因果粒度:在当前 Chunk 还没结束时,系统不能根据这个 Chunk 中后半段的用户音频立即改变自己。状态转移只能发生在 Chunk 边界。L2-shaped but apparent FD。
它在形式上同时表示两路流,但未必满足“用户当前音频能即时因果影响助手当前输出”的 substantive-FD 标准。4.6.6 Mini-Omni / Mini-Omni2:开放生态价值很高,但打断仍偏命令式Mini-Omni v1 在文本 LLM 上使用两个 Head,同一时间步并行生成文本与音频 Token,并提出 “Any Model Can Talk” 适配方案。训练使用 VoiceAssistant-400K。它的中断更像 Command-mode Barge-in:识别到特定触发词后停止。除此以外,一般用户音频无法持续改变当前输出。因此它也是 apparent-FD 的代表。不过,Mini-Omni 系列在开源价值上仍然很高:它降低了任意文本 LLM 获得语音输出能力的门槛。4.6.7 Fun-Audio-Chat:工业 Parallel Joint Speech–TextFun-Audio-Chat 来自 Tongyi Fun 团队,采用与 Moshi 相近的平行联合语音—文本设计。它没有像 MinMo 那样使用读取 hidden state 的 Sidecar Predictor,因此被归到 L2,而不是 L1。4.6.8 Covo-Audio:用 THINK / SHIFT / BREAK 显式表达状态切换Covo-Audio 是工业 L2 系统,直接在输出流中暴露双工决策:这使 LISTEN → SPEAK → yield 等变化都变成 Token-level Decision。这种设计的好处是可解释性比隐式静音更强:可以直接观察模型何时决定转移话权。4.6.9 DuplexMamba:证明 L2 不依赖 TransformerDuplexMamba 将主干换成 Mamba / State Space Model,但仍把双工同步编码进序列。- 不等同于 Transformer Attention;
4.6.10 SALMONN-omni:不使用 Codec 的连续 L2SALMONN-omni 直接在连续 Embedding 上工作,不使用离散 Audio Codec。看起来它似乎应该归到 L3,但这里仍把它放在 L2。原因是:- 连续值 Token Stream 仍有“生成层决策点”。
它证明 L2 的核心是 Decision Point,而不是整数 Token 形式。4.6.11 GLM-4-Voice:非 FD,但属于 L2-shaped 参考GLM-4-Voice 是流式端到端语音聊天模型,使用:- 从带 VQ Bottleneck 的 ASR 模型构建 Tokenizer;
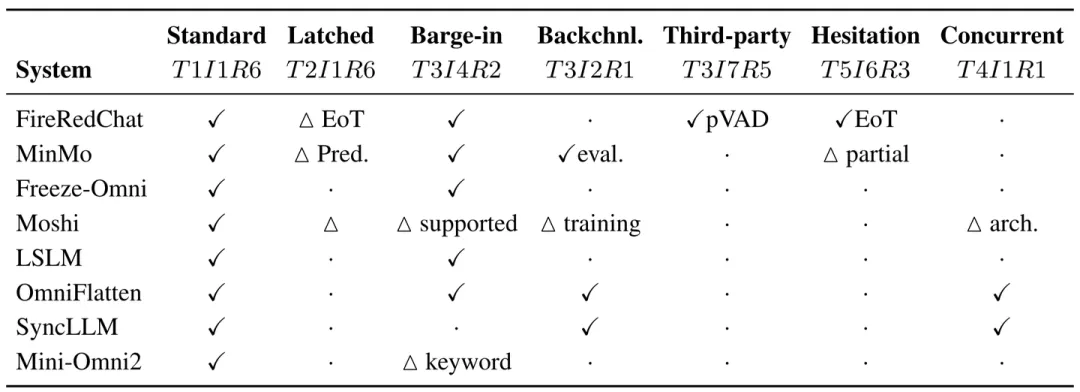
其 Stage 1 数据包括非监督、交错和监督混合数据。它保留显式 Turn Structure,架构上与 L2 相邻,但论文没有明确声称 FD。因此这里只作为“L2 结构也会出现在非 FD 流式系统中”的证据。4.7 L3 Representation-Level:为什么这一行还是空的?障碍一:Discrete Tokenizer 已形成强生态惯性Mimi、SpeechTokenizer、X-Codec、CosyVoice 等已经进入训练、推理和部署流程。切换到连续 latent 意味着很多基础设施都要重做。Diffusion 与 Flow Matching 可以生成高质量连续信号,但实时、低延迟、逐步可控的 Streaming Autoregressive Generation 仍不成熟。现有 Flow-Matching Detokenizer 多在离散模型下游工作,而不是取代建模层。4.8 系统 × 关键交互单元:谁真正证明了什么?- △:部分支持、只在训练中出现、只有结构可能性,或命令式支持;
- 第三方过滤证据很少,FireRedChat 的 pVAD 最明确;
- Backchannel 已有若干系统覆盖,但证据层次不同;
- “未报告”不等于“必然失败”,但不能把架构可能性当成已证实能力。
4.9 Training Recipe:现代 L1/L2 系统逐渐收敛的四阶段流程Stage 1:General Text LLM Pre-training
Stage 2:Speech-to-Text Alignment
Stage 3:Text-to-Speech Alignment
Stage 4:Duplex Interaction Alignment
Stage 4b:可选,Interaction-quality RL
- Moshi:Fisher 约 2000 小时 + 大规模合成;
- MinMo:4000 小时,其中 3000 小时真实、1000 小时模拟;
- MinMo:启发式 Turn-taking 规则;
- OmniFlatten:silentspeechtoken;
SyncLLM:周期同步 Anchor。

 语音小管家