
 语音小管家
论文题目:Listening with Time: Precise Temporal Awareness for Long-Form Audio Understanding
作者列表:邵明辰、苏航、田文杰、穆秉甡、林振楠、范利春、罗振波、栾剑、谢磊
论文原文:https://arxiv.org/abs/2604.22245
开源地址:https://github.com/alanshaoTT/LAT-Audio-Repo
背景动机:为什么长音频时间感知重要?
近年来,音频大语言模型(Large Audio Language Models,LALMs)在音频问答、音频描述等短音频理解任务上取得了显著进展[1,2]。然而,真实场景中的播客、访谈、电视节目、长录音等音频往往持续数十分钟甚至数小时,当输入扩展到长音频时,现有模型的理解能力会明显下降。
我们认为,长音频理解的核心挑战并不仅仅是更长的上下文,而是时间感知(Temporal Awareness)。除了回答"发生了什么",模型还需要回答"发生在什么时候",即能够准确建立事件内容与时间轴之间的对应关系。例如,定位主持人第一次介绍嘉宾后观众响起掌声的时间、广告插播的位置,或总结某一时间段内发生的事件等。
为此,我们首次提出了长音频时间感知(Long-form Audio Temporal Awareness,LATA)这一研究问题,并围绕时间感知能力设计了三项代表性任务:密集音频描述(Dense Audio Caption,DAC)、时序音频定位(Temporal Audio Grounding,TAG)和目标音频描述(Targeted Audio Caption,TAC),分别对应长音频的全局时序理解、时间定位以及局部内容理解,从不同角度系统评估模型的长音频时间感知能力。
进一步分析发现,当前主流音频大语言模型在LATA任务上普遍存在两类问题。第一类是时间幻觉(Temporal Hallucination),即模型能够生成合理的事件描述,却将事件定位到错误甚至不存在的时间位置;第二类是时间戳漂移(Timestamp Drift),即随着音频长度增加,模型预测的时间逐渐偏离真实位置,导致时间定位精度持续下降。
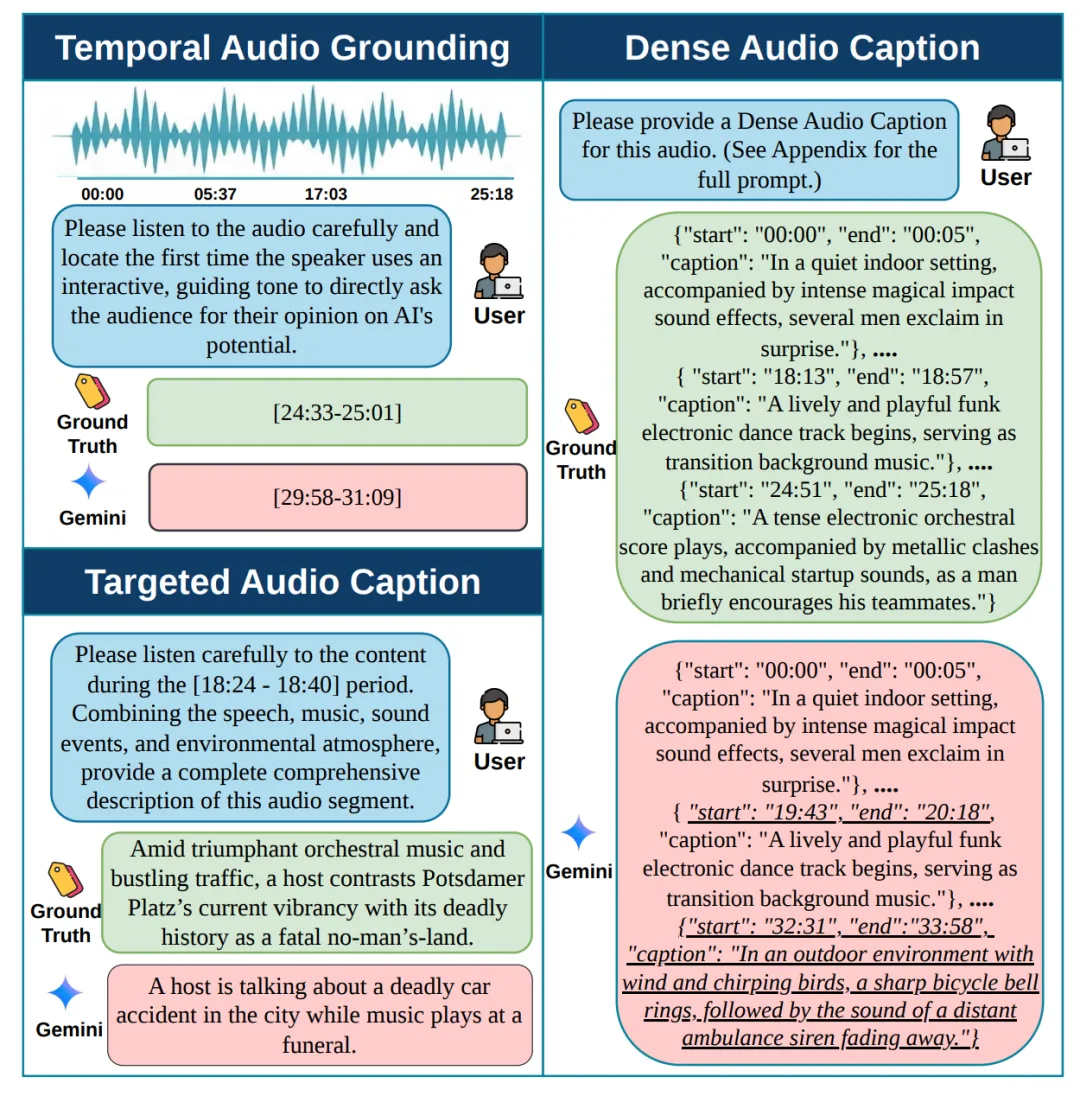
图1 长音频时间感知任务示例及错误类型分析
LAT-Chronicle:首个长音频时间感知数据集
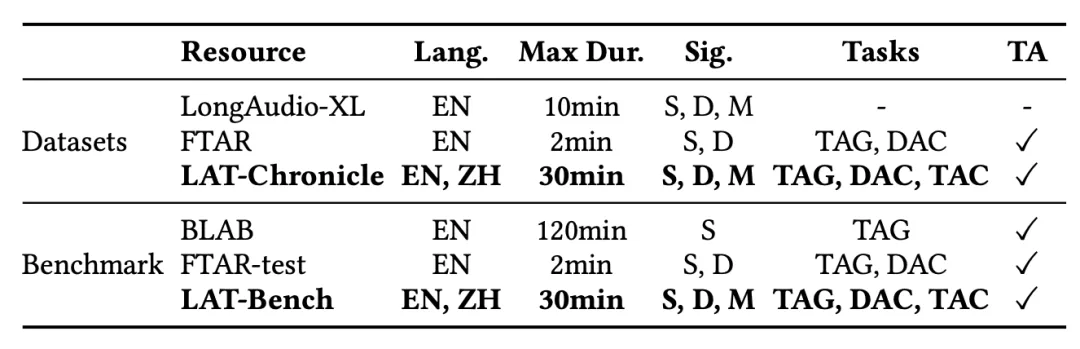
长音频时间感知能力的提升不仅依赖于模型设计,更离不开高质量的数据支撑。然而,现有公开音频理解数据集大多聚焦于短音频场景,即使包含长音频,也往往缺乏精细的时间级标注,难以支持模型学习事件与时间之间的对应关系。同时,目前也缺少统一、可靠的长音频评测基准,不同模型通常在不同数据集和任务上进行验证,难以客观评价其长音频时间感知能力[3]。
表1 长音频理解数据资源对比 注:Lang. 表示语种;Max Dur. 表示单段音频最大时长;Sig. 表示支持的音频信号类型,其中 S = Speech;D = Sound;M = Music;Tasks 表示支持的任务;TA 表示是否提供精细时间标注。
针对长音频时间感知对精细时间标注的需求,我们设计了 LAT-Pipe数据构建流程,如图2所示。与传统数据集直接生成最终标签不同,LAT-Pipe采用“原子标注→多任务生成→人工校验”的分层方式构建数据。
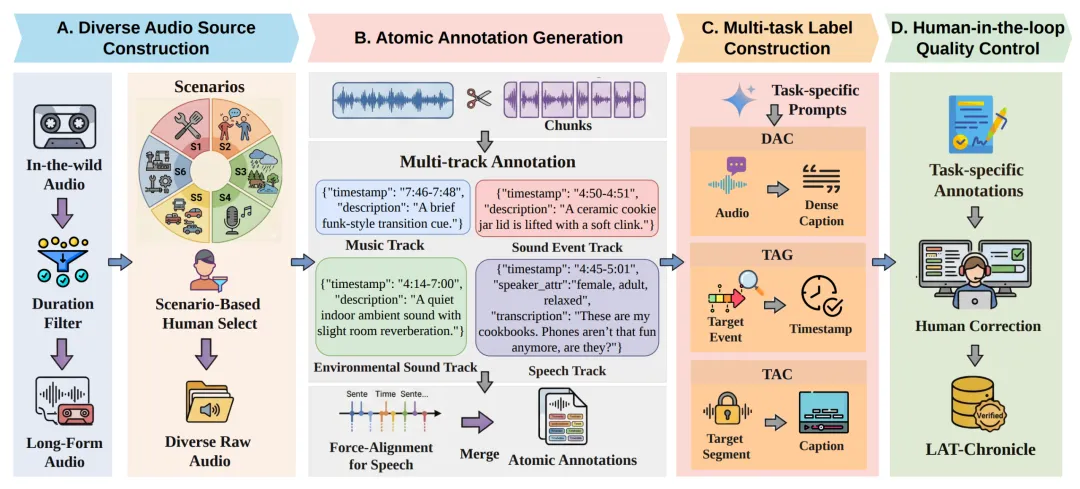
图2 LAT-Pipe数据标注管线
首先,我们从播客、访谈、会议、课堂、直播等真实场景中收集最长30分钟的长音频,并按照声学复杂度划分为六类典型场景。随后,将每段音频划分为语音、声音事件、音乐和环境声四个维度进行细粒度时间标注,形成统一的原子标注。在获得原子标注后,我们进一步通过任务化生成方式自动构建 DAC、TAG 和 TAC 三类训练样本,并在最终阶段引入人工审核与修正,过滤时间边界错误、内容幻觉以及标注不一致的问题,从而保证数据质量。
表2 六类音频分类体系
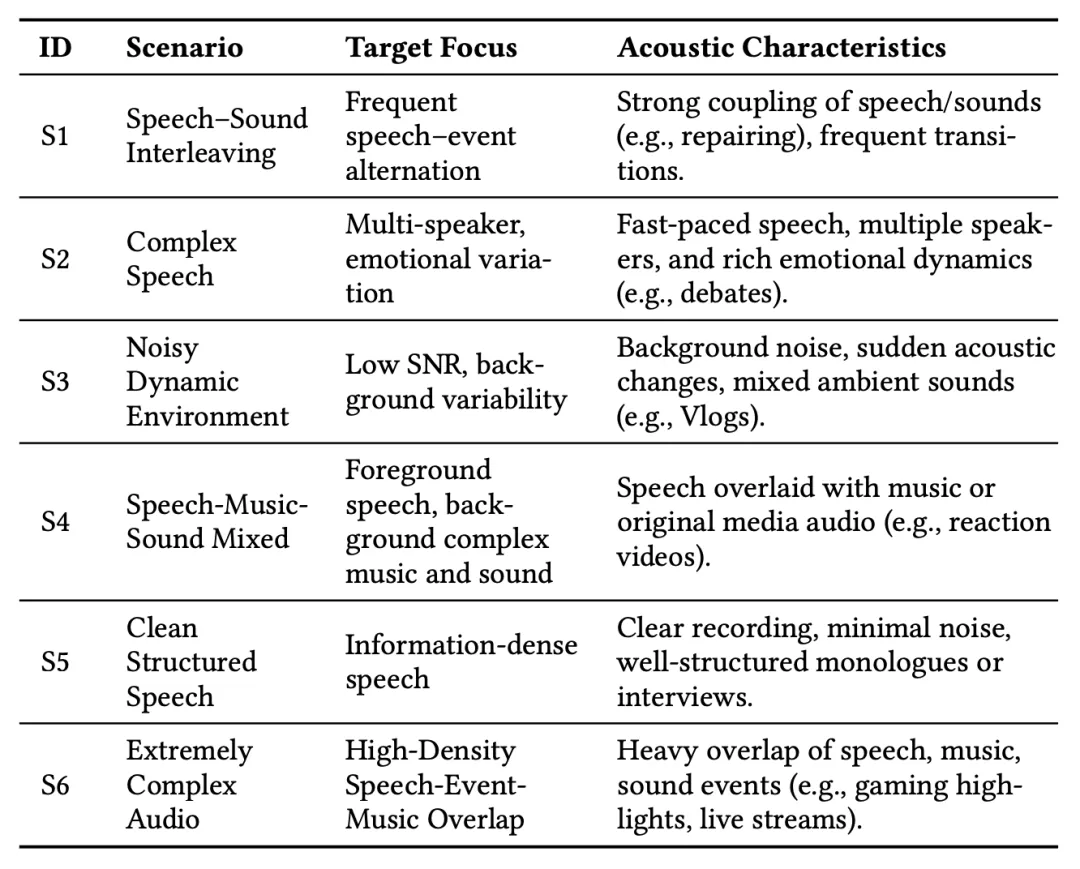
基于LAT- Pipe,我们构建了LAT-Chronicle,这是首个面向长音频时间感知的大规模数据集。LAT-Chronicle覆盖中英文六类真实场景,包括播客、访谈、演讲、会议等,总时长达到1200小时。不同于传统音频数据集,LAT-Chronicle不仅关注"发生了什么",更关注"发生在什么时候"。我们对长音频中的语义事件、说话人变化、背景环境、音乐及关键声音事件进行了精细的时间级标注,并进一步组织成长时间轴,为模型学习长时间跨度的时序关系提供监督信号。
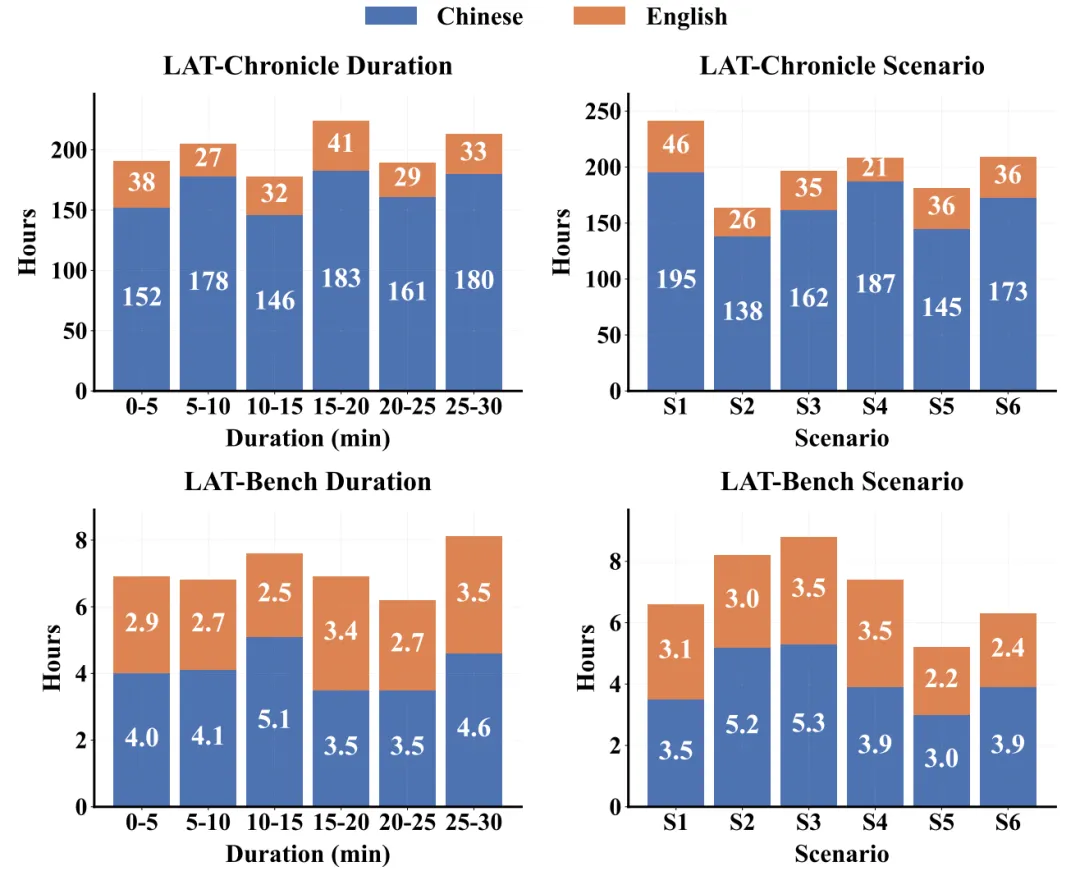
图3 LAT-Chronicle和LAT-Bench的时长与场景分布情况
LAT-Bench:首个长音频时间感知Benchmark
为了系统评估模型的长音频时间感知能力,我们进一步提出LAT-Bench。作为首个面向LATA的统一评测基准,LAT-Bench支持最长30分钟音频输入,并围绕密集音频描述、时序音频定位和目标音频描述三项代表性任务构建高质量测试集。
Dense Audio Caption要求模型同时预测事件的时间区间及对应描述,因此需要同时评估时间定位和语义质量。首先采用时间区间交并比(Intersection over Union,IoU)完成预测事件与真实事件的匹配:
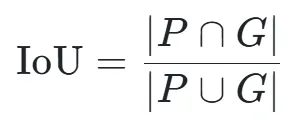
其中,P和G分别表示预测和真实时间区间。当IoU达到设定阈值(0.3、0.5、0.7)时,再采用FENSE评价Caption的语义一致性,并对不同IoU阈值下的结果取平均作为最终DAC得分。
Temporal Audio Grounding旨在评估模型根据文本查询定位目标事件时间区间的能力。评测同样采用IoU衡量预测区间与真实区间的重叠程度,并报告平均交并比(mIoU)以及Recall@0.3、Recall@0.5和Recall@0.7,从整体定位精度和不同定位精度要求两个角度综合评价模型的时间定位能力[4]。
Targeted Audio Caption给定目标时间区间,要求模型生成该时间段对应的音频描述,因此无需评估时间定位,而采用FENSE直接衡量生成描述与参考描述之间的语义一致性:
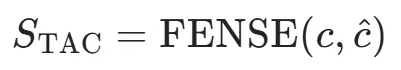
其中,c和c^分别表示参考描述和模型生成结果。该指标能够综合评价描述的语义准确性和语言流畅性,更符合音频描述任务的评价需求。
LAT-Audio:渐进式全局到局部时间推理框架
针对长音频时间感知任务,我们提出了LAT-Audio,一种面向长音频时序理解的渐进式全局到局部(Global-to-Local)推理框架,如图4所示。
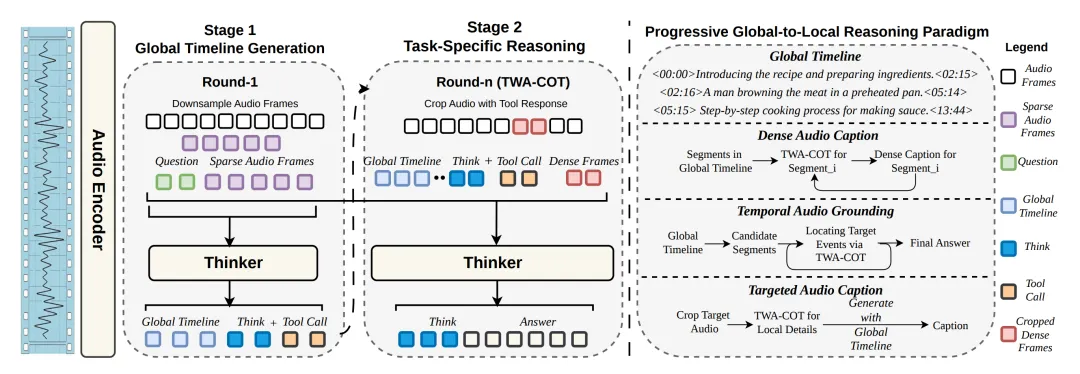
图4 LAT-Audio推理框架
人类理解长音频时,通常会先建立整体时间脉络,再针对相关片段进行反复回听和分析,而不是始终依赖整段音频进行推理。受此启发,LAT-Audio将长音频理解划分为全局时间建模和局部证据推理两个阶段,实现从全局到局部的渐进式时间推理。
(1)Global Timeline:构建全局时间轴
首先,模型对整段长音频进行粗粒度分析,生成包含关键事件及时间信息的全局时间轴(Global Timeline)。时间轴以时间顺序组织整段音频中的重要事件,形成长音频的全局时序语义结构,为后续推理提供统一的时间参考。相比直接依赖长上下文注意力,Global Timeline能够有效压缩长音频信息,同时保留完整的时序关系,降低模型发生时间幻觉和时间戳漂移的风险。
(2)Think-With-AudioChain-of-Thought:逐步调用音频推理
在获得全局时间轴后,我们进一步提出Think-With-Audio Chain-of-Thought(TWA-CoT)推理机制。模型首先结合用户问题和全局时间轴进行思考,预测最相关的时间区间;随后,通过Audio Retriever自动截取对应音频片段,并再次送入模型进行分析。如果当前证据不足,模型可以继续调用新的音频片段,逐步修正推理过程,直到得到最终答案[5]。
与传统Chain-of-Thought仅依赖文本推理不同,TWA-CoT在每一步推理过程中均能够主动获取新的音频证据,实现"思考—检索—验证"的闭环推理,有效避免模型仅依据记忆进行猜测。
(3)渐进式全局到局部推理
Global Timeline与TWA-CoT共同构成了LAT-Audio的渐进式推理框架。其中,Global Timeline负责建立全局时间结构,帮助模型快速定位候选时间范围;TWA-CoT则进一步结合局部音频证据完成细粒度时间定位和内容理解。二者相互配合,使模型既能够保持全局时序一致性,又能够获得精确的局部时间感知能力,在长音频理解任务中显著提升了时间定位精度和整体鲁棒性。
此外,我们采用"Global Timeline监督→全轨迹监督微调→强化学习优化"三阶段训练策略,进一步提升模型的时间推理能力。
实验结果
为了全面验证LAT-Audio的有效性,我们在LAT-Bench以及BLAB两个长音频评测基准上进行了实验,并与Gemini-2.5 Pro、Gemini-3.0 Pro、Qwen3-Omni等当前主流音频大语言模型进行了比较。
表3 主实验与消融实验结果
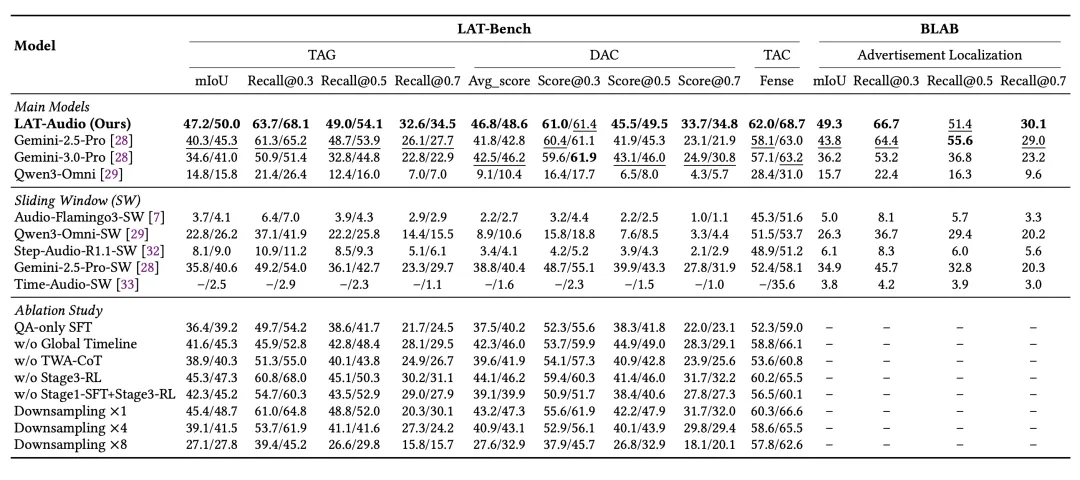
整体性能方面,如表3所示,LAT-Audio在Dense Audio Caption(DAC)、Temporal Audio Grounding(TAG)和Targeted Audio Caption(TAC)三项任务上均取得了最佳性能。以TAG任务为例,在中文测试集上,LAT-Audio取得了47.2%的mIoU,相比Gemini-2.5 Pro提升约7个百分点;在DAC和TAC任务上,同样取得了最优结果,说明所提出的全局到局部推理框架能够有效提升模型的时间定位能力和内容理解能力。
随着音频长度不断增加,LAT-Audio的优势更加明显。如图5所示,当音频长度超过15分钟后,现有模型的性能均出现明显下降,其中Gemini-2.5 Pro在TAG任务上的性能由62.6%下降至16.1%,Qwen3-Omni也呈现持续衰减趋势。而LAT-Audio得益于Global Timeline提供的全局时间结构以及TWA-CoT逐步调用局部音频进行推理,性能下降幅度显著更小,在30分钟长音频场景下依然保持稳定的时间定位能力,充分验证了所提出渐进式推理框架在长音频场景中的鲁棒性。
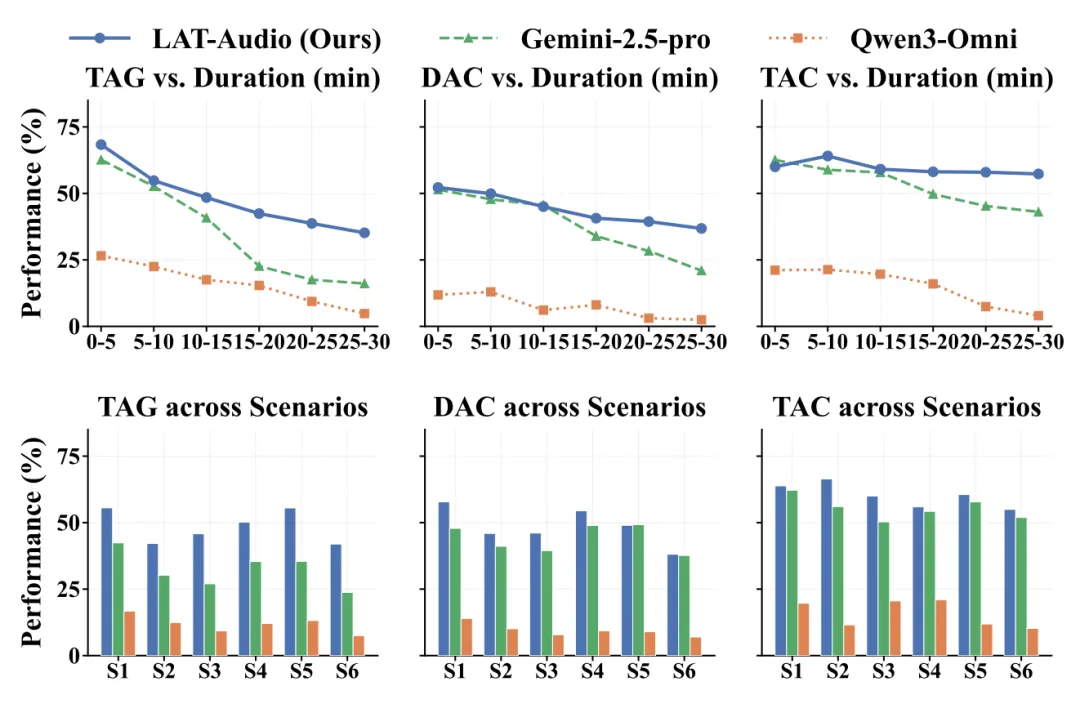
图5 时长、音频场景鲁棒性分析
进一步的消融实验也验证了各模块的有效性。去除Global Timeline后,三项任务性能均出现明显下降,说明建立全局时间轴对于长音频时间建模至关重要;去除TWA-CoT后,模型难以充分利用局部音频证据,时间定位能力进一步下降;同时,移除强化学习训练阶段后,模型整体性能也出现一致退化,表明强化学习能够进一步提升模型的多轮时间推理能力。这些结果说明,Global Timeline、TWA-CoT以及三阶段训练策略共同构成了LAT-Audio性能提升的关键。
参考文献
[1] Qwen Team. 2025. Qwen3-Omni Technical Report. CoRR abs/2509.17765 (2025).
[2] Fei Tian, Xiangyu Tony Zhang, Yuxin Zhang, Haoyang Zhang, Yuxin Li, Daijiao Liu, Yayue Deng, Donghang Wu, Jun Chen, Liang Zhao, Chengyuan Yao, Hexin Liu, Eng Siong Chng, Xuerui Yang, Xiangyu Zhang, Daxin Jiang, and Gang Yu. 2025. Step-Audio-R1 Technical Report. CoRR abs/2511.15848 (2025).
[3] Orevaoghene Ahia, Martijn Bartelds, Kabir Ahuja, Hila Gonen, Valentin Hofmann, Siddhant Arora, Shuyue Stella Li, Vishal Puttagunta, Mofetoluwa Adeyemi, Charishma Buchireddy, Ben Walls, Noah Bennett, Shinji Watanabe, Noah A. Smith, Yulia Tsvetkov, and Sachin Kumar. 2025. BLAB: Brutally Long Audio Bench. CoRR abs/2505.03054 (2025).
[4] Hualei Wang, Yiming Li, Shuo Ma, Hong Liu, and Xiangdong Wang. 2026. Listening Between the Frames: Bridging Temporal Gaps in Large Audio-Language Models. In Proc. AAAI. 26233–26241.
[5] Zhaochen Su, Peng Xiang, Hangyu Guo, Zhenhua Liu, Yan Ma, Xiaoye Qu, Jiaqi Liu, Yanshu Li, Kaide Zeng, Zhengyuan Yang, Linjie Li, Yu Cheng, Heng Ji, Junxian He, and Yi R. (May) Fung. 2025. Thinking with Images for Multimodal Reasoning: Foundations, Methods, and Future Frontiers. CoRR abs/2506.23918 (2025).
