
 语音小管家
其核心能力主要体现在以下方面:
多要素统一编排,支持精细的时间控制:一条 prompt 即可统一编排带有特定情绪的对白、关键音效和环境声,并可按时间线精准控制声音进场。
音色风格可控,长时稳定:支持文本与参考音频输入,在长音频和多次延长场景下保持角色一致性,同一音色也能自然呈现不同语气和情绪。
多语种自然生成:支持 20+ 语种的音频生成,同一角色声音可依据不同语种的特点,呈现更自然的发音、节奏与表达方式。
项目主页:https://seed.bytedance.com/seedaudio1_0
⏩技术路径:从拼接生成到完整场景生成
传统音频内容生产依赖多环节拼接。为实现完整声音场景的直接生成,模型需跨越三大技术门槛:
细节保留:兼顾语音的清晰度与韵律,以及环境声的空间氛围稳定性;
场景理解:建模各音频要素间的时间、情绪与声学互动关系;
多指令控制:服从文本、参考音频、时间轴、角色设定等多种条件约束。
Seed Audio 1.0 的核心思路是将不同音频要素置于统一框架下理解与生成,通过训练通用声学编码器,将各类音频映射至统一的声学表征空间,而非作为独立任务分别处理。这种联合建模方式使模型能更自然地组织角色语气、背景氛围与声音节奏,输出更接近完整作品而非素材拼接。
基于此,模型可生成兼具角色互动、情绪推进与氛围营造的复杂音频,适用于专题叙事、剧情对话、主播互动等典型场景。在创作过程中,用户可先将意图拆解为结构化时间线,明确角色、台词、情绪与音效的进入时机,从而精确控制声音的起止、衔接与叙事配合。
⏩音色能力:立得住、接得上、演得开
Seed Audio 1.0 支持零样本音频生成。创作者既可直接用文字描述目标声音,也可结合参考音频进一步控制生成结果,无需为每种声音单独训练模型。这有助于在创作前期快速试错,明确声音方案,减少后期返工成本。
在长音频场景(如有声书、播客、长剧集、多人对话)中,模型支持基于参考音频进行延展生成。当前单次可生成约2分钟音频,并可在此基础上持续延长,同时保持角色音色与表达方式的一致性。此外,模型支持“单音色、多角色”演绎,即同一音色可通过差异化塑造表现不同人物,拓展了配音与叙事类内容的创作空间。
⏩多语种生成:表达更地道
多语种创作不仅涉及内容翻译,更要求声音的节奏、重音、停顿与情绪符合目标语言习惯。Seed Audio 1.0 支持同一音色在多种语言中的自然迁移,已覆盖20余种语言。对于出海内容、游戏本地化、品牌广告、多语种播客及短视频创作,该能力使创意可基于同一角色或音色设定,高效扩展多语言版本,避免在每个市场重新制作。
⏩评测结果
为全面验证模型在真实创作任务中的表现,团队从文本生成音色、多场景创作和多语种生成三个维度进行了评估。
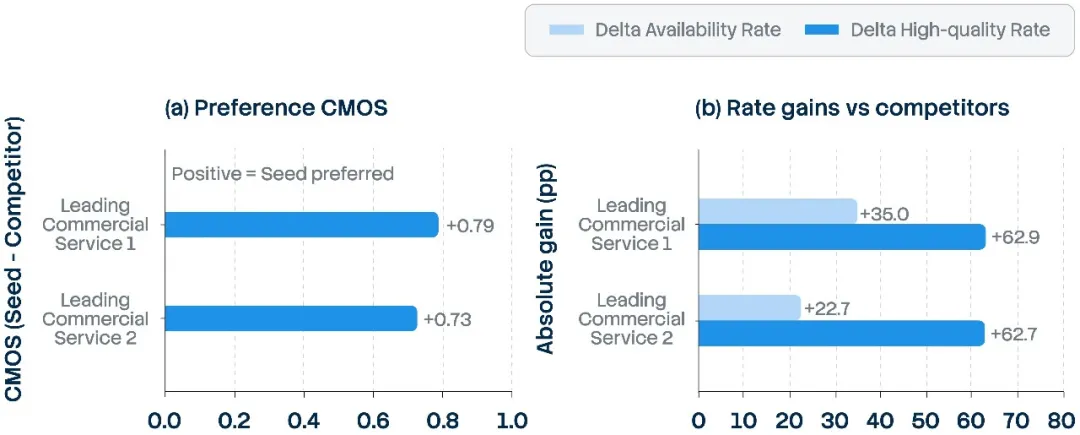
在文本生成音色能力上,Seed Audio 1.0 在 AB 主观评测中表现出显著优势,可用率和优良率也明显提升。
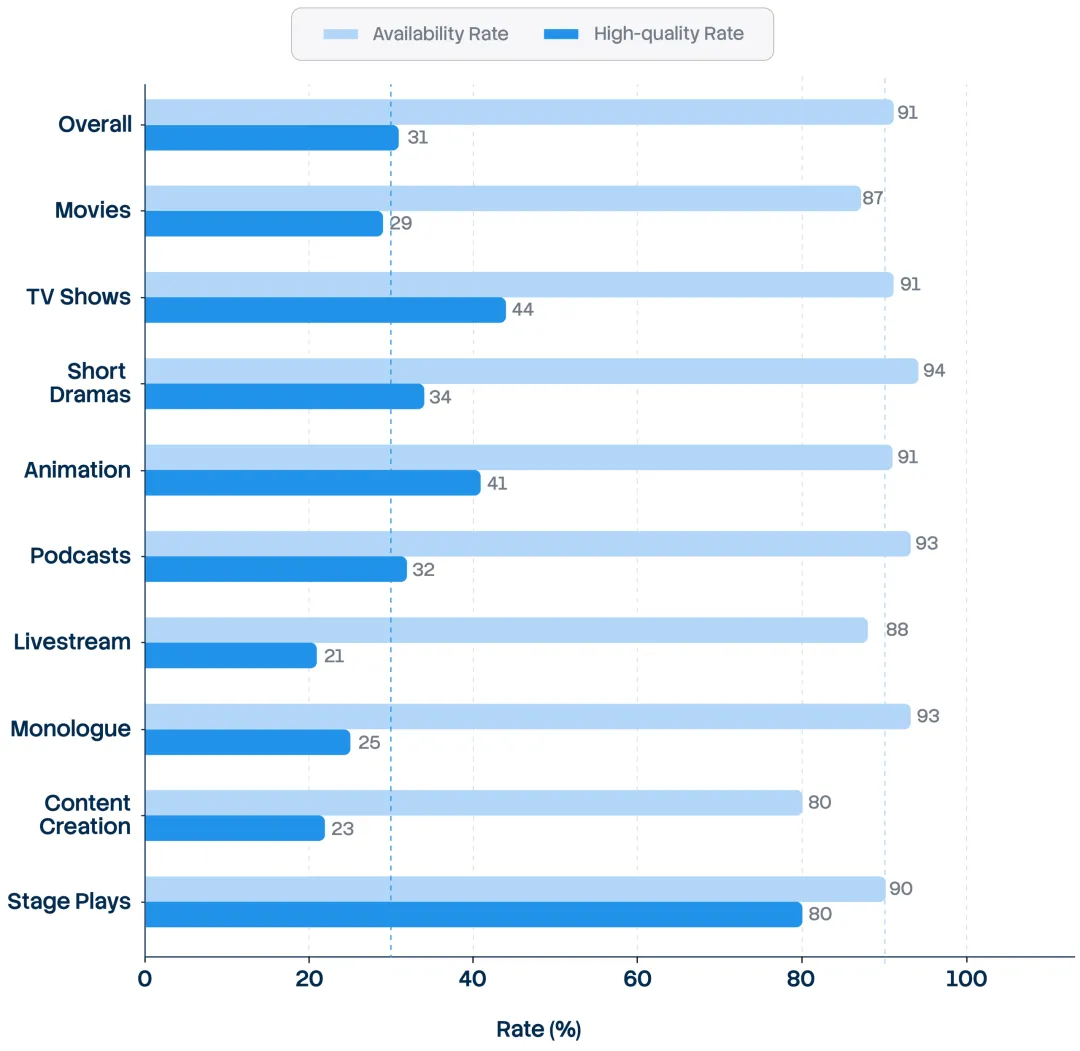
在多场景音频生成能力上,针对影视、电视节目、短剧、动漫、播客对话、直播带货、网络创作、话剧及语音合成等场景的评测显示,多数场景的音频可用率已达到90%以上。
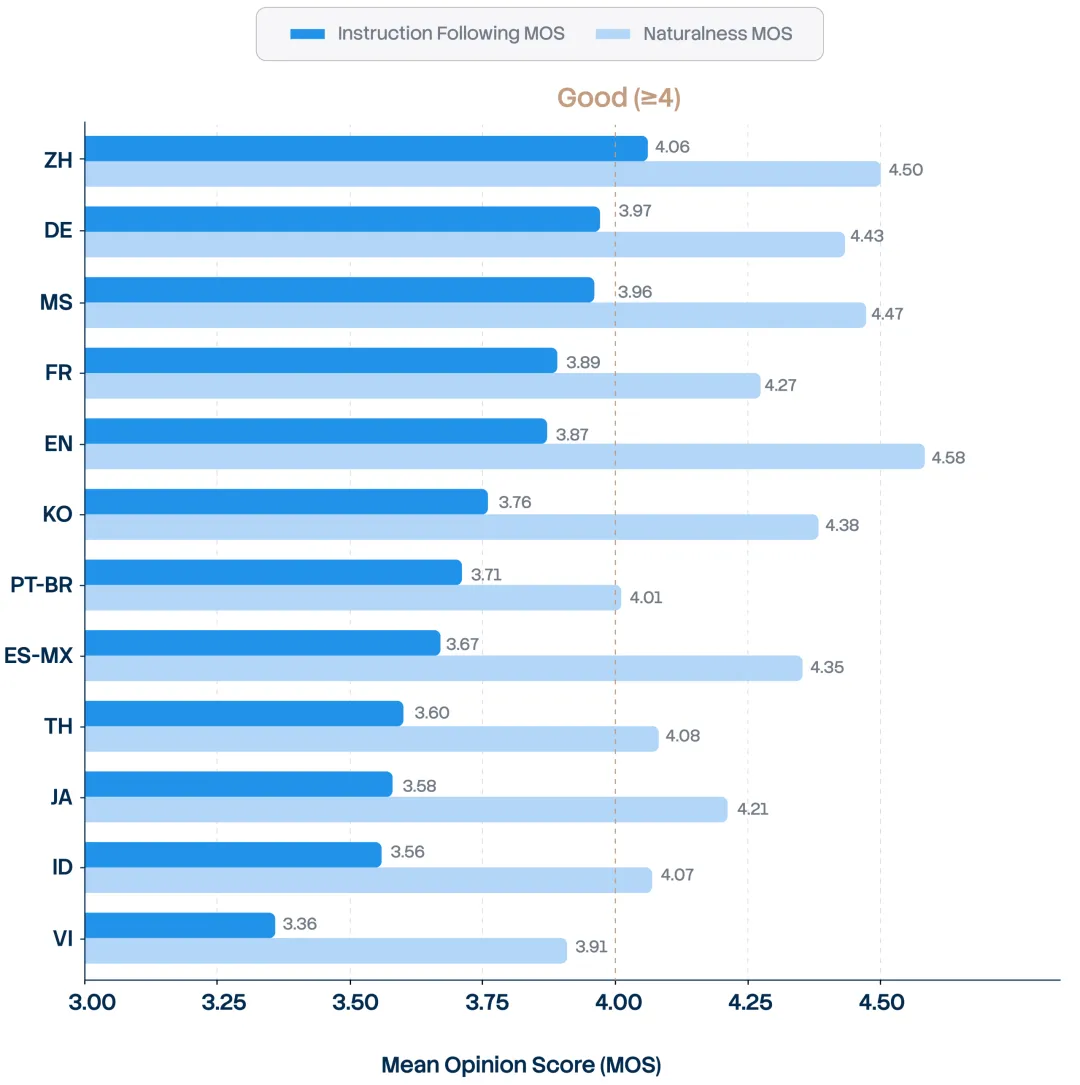
多语言音频生成:从指令遵循与音频自然度两个维度进行人工评测。在音频自然度上,大部分语言的MOS评分超过4分,音质达到优秀水准;在复杂指令遵循上,除越南语外,其余语言的MOS均高于3.5分,表明模型已具备较强的多语言指令遵循能力。
⏩未来方向
团队表示,以Seed Audio 1.0为起点,未来计划进一步拓展模型在真实创作流程中的能力边界。研究方向包括:通过模型框架创新支持视频参考等更多模态输入;满足长音频、分轨等更复杂的生成需求;以及探索将音频生成与可控翻译结合,提升模型在多语种场景下对内容表达与时长约束的控制能力。
