
 语音小管家
图片来源:https://isca-speech.org/Latest-News/13652479
ISCA 成立于 1988 年,是全球语音通信与口语处理领域最具权威性的国际学术组织。ISCA Fellow 是协会授予会员的最高学术荣誉,旨在表彰在语音科学、技术与工程领域作出卓越、持久贡献的学者,每年当选人数极少,是语音圈公认的顶级殊荣。该奖项设立于 2007 年,每年新晋 Fellow 不超过当年ISCA 会员总数的千分之三。自设立以来,全球 ISCA Fellow人数仅100余人。
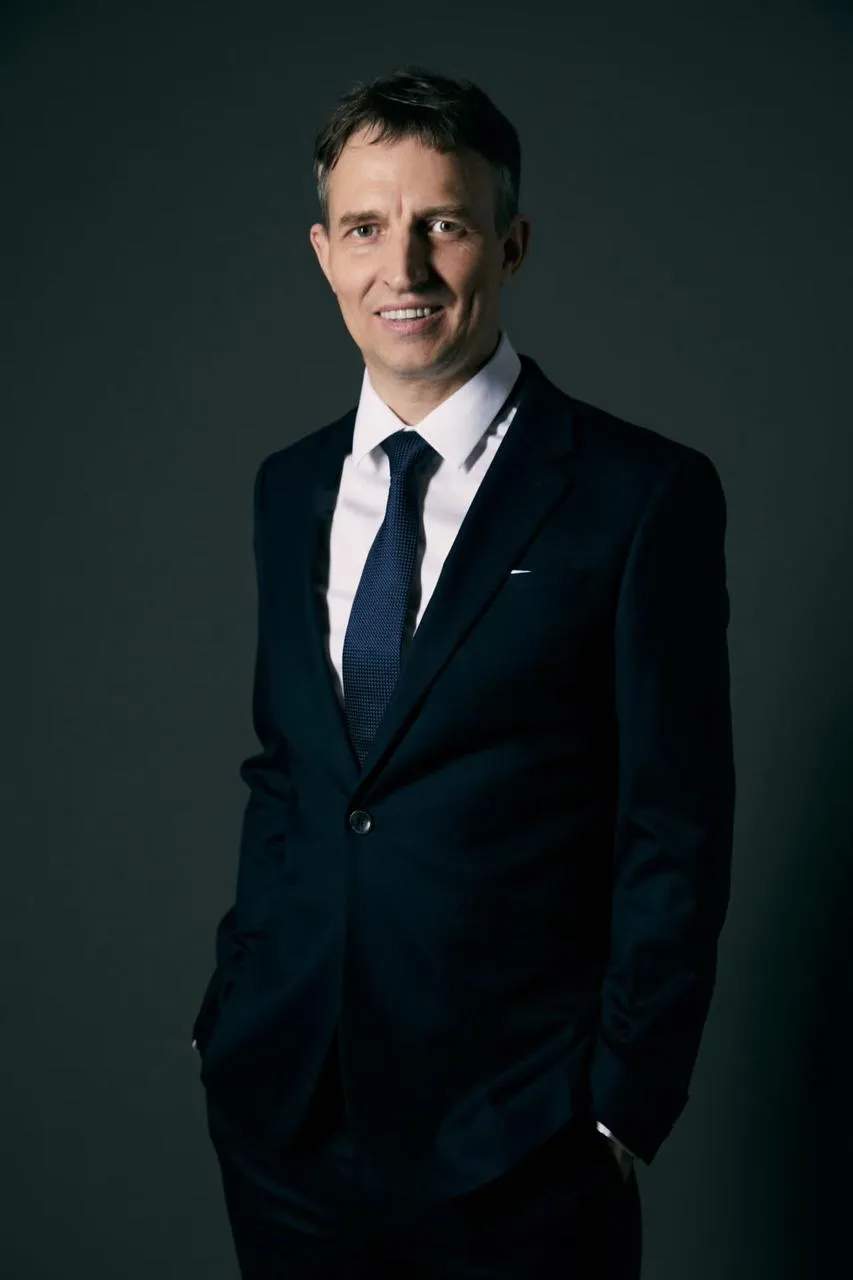
今年全球共 8 位学者当选,Daniel 是唯一一位创建了行业基础设施级开源软件,在学术和工业界都有突出贡献的科学家。
⏩从剑桥到北京,一位语音科学家的二十年征程
Daniel Povey 的国际学术与职业生涯始于剑桥大学。他于 2003 年在剑桥大学获得博士学位,随后进入工业界,先后在 IBM T.J. Watson 研究中心 和 微软研究院 工作了约十年时间,深耕语音识别核心技术。
之后,为了全身心投入 Kaldi 开源软件,他加入约翰斯·霍普金斯大学 任教七年,正是在这一时期,他打造了 Kaldi 语音识别工具包,将智能语音技术一次次推向新高度。这是全球使用最广泛的语音识别开源框架,几乎所有语音团队都曾或正在使用它。他还参与创建了著名的 LibriSpeech 数据集,成为全球语音研究的标准基准之一。
早在 Kaldi 诞生之前,Daniel 就提出了 Minimum Phone Error(MPE)序列训练方法,这是早期将区分性训练引入语音识别的开创性工作之一,为后续的 LF-MMI 等一系列方法奠定了理论基础。Daniel 也是将深度学习用于语音识别领域的重要引领者。在语音识别中推广了时延神经网络,配合 LF-MMI 训练,是2015-2020 年学术界和工业界普遍使用的最佳组合。 他还是深度学习在声纹识别领域的重要引领者。提出的 X-vectors 方法是第一个取得成功并被普遍应用的深度学习说话人识别方法,至今仍被广泛使用。他的谷歌学术引用量已超 6 万次。
2019 年 11 月,Daniel 正式移居北京,加入小米集团,出任语音首席科学家。
⏩新一代 Kaldi,智能语音新突破
加入小米后,Daniel 带领团队推出了新一代 Kaldi 开源项目(包含 k2 / Lhotse / Icefall / Sherpa 四大子项目),在语音识别与合成方向持续取得里程碑式进展:
Zipformer & Zapformer 编码器:Zipformer 是首个严格超越 Google Conformer 的语音编码器,被 ICLR 2024 接收为 Oral 论文(前 1.2%);2026 年升级版 Zapformer 将识别精度再提升 10%-15%,大幅增强训练稳定性和泛化性。
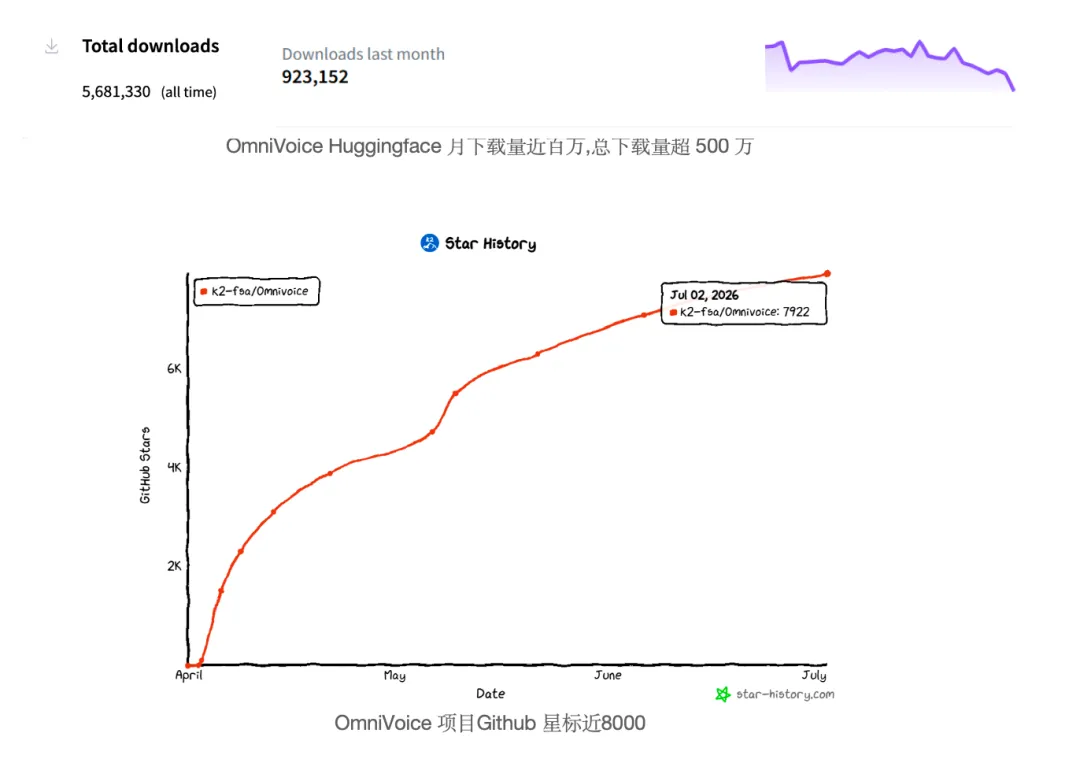
OmniVoice 多语言 TTS:2026 年发布支持 600+ 语言/方言的零样本语音合成模型 OmniVoice(0.8B 参数,Qwen3 初始化),仅需 3-10 秒参考音频即可跨语言克隆音色,中英文 Seed-TTS / LibriSpeech-PC 基准达 SOTA,在客观评测集下超越 MiniMax 和 ElevenLabs 等商用模型,开源 3 个月,Huggingface 下载量超 500 万次。
CR-CTC(Consistency-Regularized CTC):被 ICLR 2025 接收,让纯 CTC 模型性能比肩 Transducer,在 LibriSpeech / AISHELL-1 / GigaSpeech 等基准上刷新 SOTA,显著降低 ASR 训练与部署门槛。
ZipVoice 零样本语音合成:基于 Flow Matching + Zipformer 骨干,推出 ZipVoice(零样本单说话人 TTS)与 ZipVoice-Dialog(零样本对话 TTS),参数量少、推理快,CPU 单线程可达实时,配套 OpenDialog 数据集同步开源。
sherpa-onnx 全平台部署:新一代 Kaldi 的端云一体推理引擎 sherpa-onnx,支持高通/昇腾/瑞芯微等主流 NPU,覆盖 Android / iOS / 嵌入式 / 服务端,被开发者称为“智能语音领域的瑞士军刀”。
新一代 Kaldi 团队在 Interspeech、ICASSP、ICLR、ACL 等顶会发表论文数十篇,已成为全球开发者构建 AI 语音系统的核心基础设施之一。
