
 语音小管家
近日,浙江大学团队提出的论文SDiaReward: Modeling and Benchmarking Spoken Dialogue Rewards with Modality and Colloquialness被ACL 2026 Main Conference接收。该工作聚焦端到端口语对话系统中的奖励建模与评测问题,提出了面向多轮语音对话的奖励模型SDiaReward,并构建了数据集SDiaReward-Dataset与分层评测基准ESDR-Bench。
论文链接:https://arxiv.org/abs/2603.14889
项目主页:https://sdiareward.github.io/
代码仓库:https://github.com/MM-Speech/SDiaReward
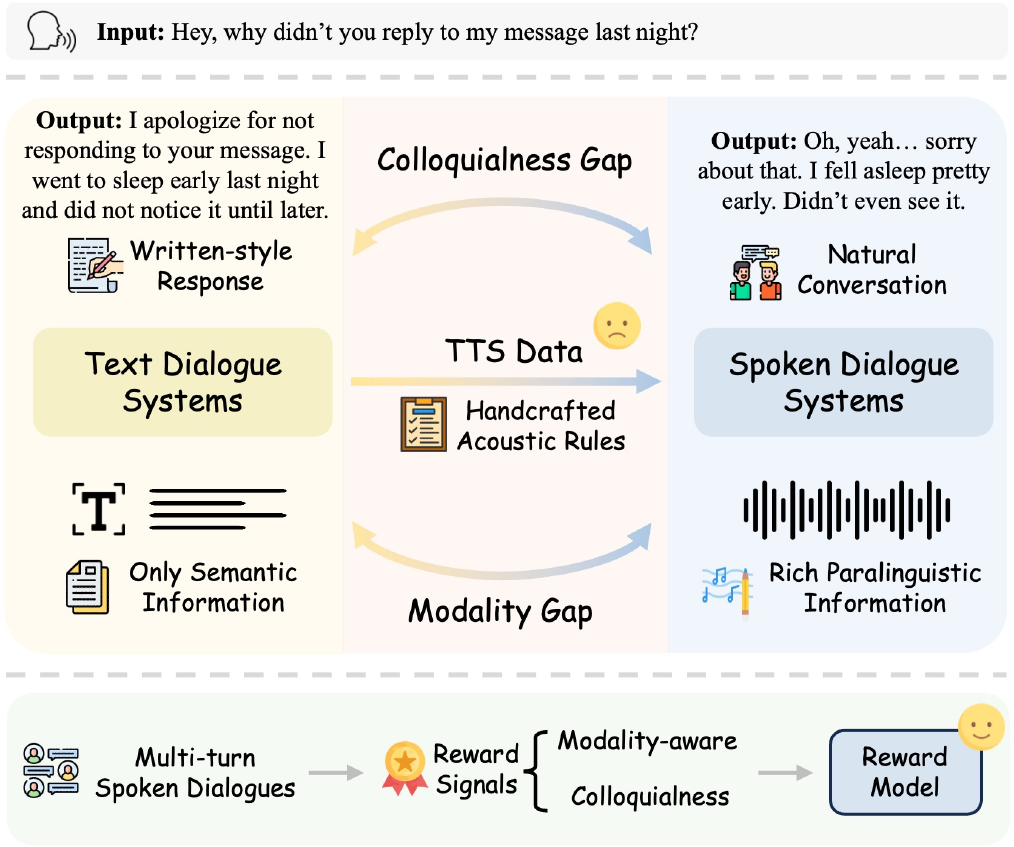
SDiaReward 研究框架:口语对话中的 Modality Gap 与 Colloquialness Gap
图源:论文Figure 1。SDiaReward 聚焦口语对话系统中的两类核心差距:语音模态中的韵律、情绪等副语言信息,以及真实口语表达与书面化回答之间的风格差异。
⏩论文信息
论文题目:SDiaReward: Modeling and Benchmarking Spoken Dialogue Rewards with Modality and Colloquialness
录用会议:ACL 2026 Main Conference
作者:Jingyu Lu, Yuhan Wang, Fan Zhuo, Xize Cheng, Changhao Pan, Xueyi Pu, Yifu Chen, Chenyuhao Wen, Tianle Liang, Zhou Zhao
单位:Zhejiang University
⏩摘要
随着端到端口语对话系统的发展,语音智能体不再只是将语音转写为文本、在文本空间中完成理解和生成,而是开始直接建模语音输入与语音输出。相比传统文本对话,口语对话包含更多非文本信息,例如韵律、情绪、停顿、语速、语气以及说话风格。这些信息会显著影响人类对对话质量的判断,但现有自动评测方法往往难以充分捕捉。
本文指出,当前口语对话评测主要面临两个关键缺口:一是modality gap,即文本评测器难以感知语音模态中的韵律、情绪和声学自然度;二是colloquialness gap,即许多文本优化后的回答虽然语义正确、句式完整,但真正说出来时会显得过于书面化、脚本化,缺乏自然口语对话中的简短表达、片段化结构和互动性。
为解决上述问题,论文提出SDiaReward,一个端到端多轮语音对话奖励模型。模型直接输入完整多轮语音episode,并通过成对偏好学习同时建模语音模态自然度和口语化程度。实验表明,SDiaReward 在 ESDR-Bench 上显著优于通用音频大模型和现有语音评测模型,其中 SDiaReward-7B 在整体偏好判断上达到96.70% Micro Accuracy。
⏩背景:为什么口语对话需要新的Reward Model?
近年来,大语言模型推动了文本对话系统的快速发展。与此同时,语音对话模型也从传统级联系统逐渐走向端到端框架。新一代口语对话系统希望模型能够直接“听懂”用户语音,并以自然语音进行回复。
但这带来了一个基础问题:我们应该如何评价一个口语对话系统的输出是否好?
在文本对话中,常见做法是训练reward model 或使用 LLM-as-a-judge,对回答的相关性、连贯性、帮助性等进行打分。然而,语音对话的质量不只取决于文字内容。两段语音可以拥有完全相同的文本转写,但由于韵律、情绪、停顿和音色表现不同,人类听感可能完全不同。
例如,一个回答在文字上是“好的,我明白了”,但说话方式可能有明显差异:有的自然、有情绪、有互动感;有的平铺直叙、像朗读脚本;有的虽然音质干净,却缺少真实对话中的停顿和语气变化。文本评测器很难区分这些差异。
另一方面,很多由文本模型生成的回答本身就偏书面化。它们在屏幕上读起来合理,但在语音场景中听起来会显得冗长、正式、不像真实对话。例如真实口语中经常出现省略、语气词、短句、修正和轻微重复,而书面式回答往往过于完整和规整。
因此,口语对话系统的reward model 需要同时回答两个问题:
这段语音是否在声学和表达层面自然?
这段回复是否像真实口语对话,而不是书面稿朗读?
⏩方法概览:SDiaReward 做了什么?
SDiaReward 是一个面向多轮口语对话的端到端奖励模型。与只评估单句 TTS 质量或依赖 ASR 转写的级联系统不同,SDiaReward 直接处理完整的多轮语音 episode,并输出标量 reward score。
模型关注两个主要维度:
1. Modality-Awareness:模态感知能力
该维度关注语音本身是否自然,包括韵律、情绪、声学自然度、说话风格以及跨轮对话中的表达一致性。对于两段文本内容相同的语音,模型需要判断哪一段更接近真实自然的人类语音。
2. Colloquialness:口语化程度
该维度关注回复是否符合自然口语表达。模型需要区分偏书面化、脚本化的表达和更自然、更具互动感的口语表达。
在建模上,SDiaReward 基于多模态大模型骨干,将交错的语音和文本对话上下文映射到统一表示空间,并通过 pooling 与 score head 输出奖励分数。形式上,模型对完整上下文和候选回复进行编码,然后输出r(C, y)作为该回复在当前多轮对话上下文中的reward。
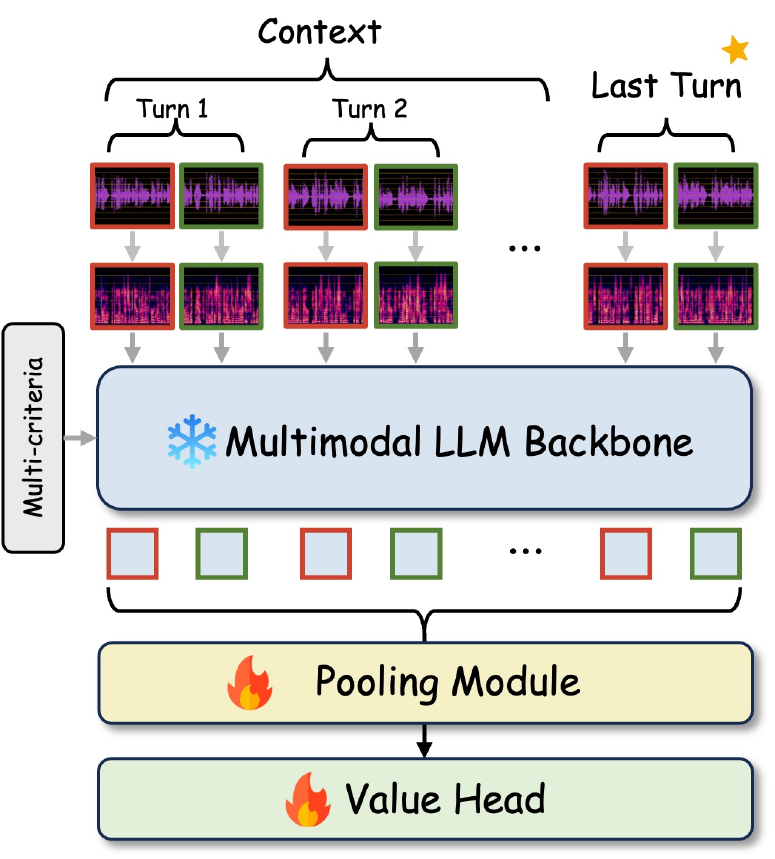
SDiaReward 模型架构
图源:论文Figure 3。模型输入完整多轮上下文和最后一轮候选回复,经多模态 LLM Backbone 编码后,通过 Pooling Module 与 Value Head 输出奖励分数。
⏩数据集:SDiaReward-Dataset
为了训练口语对话reward model,论文构建了SDiaReward-Dataset。该数据集包含约13k episode-level preference pairs,总计约200 小时配对语音,覆盖真实对话、半真实对话、脚本化语音和口语化改写等多种场景。
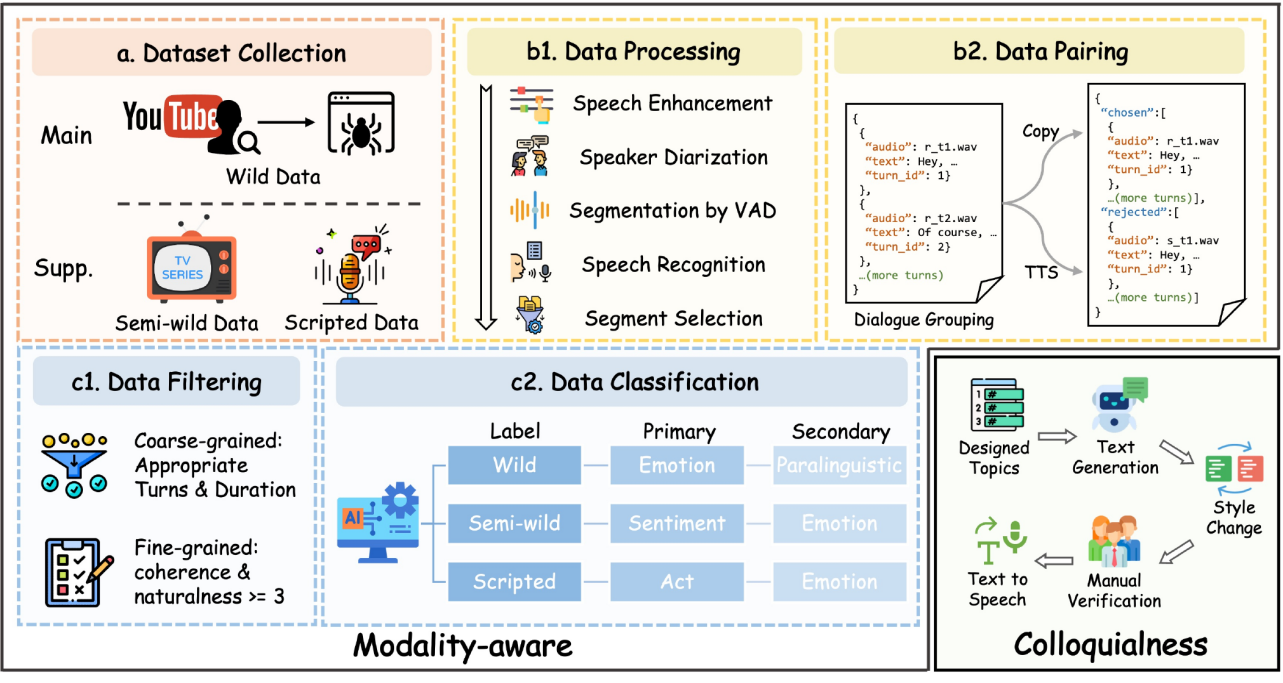
SDiaReward-Dataset 构建流程
图源:论文Figure 2。数据构建从多来源口语对话采集出发,分别生成 modality-aware pairs 与 colloquialness pairs,并通过后处理与元信息标注形成训练数据和分层评测基准。
数据主要分为两类:
1. Modality-aware pairs
这一部分用于训练模型识别语音模态自然度。构造方式是将真实人类语音与基于同一文本内容生成的TTS 语音进行配对。由于文本内容保持一致,模型不能依赖语义差异进行判断,而必须关注韵律、情绪、声学细节和自然度。
数据来源进一步分为:
Wild:来自真实网络长对话,包含自然噪声和真实多人互动;
Semi-Wild:来自带有表演属性的情绪对话数据;
Scripted:来自录音室环境下的高质量脚本化语音。
2. Colloquialness pairs
这一部分用于训练模型识别口语化表达。论文设计了多个对话场景,先生成书面风格多轮对话,再改写为口语风格版本。两个版本在语义上保持一致,并使用相同TTS 配置进行合成,从而尽量避免音质差异干扰模型判断。这样,偏好标签主要反映表达风格是否自然口语化。
⏩评测基准:ESDR-Bench
论文进一步构建了ESDR-Bench,用于系统评估口语对话reward model 的能力。与简单随机划分不同,ESDR-Bench 采用分层采样策略,按照数据来源和多维元信息进行平衡,以避免评测结果被高频数据类型主导。
这一设计很重要。真实口语对话中的数据分布非常复杂,不同数据域的声学条件、说话风格和对话结构差异很大。如果评测集只集中在某一类数据上,模型可能学到局部捷径,而不是真正具备跨场景泛化能力。ESDR-Bench 的目标就是更稳健地评估模型在不同语音对话条件下的偏好判断能力。
⏩实验结果
在ESDR-Bench 上,SDiaReward 显著优于通用音频大模型、开源音频语言模型、现有语音评测器以及级联系统。
Model | Modality Micro | Colloquialness | Overall Micro |
GPT-4o Audio | 51.12 | 98.00 | 57.91 |
Gemini 2.5 Pro | 72.63 | 98.80 | 76.42 |
Kimi-Audio | 65.30 | 66.00 | 65.40 |
Qwen 2.5 Omni 7B | 51.85 | 49.20 | 51.47 |
SDiaReward 3B | 88.62 | 92.00 | 89.11 |
SDiaReward 7B | 96.61 | 97.20 | 96.70 |
可以看到,通用音频大模型在口语化判断上表现较强,尤其是Gemini 2.5 Pro 和 GPT-4o Audio 在 Colloquialness 上接近饱和。这说明“口语化表达”往往可以部分从语言风格中推断出来。但在 Modality 任务上,差距非常明显。该任务要求模型在文本内容相同的情况下区分真实人类语音与合成语音,因此更依赖对韵律、情绪、停顿和自然度的感知。GPT-4o Audio 在该任务上接近随机水平,Gemini 2.5 Pro 也只有 72.63%,而 SDiaReward-7B 达到 96.61%。这表明,专门面向口语对话训练的 reward model 对语音模态细节有明显优势。
⏩泛化分析
为了验证SDiaReward 是否只是学习了特定 TTS 系统的合成痕迹,论文还使用未见过的 TTS 引擎进行 OOD 测试,包括 OpenAI TTS、CosyVoice 2 和 FireRedTTS-2。
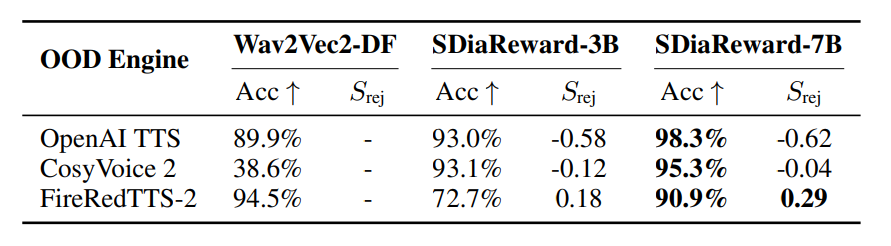
域外TTS 引擎下的模态判别准确率与合成语音奖励分数
结果显示,SDiaReward-7B 在这些未见 TTS 引擎上仍保持较高准确率:OpenAI TTS 为 98.3%,CosyVoice 2 为 95.3%,均显著超越Wav2Vec2-Deepfake。仅在FireRedTTS-2 这一组域外测试中,Wav2Vec2-Deepfake(94.5%)的识别准确率略高于 SDiaReward-7B(90.9%)。
这说明SDiaReward 并不只是依赖低层声学瑕疵进行判断,而是在一定程度上学习到了更高层的对话表达自然度和副语言偏好。
除此之外,实验还观测到一项极具价值的发现:FireRedTTS-2 本身是面向多轮对话设计、具备上下文感知能力的对话型 TTS,SDiaReward 对其生成语音分配的平均拒绝奖励分数为 0.29,显著高于单轮通用 TTS 引擎 ——GPT-4o-mini TTS(-0.62)、CosyVoice 2(-0.04)。二者分数差值更小,代表模型认为FireRedTTS-2 的语音表达更贴合多轮对话语境、自然度更高。这一现象直接证明 SDiaReward 能够捕捉语音与对话上下文之间的匹配关系,具备区分 “上下文适配语音” 与 “无语境单句朗读语音” 的高阶感知能力。
⏩消融实验
论文还比较了不同pooling 策略和训练目标设计。结果显示,Mean Pooling 在稳定性和准确率之间取得了最好平衡。对于 7B 模型,Mean Pooling 达到 96.70% Overall Micro,而 Last Hidden 和 Attention Pooling 表现明显较低。
此外,论文引入center loss 来缓解 reward score 漂移问题。加入 center loss 后,模型整体准确率从 95.37% 提升到 96.70%,同时 reward 分布更加稳定。这对于后续将 reward model 用于重排序、偏好优化或强化学习具有实际意义。
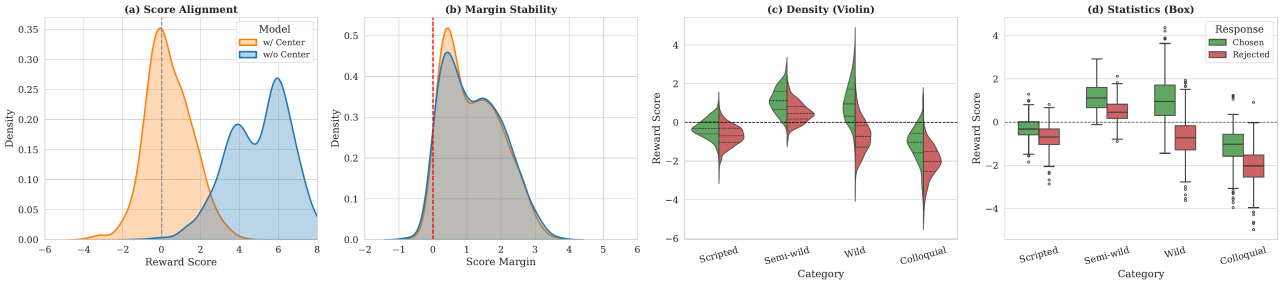
SDiaReward-7B 消融与分数分布分析
图源:论文Figure 4。Center loss 能稳定 reward 分数分布;不同数据域上的分数范围也显示,模型学习到的是相对偏好与表达自然度,而不只是简单的音频伪造痕迹。
⏩工作意义
SDiaReward 的核心价值在于,它把口语对话评测从“看文本是否合理”推进到了“听表达是否自然”。
对于端到端口语对话系统而言,文本语义只是质量的一部分。一个真正自然的语音智能体,需要在多轮上下文中保持语义连贯,同时具备合适的韵律、情绪、停顿、语气和口语化表达。SDiaReward 提供了一个可训练、可评测、可复现的 reward modeling 框架,为后续口语对话模型的自动评测、数据筛选、候选回复重排序和偏好对齐提供了基础工具。
同时,论文也提醒我们,通用音频大模型并不天然等价于可靠的语音对话评测器。即使模型可以理解音频内容,也未必能够稳定判断细粒度的语音表达质量。针对任务构建偏好数据和评测基准,仍然是口语对话系统走向可靠优化的重要步骤。
⏩资源
⏩BibTeX
@inproceedings{lu2026sdiareward,
  title={SDiaReward: Modeling and Benchmarking Spoken Dialogue Rewards with Modality and Colloquialness},
  author={Lu, Jingyu and Wang, Yuhan and Zhuo, Fan and Cheng, Xize and Pan, Changhao and Pu, Xueyi and Chen, Yifu and Wen, Chenyuhao and Liang, Tianle and Zhao, Zhou},
  booktitle={Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers)},
  pages={4006--4028},
  year={2026}
} 