
 语音小管家
亮点速看
1. 根据语境动态调整语气与情感表达,支持音色克隆,告别机械朗读感;
2. 内置多模态双工控制模型,支持声纹级背景过滤,嘈杂环境下对话依然流畅,不易被打断;
3. Artificial Analysis 子项中综合排名第一,超越 OpenAI GPT-Realtime-2;
4. 支持动态工具调用,可完成路线规划、信息查询等任务,不止是聊天。
▎高表现力与共情对话
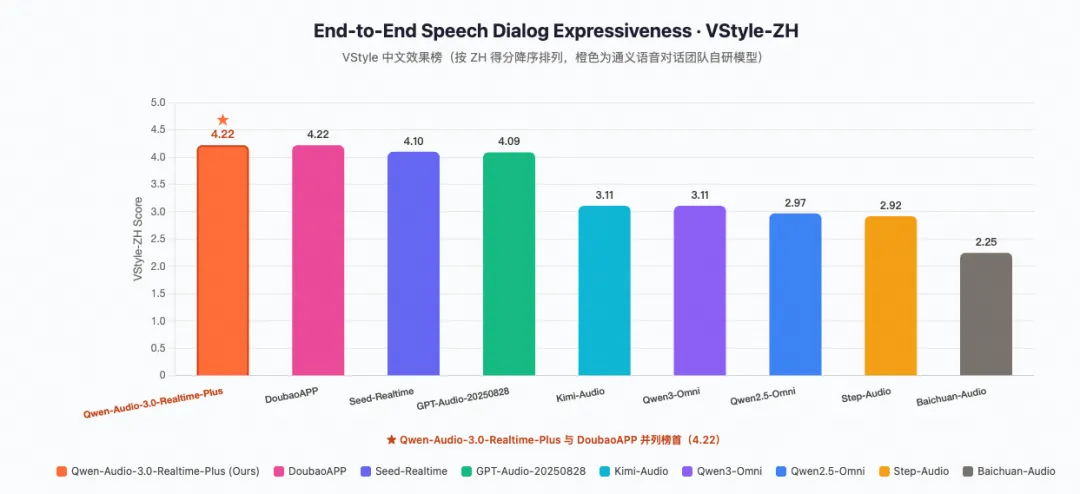
在激烈的辩论场景中,准确理解对方论点、快速组织反驳逻辑,同时保持口语化表达和适当的语气强度。 角色扮演时,能根据设定的角色(如历史人物、职业身份等)调整说话风格、用词习惯和情感表达,并响应显式指令进行风格切换。 在情感陪伴中,当你倾诉烦恼或分享喜悦时,通过语调、节奏和内容表达共情,提供温暖的情感支持。
这些表现的背后,是团队在生成侧的深度优化:
情感感知生成:识别你的情绪状态,并给予有温度的共情回应。 韵律动态调整:根据语义重点与对话节奏,自动调整语速、停顿、重音等韵律特征。 副语言信息处理:能够理解和生成笑声、叹息、犹豫等非语言声音信号,还原真人交流的细腻。 个性化风格适配:一秒切换专属说话风格,完美演绎你设定的任何角色。
▎流畅双工交互
嘈杂背景环境下的双工对话:在餐厅、开放工区等嘈杂环境中,不受干扰,精准锁定你的声音。 多人交谈不打断:在多人讨论中,准确识别主对话对象,不被旁听者干扰。 多说话人智能切换:根据上下文和语义线索,智能判断当前对话对象,在不同说话人间自然切换。
这些自然倾听的背后,是团队在控制侧的重构:
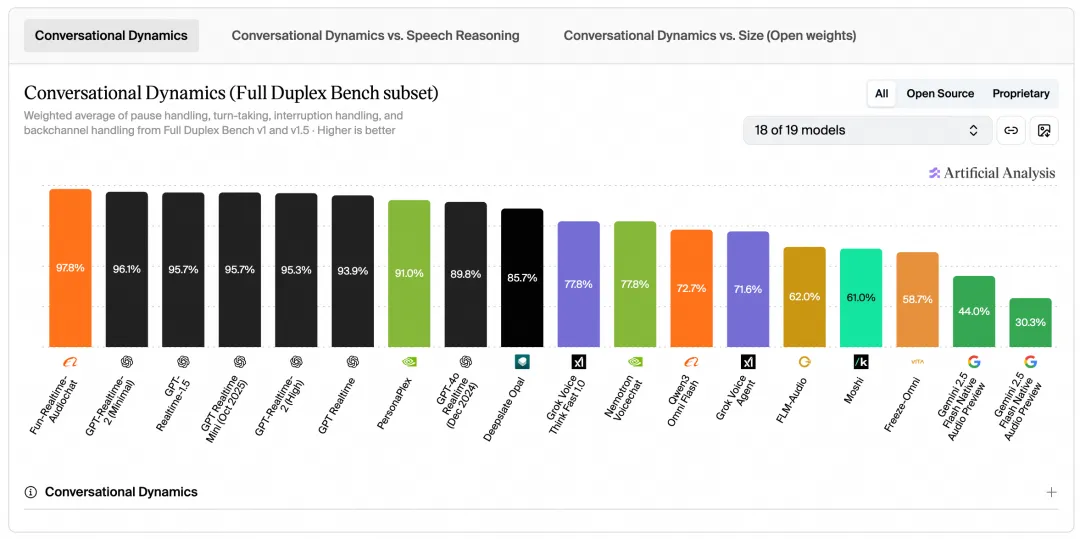
注:上图评测基于 Qwen-Audio-3.0-Realtime 的 Preview 版本 Fun-Realtime-AudioChat 提交。
▎不止于聊天:Agentic 与动态工具调用
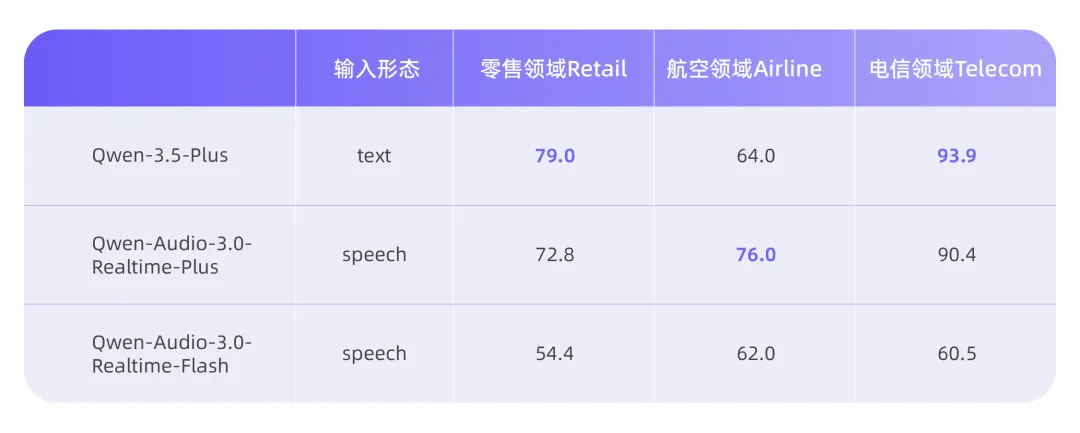
动态工具路由:深刻理解你的意图,无需显式指令即可自动调用合适工具。
多工具协同:支持同时注册多个工具,根据任务复杂度灵活组合。
上下文感知:工具返回的结果自动融入对话记忆,让多轮辅助对话如丝般顺滑。
只需一句话,它就能帮你搞定本地生活的路线规划与餐厅推荐,或是查询实时新闻与股票行情;它甚至能直接接管复杂的任务执行与数据分析,如日程安排、表格查询,让语音真正成为你的超级助理。
▎底座支撑:同时兼顾“快”与“聪明”为了兼顾复杂推理与快速对话,同时解决“语音模型智商衰减”这一痛点,团队在底层架构上进行了创新。
为了兼顾复杂推理与快速对话,同时解决“语音模型智商衰减”这一痛点,团队在底层架构上进行了创新。
On-Policy Distillation 与多教师蒸馏
团队采用On-Policy Distillation框架,将文本大模型的完整推理能力蒸馏至语音模型。同时引入多教师蒸馏策略,确保模型在各个维度“不偏科”:
口语多轮偏好教师保证口语化表达偏好与指令遵循;
通用教师保证基本问答和推理能力;
Agentic教师保证工具调用与复杂任务执行;
音频理解教师负责音频及副语言信息对话及推理。
此外,Qwen-Audio-3.0-Realtime提供了针对日常问答等极度敏感时延的场景,直接生成回复,实现毫秒级响应。
得益于此,Fun-Realtime-AudioChat 在全球权威评测 Artificial Analysis 的Speech Reasoning(语音推理)子项中取得了综合排名第一的成绩。
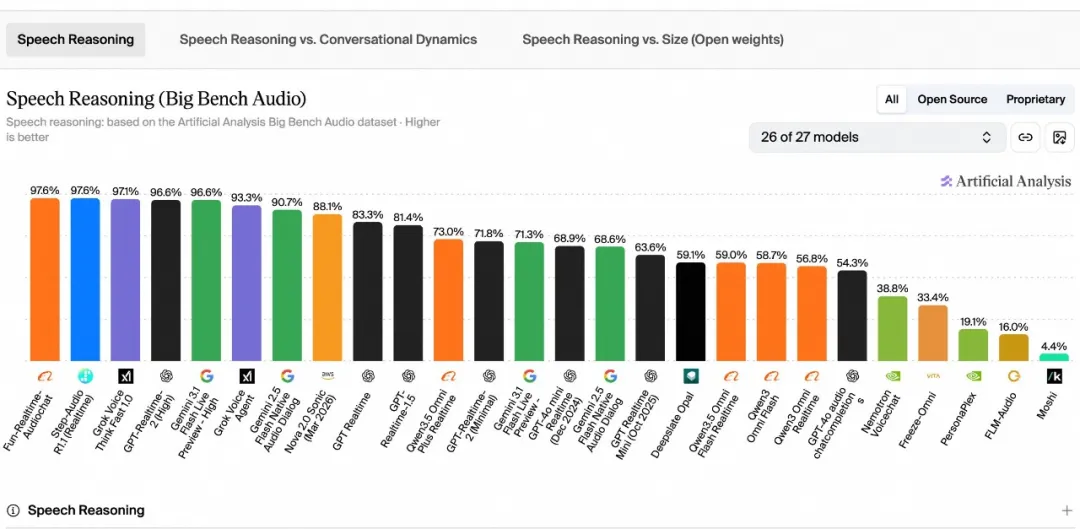
注:上图评测基于 Qwen-Audio-3.0-Realtime 的 Preview 版本 Fun-Realtime-AudioChat 提交。
在 VoiceBench(验证事实准确性与知识检索)和 AudioMultiChallenge(验证多轮指令遵循)等主流基准测试中同样表现优异:
VoiceBench:在业界主流的语音问答基准测试中表现优异,验证了模型在开放域问答、知识检索、事实准确性等方面的能力。(plus:标准prompt-92.5,口语prompt-90.5 ,下降2.0;flash:标准prompt-89.8,口语prompt-87.5,下降2.4)
AudioMultiChallenge:在多轮音频对话挑战赛中展现出色的指令遵循能力和上下文理解能力(plus:标准prompt-44.0,口语prompt-37.6,下降6.4;flash:标准prompt-43.6,口语prompt-38.1,下降5.5)
这证明了它不仅能“听见”,更能“听懂并深度思考”。
地址:
