
 语音小管家
当前,大音频语言模型(LALM)在端到端说话人日志与识别任务中展现出优异性能。但受大规模对话语料稀缺、缺少显式说话人表征优化机制限制,模型的说话人区分能力仍存在短板。现有提升大音频语言模型说话人精度的主流方法,无论是引入额外编码器、设计注册机制还是采用后处理优化,大多依赖于网络结构扩充或推理阶段的外部干预,并未在模型内部显式优化说话人表征,导致说话人身份建模仍停留在隐式层面,当训练语料不足或说话人音色高度相似时,其区分效果会急剧下降。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)和 Soul APP、上海交通大学合作论文“Joint Learning Global-Local Speaker Classification to Enhance End-to-End Speaker Diarization and Recognition”被语音旗舰会议Interspeech 2026接收。 该论文提出了GLSC- SDR——一种联合学习学习范,通过联合全局-局部说话人分类以促进说话人日志与识别能力,通过一套基于大语言模型、融合说话人日志(SD)与语音识别(ASR)的统一多说话人转写框架。文章借鉴说话人验证领域通过度量学习和间隔损失显式规整嵌入空间以增强类内紧凑性与类间区分度的成功经验,提出在大音频语言模型的训练流程中直接引入显式的说话人监督信号,从而在模型内部弥补隐式建模的不足,从根本上提升对音色相近说话人的区分能力。 GLSC-SDR 将说话人分类任务与分轨、识别任务联合训练;进一步设计全局 - 局部说话人分类(Global-Local Speaker Classification, GLSC)策略:以聚类后的说话人作为全局标签,对簇内说话人重新编码得到局部标签。该分层设计在保证文本转录准确率的同时,提升细粒度说话人区分能力。 在 AliMeeting、AISHELL-4、AMI-SDM 三大数据集上的实验表明:无需大规模真实对话数据,GLSC-SDR 相比基于仿真、多编码器的主流方案,性能持平或更优。
论文题目:Joint Learning Global-Local Speaker Classification to Enhance End-to-End Speaker Diarization and Recognition
作者列表:戴宇航、林浩鹏、钱家乐、延瑞琦、孟浩、解晗轲、温翰林、尹顺顺、陶明、陈谐、谢磊、王新升
合作单位:Soul APP、上海交通大学
论文预印版:https://arxiv.org/abs/2603.25377
背景动机
多人对话转录需要解决 “谁在何时说了什么” 这一核心问题,该任务统称为说话人分轨与识别(Speaker Diarization and Recognition, SDR)。真实对话存在频繁话轮切换、语音重叠、声学环境多变等问题,精准区分语音归属是一大难点。传统 SDR 系统采用流水线级联架构,依次完成语音活动检测(VAD)、说话人验证(SV)、自动语音识别(ASR)。该方案模块清晰、可解释性强,但存在误差传递、系统复杂度高的缺陷。近年大音频语言模型(LALM)实现统一端到端多人语音处理,可一次性生成包含时间戳、说话人标签、转录文本的结构化序列,实现多任务联合建模。现有工作通过扩展 LALM 框架提升说话人归属精度:TagSpeech [1] 额外引入说话人编码器与时域锚定策略,优化细粒度时间戳与说话人标签预测;SpeakerLM [2] 设计说话人注册机制,强化跨片段身份一致性;还有部分工作采用后处理方案 [9,10],利用大语言模型优化分轨输出、提升文本可读性。上述方法虽能优化多人转录效果,但大多依靠网络结构扩充或推理阶段后处理,并未在模型内部显式优化说话人表征。最终说话人身份建模仍为隐式建模,学习到的表征难以满足 “同一声源特征紧凑、不同声源特征可分” 的要求 —— 当训练对话语料不足、或存在音色高度相似的说话人时,区分效果会大幅下降。为解决现有端到端模型说话人区分能力不足的问题,本文借鉴说话人验证(SV)领域的发展思路。过去十年,说话人验证从统计建模演进至深度表征学习;当前主流模型在 ResNet、ECAPATDNN 等网络中引入度量学习、间隔损失,显式规整嵌入空间,学习到的说话人表征具备更强类内紧凑性与类间区分度,对未见过的说话人泛化效果更好。受上述进展启发,本文认为:尽管 LALM 依托强大主干网络,在语音识别、语义建模上表现出色,但其说话人表征学习全程隐式建模,在复杂对话场景下难以区分音色相近的说话人。为弥补该缺陷,本文在 LALM 训练流程中引入显式说话人监督信号,将说话人分类损失纳入训练目标。
为解决现有端到端模型说话人区分能力不足的问题,本文借鉴说话人验证(SV)领域的发展思路。过去十年,说话人验证从统计建模演进至深度表征学习;当前主流模型在 ResNet、ECAPATDNN 等网络中引入度量学习、间隔损失,显式规整嵌入空间,学习到的说话人表征具备更强类内紧凑性与类间区分度,对未见过的说话人泛化效果更好。
受上述进展启发,本文认为:尽管 LALM 依托强大主干网络,在语音识别、语义建模上表现出色,但其说话人表征学习全程隐式建模,在复杂对话场景下难以区分音色相近的说话人。为弥补该缺陷,本文在 LALM 训练流程中引入显式说话人监督信号,将说话人分类损失纳入训练目标。 本文提出全局 - 局部说话人分类联合说话人分轨识别框架(GLSC-SDR),分层说话人分类与 SDR 任务联合优化。该方案在保留端到端建模能力的同时,提升 LALM 的说话人区分性能,实现复杂对话语音更精准的多人转录与声源追踪。
值得注意的是,近期实验室和Soul也联合开源了多说话人语音转录方案SoulX-Transcriber,受到广泛关注。
SoulX-Transcriber:面向复杂对话的端到端多说话人语音转录框架
开源网址:https://github.com/Soul-AILab/SoulX-Transcriber
提出的方法
提升模型区分不同说话人的能力是 SDR 任务的核心需求。本文方法核心创新为分层全局 - 局部说话人分类机制,与说话人日志与识别任务联合优化。 区别于传统单层分类方案,GLSC 采用 “宏观声学聚类 + 微观个体识别” 思路:强制模型在输入表征层面同时学习跨片段全局一致性与细粒度局部区分能力。该设计通过隐式课程学习缓解大规模分类任务过拟合,同时大幅提升模型对复杂多人场景声学差异的敏感度。 关键优势:仅通过多任务联合约束即可取得显著性能提升,无需额外网络模块(整体架构见图 1)。
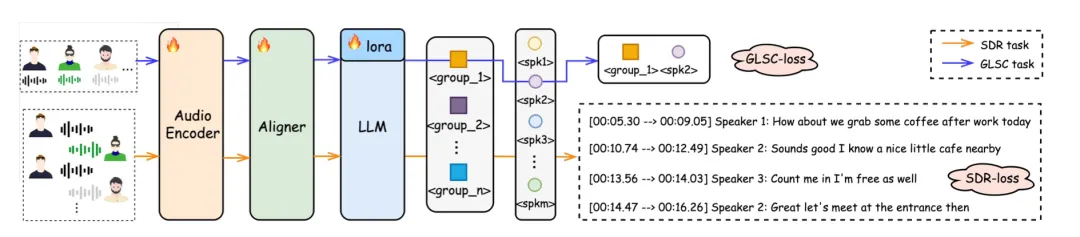
图1: GLSC- SDR训练范式架构图
问题定义
本文 GLSC-SDR 框架目标是提升多人音频 SDR 任务效果。给定原始波形 S,SDR 任务输出结构化序列O=(o1,o2,...,ol)包含时间戳、说话人标签、转录文本。标准 LALM 虽可建模该序列,但在复杂多人场景下说话人区分能力有限。
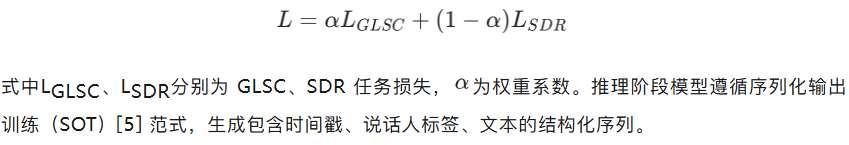
为优化 SDR 效果,本文在 LLM 内部新增 GLSC 专项训练任务:对单段音频生成一组说话人标签,每组标签包含全局聚类标签Lg、簇内局部说话人 IDLu。该任务显式引导模型学习细粒度说话人差异与聚类层级一致性,间接提升 SDR 任务的声源归属精度。 训练阶段,GLSC、SDR 任务均序列化统一序列格式,通过专属任务 token 区分两类任务;GLSC 序列仅使用单说话人片段样本,而非完整对话数据。 整体联合训练损失函数定义:
传统说话人分轨方法仅依靠局部两两区分,缺少跨片段全局视角,在开放场景下表征鲁棒性不足;而朴素全局说话人分类将每个说话人 ID 作为独立类别(单层分类),面对音色高度相似人声、噪声标签时极易过拟合,学习到的表征空间泛化能力差。 因此,端到端 SDR 系统的核心瓶颈在于:构建全局一致的说话人表征空间,同时缓解过拟合、精准区分音色相近个体。
针对上述痛点,本文提出 GLSC 分层框架,解决传统 SDR 局部视角局限、单层全局分类在海量 / 音色近似说话人场景下的过拟合问题。 GLSC 摒弃将说话人 ID 视作独立类别单层建模的思路,采用分层建模:先宏观聚类,后微观识别,学习目标拆分为两级:
全局粗粒度标签:基于声学特征无监督聚类生成,引导模型捕捉音色、韵律等底层声学共性,构建抗噪、稳定的特征空间;
局部细粒度标签:在每个全局 “超类” 内部区分独立说话人,保证模型掌握宏观聚类规律后,仍能感知相似人声的细微差异。
该分层设计融合无监督聚类与有监督识别优势,形成隐式课程学习机制:训练前期避免模型过度拟合个体细节,显著提升开放场景下表征空间的泛化能力与区分度。
GLSC 数据构建流程
为支撑 GLSC 训练,本文设计一套完整数据预处理与标签生成流水线(见图 2):
依据原始数据集时间戳切分音频,提取无重叠单说话人语音片段;
采用 ASR 模型做质量过滤:字错误率 WER>30% 或插入错误超过 2 条的片段判定为重叠语音 / 串音噪声,直接丢弃;
使用预训练说话人模型,对剩余高质量片段提取说话人嵌入特征。
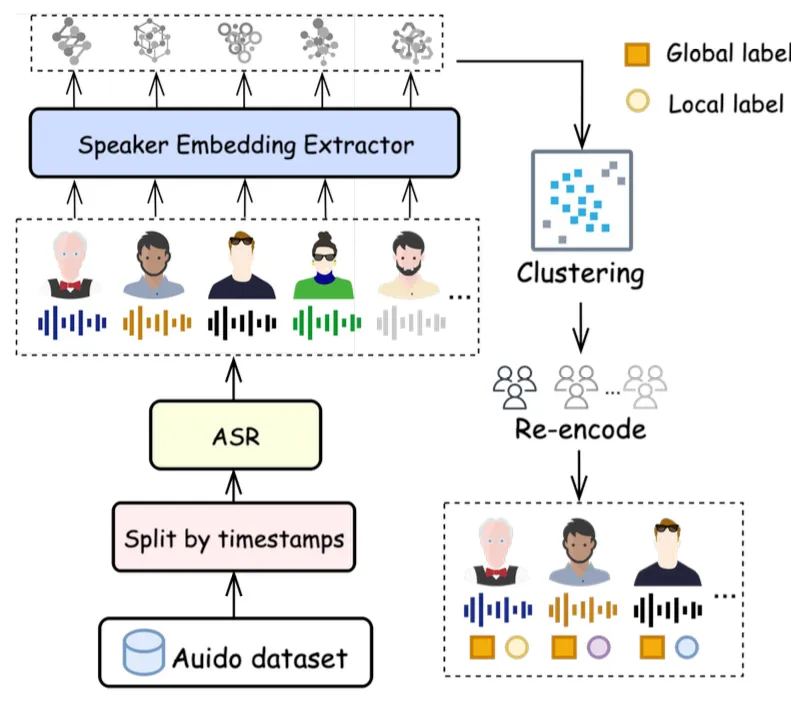
图 2: GLSC数据构建流水线,包括音频数据集搭建→按时间戳切分→ASR 质量过滤→说话人嵌入提取→聚类生成全局标签、簇内重编码生成局部标签
分层标签构建流程:
采用 HDBSCAN [8] 对全部说话人嵌入做无监督聚类,合并质心余弦相似度高于 0.75 的聚类簇;剔除离群噪声样本后,得到宏观簇 ID,作为全局分类任务标签Lg; 为精细建模音色相似说话人,对每个聚类簇内不同说话人顺序编码,生成局部标签Lu; 拼接Lg与Lu,得到复合 GLSC 标签,用于多任务联合优化。
数据集
本文在三套主流多人会议评测数据集开展实验:AMI [9]、AliMeeting [10]、AISHELL-4 [11]。AMI 为英文会议语料;AliMeeting、AISHELL-4 为中文远场会议数据集。
AMI 数据集:采用单远场麦克风子集(SDM);
AliMeeting、AISHELL-4:使用 8 通道麦克风阵列第一通道录音。
各数据集独立训练、评测,保证对比公平。 数据预处理沿用前人工作方案 [7,24]:基于话轮分组切分音频,将无时间间隙的连续说话片段合并为单条训练样本,保留对话上下文连贯性。
模型配置与训练细节
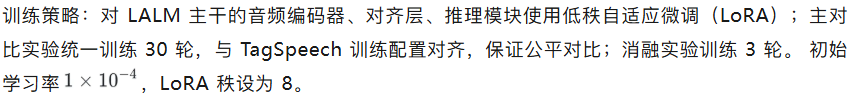
使用到的模型:
说话人嵌入提取模型:ERes2Net [12];
LALM 主干:Qwen2.5-Omni-7B [7],音频 - 语言对齐能力强、支持长上下文建模,适配复杂多人对话场景。
评测指标
SDR 任务要求模型同时输出准确文本、正确匹配每句话对应的说话人,本文采用以下指标评估:
字错误率 WER:按时间顺序拼接全部语句,忽略说话人身份计算,仅评估纯语音识别效果;
拼接最小置换字错误率 cpWER:同时衡量识别与声源归属精度。先将同一说话人全部语句拼接,再遍历预测说话人与真值说话人所有置换组合,取最小 WER 作为结果;
归属误差差值∆cp:cpWER 与 WER 的差值,代表声源匹配错误引入的额外误差,可独立衡量分轨性能,不受文本识别误差干扰;
说话人数量准确率 SCA:预测说话人总数与真值完全一致的样本占比。
实验结果与分析
本文通过多组实验全面验证 GLSC-SDR 框架。首先与现有 SOTA 方案对比,证明本文方法在声源归属、文本转录精度上的优势;随后开展消融实验,验证分层分类策略有效性,分析聚类参数对模型性能的影响。实验结果证明,GLSC 可在保证文本语义完整的前提下,显著提升说话人区分鲁棒性。
主实验结果
表 1 汇总 GLSC-SDR 与多个主流基线在 AliMeeting、AISHELL-4、AMI-SDM 三套数据集上的性能。为构建严谨基线,本文在对应数据集上微调原生 Qwen2.5-Omni(记作 Qwen2.5-Omni-SFT),验证标准监督微调的效果。 整体来看,GLSC-SDR 在所有端到端方案中达到 SOTA 水平,声源归属精度与系统鲁棒性优势明显。
表 1:AliMeeting、AISHELL-4、AMI-SDM 主要实验结果(* 代表结果引自文献 [6]) 指标:WER(越低越好)、cpWER(越低越好)、∆cp(越低越好)、SCA(越高越好),对比基线:TagSpeech、ViebVoice-ASR [6]、Gemini-2.5-pro、Gemini-3-pro、原生 Qwen2.5-omni、微调 Qwen2.5-omni-sft和本文方案 GLSC-SDR
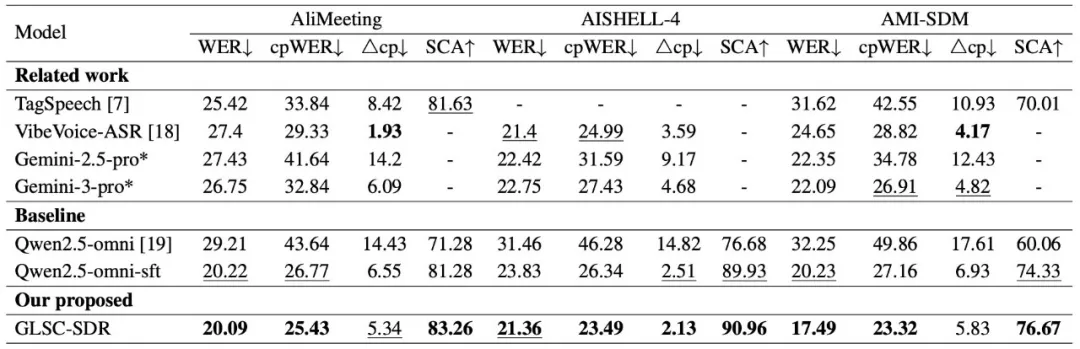
原生 Qwen2.5-Omni 在 AliMeeting 数据集效果极差,证明未做声源优化的 LALM 在多人场景区分能力不足;任务专属微调(Qwen2.5-Omni-SFT)虽有提升,但声源归属精度仍弱于本文方法。这说明简单微调不足以实现稳定的说话人区分,而 GLSC 策略提供针对性建模约束。
同时 GLSC 实现文本转录(WER)与声源归属(∆cp、SCA)效果平衡:保留 LALM 原有语义建模优势,声源归属误差相对基线降低 18.47%,说话人数量预测准确率 SCA 超越 TagSpeech;且全程无需大规模真实对话语料、复杂多编码器结构。
分类策略消融分析
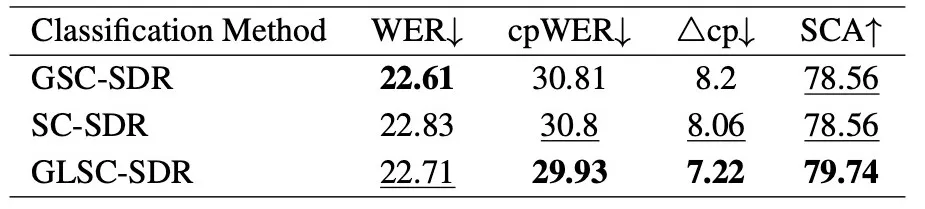
为验证 GLSC 有效性,本文探究两个核心问题:①仅保留单层全局 / 局部分类能否达到同等效果;②直接使用原始说话人标签单层分类效果如何。 表 2 实验证明,GLSC 分层方案性能优于仅全局分类(GSC)、单层原始标签分类(SC)。
仅全局分类(GSC):∆cp 数值高,声源归属误差大,仅靠聚类簇无法区分簇内不同说话人;
单层直接说话人分类(SC):文本识别 WER 最差,缺少全局声学约束,跨片段说话人一致性建模能力受损;
GLSC 分层方案:∆cp 最低、SCA 最高,证明 “先全局聚类、后局部细粒度区分” 分层范式可同时兼顾跨片段全局一致性与细粒度人声区分能力。
表 2:AliMeeting 数据集下不同说话人分类方案对 SDR 效果的影响
聚类数量与聚类算法影响
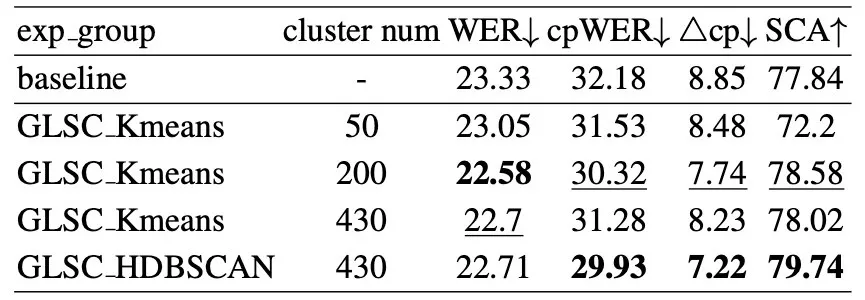
本文进一步分析聚类算法、聚类粒度对 GLSC-SDR 性能的影响(表 3)。聚类簇数量、聚类算法均会显著改变模型效果:基于密度的 HDBSCAN 在全部指标上持续优于 K-means [13]。 原因:HDBSCAN 天然适配说话人特征非均匀分布特性,有效抑制离群噪声干扰;K-means 对初始聚类中心敏感,易出现簇内特征混杂。
聚类粒度同样关键:并非聚类数量越多效果越好,200 簇时取得最优结果。
聚类数量过少:簇内人声混杂,细粒度区分能力下降,声源归属误差上升;
聚类数量过多:簇内样本冗余,模型难以学习通用区分表征,cpWER 指标恶化。
表 3:AliMeeting 数据集下聚类数量、聚类算法对 GLSC 效果的影响
结论
本文提出 GLSC-SDR 分层全局 - 局部说话人分类联合语音分轨识别框架,提升基于 LALM 的 SDR 系统说话人区分能力与转录精度。 在 AliMeeting、AISHELL-4、AMI-SDM 数据集上的大量实验证明:相比现有 SOTA 方案,GLSC-SDR 持续取得持平或更优性能,声源归属、说话人数量预测效果提升显著。 依托分层全局 - 局部分类机制与联合训练策略,该方案在不损失底层 LALM 文本转录能力的前提下,有效降低声源匹配错误。重要的是,性能提升无需依赖大规模真实对话语料、复杂多编码器网络,是一套实用、易扩展、高效的端到端多人 SDR 解决方案。
参考文献
[1] M. Huo, Y. Shao, and Y. Zhang, “Tagspeech: End-to-end multispeaker asr and diarization with fine-grained temporal grounding,” arXiv preprint arXiv:2601.06896, 2026.
[2] H. Yin, Y. Chen, C. Deng, L. Cheng, H. Wang, C.-H. Tan, Q. Chen, W. Wang, and X. Li, “Speakerlm: End-to-end versatile speaker diarization and recognition with multimodal large language models,” arXiv preprint arXiv:2508.06372, 2025.
[3] Q. Wang, Y. Huang, G. Zhao, E. Clark, W. Xia, and H. Liao, “Diarizationlm: Speaker diarization post-processing with large language models,” arXiv preprint arXiv:2401.03506, 2024.
[4] T. J. Park, K. J. Han, M. Kumar, and S. Narayanan, “Speaker diarization with lexical information,” inProc. Interspeech, Graz, Austria, 2019, pp. 391–395.
[5] N. Kanda, Y. Gaur, X. Wang, Z. Meng, and T. Yoshioka, “Serialized output training for end-to-end overlapped speech recognition,” arXiv preprint arXiv:2003.12687, 2020.
[6] Z. Peng, J. Yu, Y. Chang, Z. Wang, L. Dong, Y. Hao, Y. Tu, C. Yang, W. Wang, S. Xu, et al., “Vibevoice-asr technical report,” arXiv preprint arXiv:2601.18184, 2026.
[7] J. Jin, Z. Guo, H. He, T. He, S. Bai, K. Chen, J. Wang, Y. Fu, K. Du, Z. Xu, X. Wang, Y. Chen, J. Li, and L. Jin, “Qwen2.5-omni technical report,” arXiv preprint arXiv:2503.20215, 2025.
[8] L. McInnes, J. Healy, and S. Astels, “hdbscan: Hierarchical density based clustering,”J. Open Source Softw., vol. 2, no. 11, p. 205, 2017.
[9] J. Carletta, S. Ashby, S. Bourban, M. Flynn, M. Guillemot, T. Hain, J. Kadlec, V. Karaiskos, W. Kraaij, M. Kronenthal, G. Lathoud, M. Lincoln, A. Lisowska, I. McCowan, W. Post, D. Reidsma, and P. Wellner, “The AMI meeting corpus: A preannouncement,” inMachine Learning for Multimodal Interaction (MLMI), Edinburgh, UK, 2005, pp. 28–39.
[10] F. Yu, S. Zhang, Y. Fu, L. Xie, S. Zheng, Z. Du, W. Huang, P. Guo, Z. Yan, B. Ma, X. Xu, and H. Bu, “M2MeT: The ICASSP 2022 multi-channel multi-party meeting transcription challenge,” inProc. IEEE ICASSP, Singapore, 2022, pp. 6167–6171.
[11] Y. Fu, L. Cheng, S. Lv, Y. Jv, Y. Kong, Z. Chen, Y. Hu, L. Xie, J. Wu, H. Bu, X. Xu, J. Du, and J. Chen, “AISHELL-4: An open source dataset for speech enhancement, separation, recognition and speaker diarization in conference scenario,” inProc. Interspeech, Brno, Czech Republic, 2021, pp. 3216–3220.
[12] Y. Chen, S. Zheng, H. Wang, L. Chen, Q. Chen, J. Qian, and Yafeng, “An enhanced res2net with local and global feature fusion for speaker verification,” 2023.
[13] S. P. Lloyd, “Least squares quantization in PCM,”IEEE Trans. Inf. Theory, vol. 28, no. 2, pp. 129–136, 1982, doi:10.1109/TIT.1982.1056489.
