
 语音小管家
近年来,生成式AI的突破极大地推动了歌曲生成(Song Generation)和歌声转换(Singing Voice Conversion, SVC)技术的发展 。然而,在面对音乐创作中统一建模的需求时,现有方法依然面临两大任务长期相互孤立的瓶颈。具体而言,当前的歌曲生成模型普遍缺乏细粒度的人声控制能力,难以实现零样本的音色克隆;同时,现有的SVC模型往往忽视了人声与背景音乐(BGM)之间的声学协同作用 。此外,由于两者在异构任务上的差异,简单的多任务融合常常导致梯度冲突和局部最优问题,使得模型往往顾此失彼。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)题为“Towards Unified Song Generation and Singing Voice Conversion with Accompaniment Co-Generation”的论文被语音旗舰会议Interspeech 2026接收 。该论文提出了UniSinger,这是首个将音色克隆的歌曲生成与伴奏协同生成的 SVC 相统一的端到端框架 。该研究的核心贡献包括:基于多模态扩散Transformer(MM-DiT)的基础架构,构建了跨任务的统一说话人嵌入空间,以实现多模态对齐和跨任务的音色迁移 ;设计了基于任务特定模态掩码的渐进式课程学习(Progressive Curriculum Learning)策略,有效解决了多任务优化中的梯度冲突。实验表明,该框架在两项任务上均达到了领先水平,并验证了两个任务可以互为先验、协同增强的普适规律 。
论文题目:Towards Unified Song Generation and Singing Voice Conversion with Accompaniment Co-Generation
作者列表:张子萸、强春雨、王晓鹏、郭雨欣、尹慷、田文杰、胡景斌、左天伦、郭钊、马腾、梁宇哲、张晨、谢磊
论文预印版:https://arxiv.org/abs/2606.07015
Demo Page:https://ziyu6.github.io/UniSinger/
研究背景与动机
实现歌曲生成与歌声转换(SVC)的统一建模,要求模型不仅能够解决单一任务的局限,还必须克服异构任务深度融合带来的根本性冲突。当前研究在实现这一目标上面面临三大核心阻碍:
单一任务的固有局限(Limitations of Isolated Tasks):歌曲生成与 SVC 长期孤立发展,前者缺乏零样本音色克隆能力,后者则忽视了人声与背景音乐间的声学协同作用。
模型架构的异构鸿沟(Heterogeneous Representation Gap):SVC(音频到音频)与歌曲生成(文本到音频)的输入模态天然异构,极难映射至共享隐空间,且难以建立统一的跨任务说话人注入机制。
训练范式的优化冲突(Multi-task Optimization Conflicts):SVC 侧重音色解耦,而歌曲生成侧重旋律创造,直接联合训练易引发梯度冲突与局部最优,导致生成结果要么丢失人声细节,要么音乐结构混乱。
UniSinger框架
为了平衡宏观的音乐结构生成与细粒度的声学音色控制,如图1所示,UniSinger 从多模态隐空间对齐、跨任务说话人嵌入空间构建,到渐进式课程学习策略进行了系统性设计。
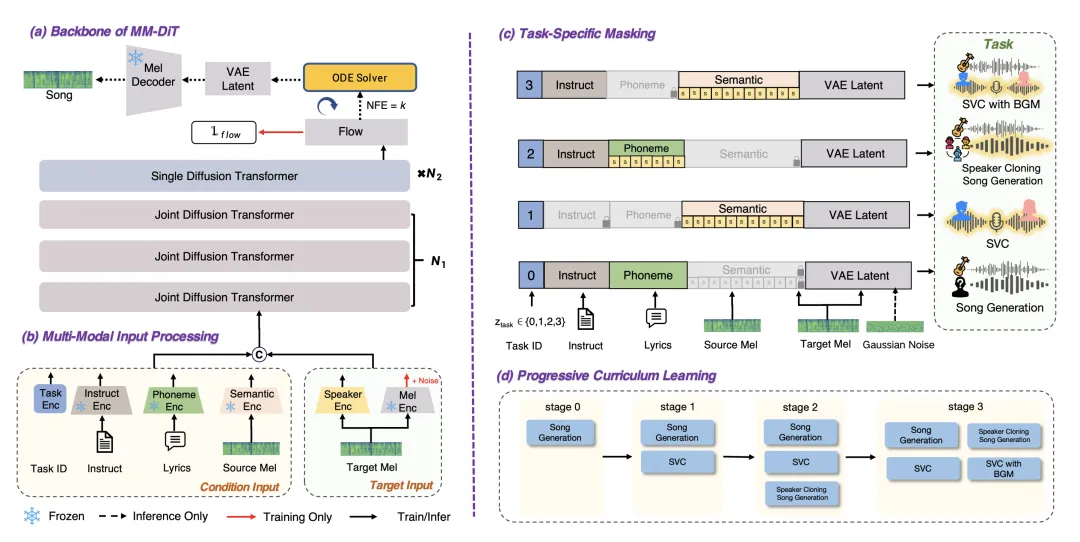
图1:UniSinger 的整体架构。左侧展示了 MM-DiT 骨干网络与多模态输入处理模块;右侧详细说明了基于任务特定模态掩码的渐进式课程学习策略。
多模态输入处理模块
本论文首先构建了一套多模态输入处理管道,旨在将异构任务的多种输入条件统一投影至共享的隐空间中,为统一建模奠定基础。
多模态特征深度编码:模型采用了一系列先进的预训练编码器提取多模态特征:利用冻结的 Qwen2.5-7B 处理文本指令,基于 Zipformer 的编码器提取音素序列,采用级联了 HUBERT 与向量量化(VQ)的 So-VITS-SVC 管道提取独立于说话人的语义特征,并使用 CAM++ 提取全局说话人身份特征。
音频潜空间压缩:训练了一个基于 SecoustiCodec 扩展的变分自编码器(VAE),将 44.1kHz 的高质量音频大幅下采样压缩至 1024 倍的潜空间中,直接作为 DiT 骨干网络的回归目标。
特征维度广播与对齐:在进入主干网络前,经过掩码处理的指令、音素和语义特征会在时间维度上进行拼接;同时,全局的说话人嵌入会被广播并沿特征维度拼接,从而为模型提供稳定且一致的人声条件注入。
跨任务统一说话人嵌入空间
为了在截然不同的任务中实现一致且精准的零样本人声控制,UniSinger 系统性地构建了跨任务的说话人嵌入机制。
基于 SVC 的表征提取(Speaker Representation via SVC):在训练 SVC 任务时,模型被强制要求仅利用独立的语义特征和 CAM++ 特征来重建目标人声音色。这一信息瓶颈机制有效过滤了冗余信息,迫使模型构建出纯净且统一的跨任务说话人隐空间。
跨任务特征迁移(Cross-Task Representation Transfer):随后,这些经过纯化的说话人特征被作为强大的声学先验,零样本迁移至歌曲生成任务中。由此,模型建立起一套严密的“层级控制机制”:利用文本指令驾驭宏观的全局音乐风格,同时依赖该说话人嵌入实现对细粒度人声属性的绝对控制。
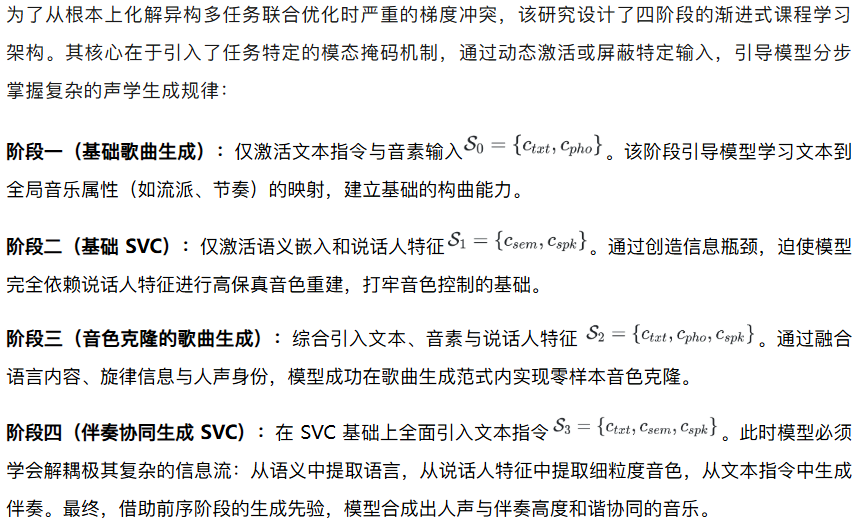
基于任务特定掩码的四阶段渐进式课程学习
实验结果与分析
音色克隆的歌曲合成(Speaker Cloning Song Generation)
在音色克隆的歌曲生成任务中,UniSinger 展现出了卓越的综合性能,结果如表1所示。在客观评价方面,得益于与 SVC 的联合训练以及跨任务说话人空间的有效构建,模型不仅实现了最低的音素错误率(19.61%),还取得了最高的说话人相似度(68.85%)。同时,UniSinger 在大多数 SongEval 音乐性指标(如连贯性和旋律)上保持领先,证明了统一任务有助于提升音乐的结构完整性与旋律丰富度。根据图2的主观测试小提琴图,UniSinger 的语音清晰度与具有 30 亿参数的大规模模型 YuE 表现持平,并在相似度和质量上显著优于 SongLM 和 ACE-Step 等基线模型,成功实现了高保真音乐生成与精准人声控制的良好平衡。
表1:歌曲生成模型的客观测试指标,与SongLM[1], YuE[2], ACE-Step[3], DiffRhythm+[4]对比
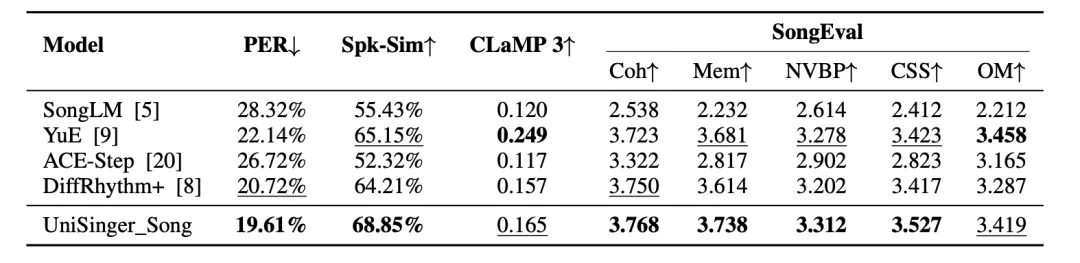
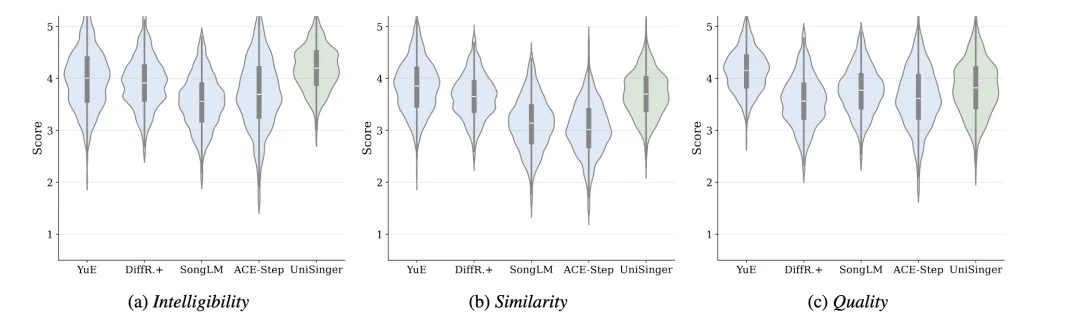
图2:歌曲生成模型的主观测试指标。 (a) 显示可理解性,(b) 显示相似性,(c) 显示音质
伴奏协同生成的歌声转换(SVC with Accompaniment)
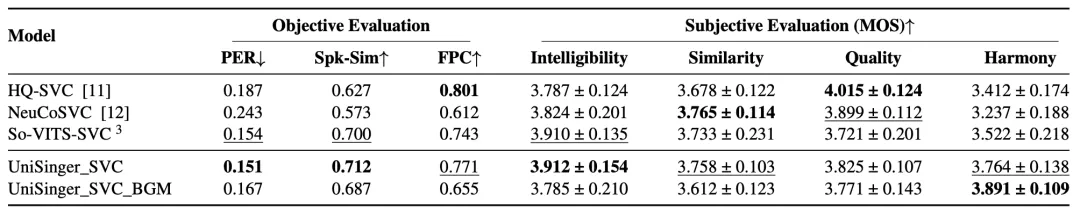
在带伴奏的歌声转换(SVC)任务中,该端到端框架同样证明了其在声学协同上的优越性,结果见表2。对于纯 SVC 变体,模型在内容保留(最低 PER 0.151)和说话人相似度(最高 Spk-Sim 0.712)上超越了 So-VITS-SVC 等现有基线模型,并在主观测试中获得了最高的语音清晰度得分。在最具挑战性的伴奏协同生成变体(UniSinger_BGM)中,尽管引入背景乐带来了预期的轻微指标波动,但模型依然保持了极强的鲁棒性,客观指标甚至超越了部分纯净人声基线模型。更重要的是,该变体在主观测试的人声与伴奏“和谐度(Harmony)”上确立了决定性优势,大幅领先于传统的多阶段级联合成方案,充分验证了其在处理复杂声学交互与节奏协同方面的强大能力。
表2:SVC模型的主客观测试指标,与HQ-SVC[5],NeuCoSVC[6]和So-VITS-SVC[7] 对比
消融实验
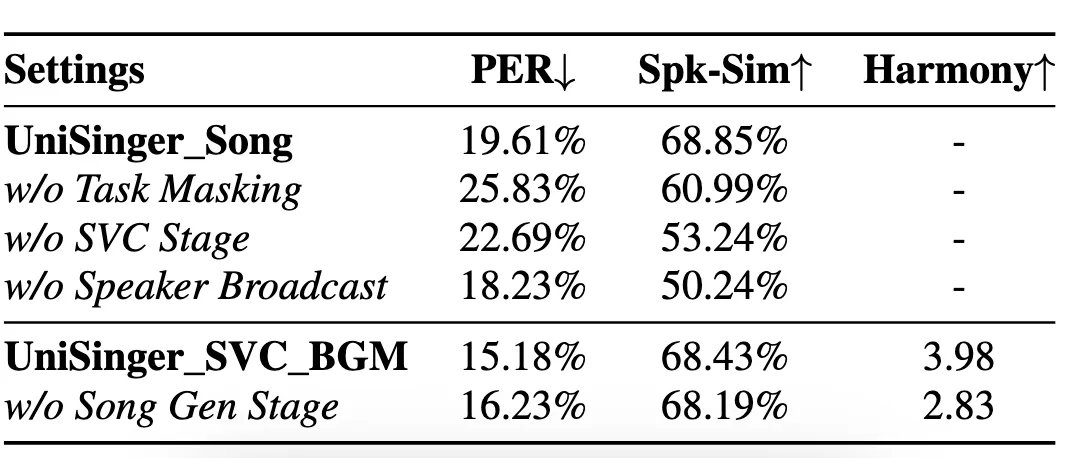
表 3 的消融实验结果证明了各核心设计的必要性。
任务特定掩码(Task-Specific Masking):移除该掩码会导致歌曲生成的 PER 和 Spk-Sim 显著恶化,证明其对解决多任务优化冲突至关重要。
说话人特征广播(Speaker Broadcasting):相比于 AdaLN 全局注入,我们的广播机制能更好地平衡语言清晰度与细粒度音色克隆(有效避免 Spk-Sim 的严重受损)。
多阶段渐进式训练(Progressive Curriculum):移除 SVC 阶段会使歌曲生成的 Spk-Sim 明显下降,而移除歌曲生成阶段会导致 SVC 的和谐度(Harmony)显著降低,证明各训练阶段对实现统一建模缺一不可。
表3:训练策略的消融研究
总结
我们推出了 UniSinger,这是第一个端到端框架,它统一了历史上孤立的歌曲生成和 SVC 范式。通过构建跨任务说话人嵌入空间,我们成功地弥合了语义理解和声学控制之间的差距。此外,我们的课程学习策略由特定任务模态掩蔽驱动,有效解决了多任务训练中的优化冲突。这种方法不仅可以实现两项任务的集成,而且有利于相互增强。通过建立人声伴奏协同,我们的框架开创了伴奏联生SVC的新能力,为AI音乐制作提供了智能解决方案。
参考文献
[1] C. Yang, S. Wang, H. Chen, J. Yu, W. Tan, R. Gu, Y. Xu, Y. Zhou, H. Zhu, and H. Li, “Songeditor: Adapting zero-shot song generation language model as a multi-task editor,” in Proceedings of the AAAI Conference on Artificial Intelligence, vol. 39, no. 24, 2025, pp. 25 597–25 605.
[2] R. Yuan, H. Lin, S. Guo, G. Zhang, J. Pan, Y. Zang, H. Liu, Y. Liang, W. Ma, X. Du et al., “Yue: Scaling open foundation models for long-form music generation,” arXiv preprint arXiv:2503.08638, 2025.
[3] J. Gong, S. Zhao, S. Wang, S. Xu, and J. Guo, “Ace-step: A step towards music generation foundation model,” arXiv preprint arXiv:2506.00045, 2025.
[4] H. Chen, Y. Jiang, G. Ma, C. Hao, S. Wang, J. Yao, Z. Ning, M. Meng, J. Luan, and L. Xie, “Diffrhythm+: Controllable and flexible full-length song generation with preference optimization,” arXiv preprint arXiv:2507.12890, 2025.
[5] B. Bai, Y. Geng, F. Wang, C. Wang, P. Guo, Y. Gao, and Y. Li, “Hqsvc: Towards high-quality zero-shot singing voice conversion in low-resource scenarios,” arXiv preprint arXiv:2511.08496, 2025
[6] B. Sha, X. Li, Z. Wu, Y. Shan, and H. Meng, “Neural concatenative singing voice conversion: Rethinking concatenation-based approach for one-shot singing voice conversion,” in ICASSP 20242024 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2024, pp. 12 577–12 581.
[7] https://github.com/RVC-Boss/GPT-SoVITS
