
 语音小管家
以下文章来源于一杯阔乐聊ai,以下文章来源于一杯阔乐聊ai
项目主页:https://github.com/netease-youdao/Confucius4-TTS 在线 Demo:https://confucius4-tts.youdao.com/gradio/ Demo 试听页:https://2901733926.github.io/Confucius4-TTS/ Hugging Face:https://huggingface.co/netease-youdao/Confucius4-TTS ModelScope:https://modelscope.cn/models/netease-youdao/Confucius4-TTS 发布机构:网易有道(NetEase Youdao),隶属"子曰 4"大模型体系 发布日期:2026-05-22(与子曰 4 多模态 27B、翻译模型 2.0 同日双核心全量开源) 开源协议:Apache License 2.0
先说它是啥:子曰4,Confucius4-TTS 是一款开源的多语种、跨语种零样本 TTS 引擎,由网易有道(NetEase Youdao)推出,基于「语音编码器大语言模型(LLM)」架构,Apache2.0 协议。
网易有道同期开源了什么
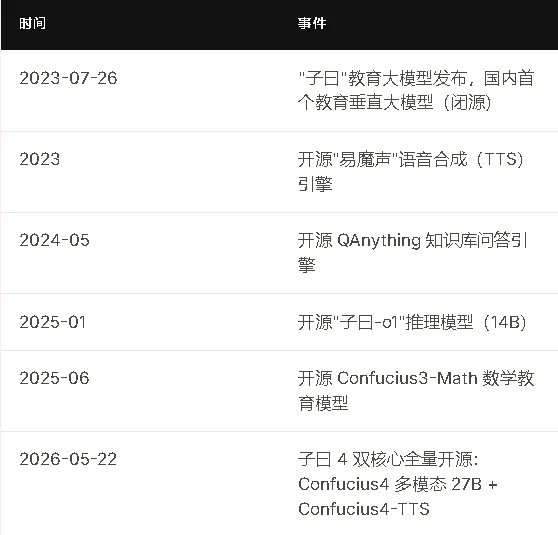
同期落地的有:
子曰 4 多模态模型(27B 参数):2026-05-22,视觉数理 SOTA,纯文本数理准确率 81.4%,思维链输出长度压缩 43.2%。 子曰翻译大模型 2.0(14B 参数,融合 DeepSeek-R1):2026-01-10,推理速度 +80%,WMT / Flores200 国际评测专业度领先,覆盖 19 个垂直领域。 有道翻译官 App"耳机同传"(2026-04-22 上线):识别延迟 0.9 秒、端到端 2 秒内,支持中英日西四语,远场拾音 10 米。 有道同传 Agent:2026-04-22,行业首个同传 Agent,支持 71 种语言 125 种口音实时识别。 LobsterAI / QAnything / 有道宝库 / Thinkflow:Agent、RAG、播客生成等配套开源产品。
技术呼应:耳机同传 App 在会议场景里用"讲者本人音色"播报翻译结果,背后就是和 Confucius4-TTS 同一套"无参考文本 + 跨语种无口音"的能力下沉到端侧。
官方一句话定位:"One voice. Any language."—— 一种音色,任意语言。
它的核心差异化在 README 里写得很清楚:不需要参考文本,就能做跨语种零样本音色克隆。在 14 种语言之间切换时,音色、情感、语气一并迁过去,没有"夹生外语"的尴尬。
6 个核心特性:
14 Languages Supported— 中、英、日、韩、德、法、西、印尼、意、泰、葡、俄、马来、越南共 14 种 Unconstrained Voice Cloning—无参考文本的声音克隆 Cross-Lingual Voice Transfer— 跨 14 种语言的无口音合成 Zero-Shot Voice Transfer— 零样本声音克隆,无需额外训练 Seamless Emotion Transfer— 情感迁移,克隆的是"感受" Robust Generalization— 真实多语种场景下表现稳定
架构:Speech Encoder(语音编码器)+ LLM,分两个模块:
T2S(Text-to-Semantic)— 从文本 + 说话人条件生成「语义 token 序列」 S2A(Semantic-to-Acoustic)— 基于 Flow Matching 的流匹配模型,把语义 token 转成梅尔频谱图
协议:Apache 2.0(保留版权声明即可商用)。
Q:我家这台老电脑到底能跑吗?
仓库只写了 Python 3.10 + CUDA 12.6,没列单卡显存下界。
外部资料给到的参考是 1.3B 参数级别——单卡 8-12GB 显存是经验起点,没 GPU 也能跑 CPU 版,但慢;磁盘要预留富余(完整资源包含模型权重 + 配套工具链 + 框架,体积不算小)。
Q:生成一段 100 字的语音要等多久?
官方没给具体 FPS / RTF。
第三方跑分显示同档 LLM 在 RTX 4090 上约 50-77 tokens/s,TTS 因为多了一步梅尔频谱生成会再慢一些。
保守估计:单卡 GPU 几秒到十几秒一段,CPU 是分钟级。流式输出 README 没提,所以现在只能整段等。
Q:中文效果到底行不行?会不会英文强、中文拉胯?
不会。从官方自己的 Seed-TTS-eval 看,中文明代混合方向 WER 比 Qwen3-TTS / CosyVoice3-1.5B 都低(Confucius4-TTS 0.94 vs Qwen3-TTS 0.77,CosyVoice 还要高)。
SIM 说话人相似度 0.765,处于这批对手的中上水平。中文是它的主战场。
Q:我的录音 / 数据会被传走吗?
本地部署模式下,所有数据都在你自己机器上,Apache 2.0 + 完整权重 + 不依赖云端 API。
Q:跟 ElevenLabs 比到底哪个好?
小语种选 Confucius4-TTS:在泰语、越南语方向,ElevenLabs 的 WER 飙到 70+(数字来自 README 公开榜单),Confucius4-TTS 控制在 2 以内。
SaaS 化音色设计、API 稳定性、英文发音自然度选 ElevenLabs:毕竟是闭源商业老厂。
结论:做多语种内容创作用 Confucius4-TTS,做纯英文 SaaS 集成用 ElevenLabs。
Q:我用这个做有声书 / 播客 / 视频配音,能搞定吗?
能搞定一半。
能搞定的:单段 1-3 分钟的旁白、对白,跨语种克隆+翻译。
还搞不定的:长文本一次性合成(容易飘/重复/中断),需要按章节切分再拼接;精确的标点停顿控制(要靠文本归一化手工调);多人对话(多人音色要分段生成再合)。播客/有声书有方案但不是开箱即用。
README 的 Acknowledgements 把"借鉴"和"集成"的项目列得很明白:
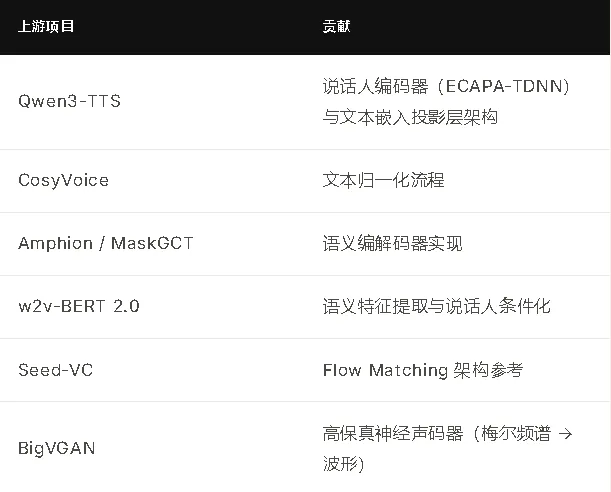
训练用到的预训练资源
Wav2Vec2-BERT 2.0:说话人条件化、语义特征提取 Amphion(开源项目):内含 MaskGCT 语义编解码器 CAMPPlus说话人编码器( campplus_cn_common.bin)
训练流程
两阶段、可分开跑:
T2S 训练: python -m confuciustts.cli.train_t2s -c config/train_t2s.yamlS2A 训练: python -m confuciustts.cli.train_s2a -c config/train_s2a.yaml关键设计:S2A 训练时,T2S、Wav2Vec2-BERT、CAMPPlus 全部冻结,只有流匹配 S2A 在更新参数
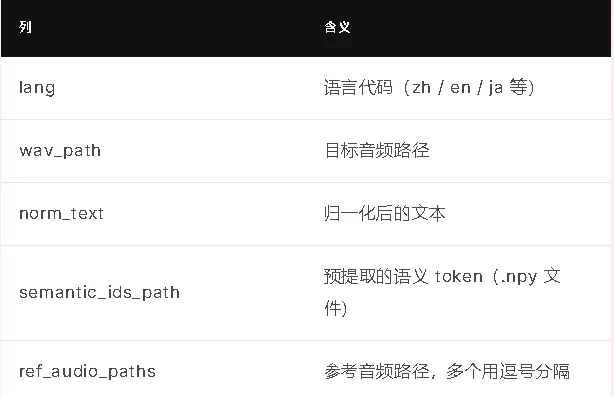
数据格式
5 列 TSV(无表头,制表符分隔):
跨境内容创作者:你已经有中文/英文口播视频,保留你自己音色 + 翻译到其他语种,AI 配音不再"换人"。Youtube / TikTok / 小红书多语种矩阵适用。 教育与培训:教材朗读、双语启蒙、外语听力素材。一个人录一遍,AI 帮你出 14 个语种对照版。 数字人 / 虚拟主播:给数字人配固定声线,需要稳定的情感控制。14 语种 + 情感迁移对国际化 IP 友好。 播客 / 有声书自动生成:上传稿子(论文、新闻、书摘),LLM 提取重点 + 拆分角色 + TTS 朗读,搭个流水线。 客服 / 智能助手 IVR:固定话术、固定音色、需要稳定响应。但目前不支持流式输出,所以实时语音对话场景还需要等。 企业宣传 / 品牌配音:需要在多个语种里保持品牌方"那个声音",这正是跨语种无口音克隆的强项。 小语种市场进入:想做泰语、越南语、印尼语等小语种内容时,ElevenLabs 等商用云端经常拉胯,Confucius4-TTS 在小语种 WER 上有明显优势。
目前不擅长的:实时流式对话(不支持)、长文本一次性生成(要切分)、精细情绪标签控制(不能[happy]这种文字标签直接调)。
跨语种无口音方案的"是否需要参考文本"
README 里被列为对比对象(也就是 Confucius4-TTS 自己也承认在和它们直接比较)的项目有:
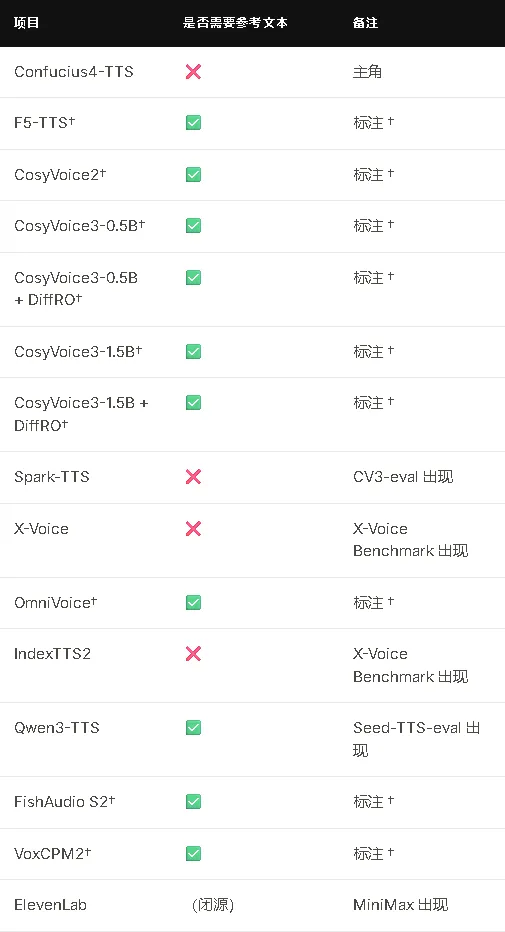
一眼能看出的差异:
「无参考文本」的开源方案共 4 个:Confucius4-TTS、Spark-TTS、X-Voice、IndexTTS2 「跨语种无口音 + 无参考文本」同时满足的:Confucius4-TTS、X-Voice(README 数据上看)
跨语种零样本 TTS 一图速览(外部资料,2026-05 横评)
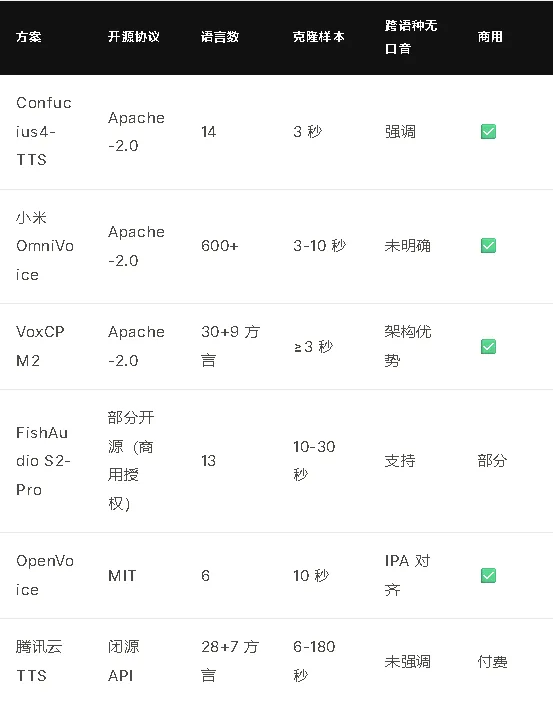
(来源:smzdm 横评 2026-05、communeify 评测 2026-05-25、firethering 4 开源 TTS 评测 2026-04-05)
同期开源的其他选手
LongCat-AudioDiT(美团):MIT 协议,分 1B / 3.5B 两档,跳过梅尔频谱直接在波形潜空间做单步生成;Seed benchmark 上 SIM 0.818(Seed-ZH)。 FireRedTTS-2:主打多人对话生成,L20 GPU 首包延迟 140ms,更适合播客 / 多人配音。
"是否需要参考文本" 进一步细分
回到 README 给的 4 张对比表,对手项目里需要参考文本(标 †)的占多数:
完全不需要参考文本:Confucius4-TTS、Spark-TTS、X-Voice、IndexTTS2 跨语种无口音 + 无参考文本 同时满足:Confucius4-TTS(README 数据上看)
这一栏里的"对手"基本都需要提前把参考音频的文本写好——多一道工序。
两个指标:
WER / CER(越低越好):合成语音转写出来的字错率 SIM(越高越好):说话人相似度
CV3-eval 跨语种(6 个方向)
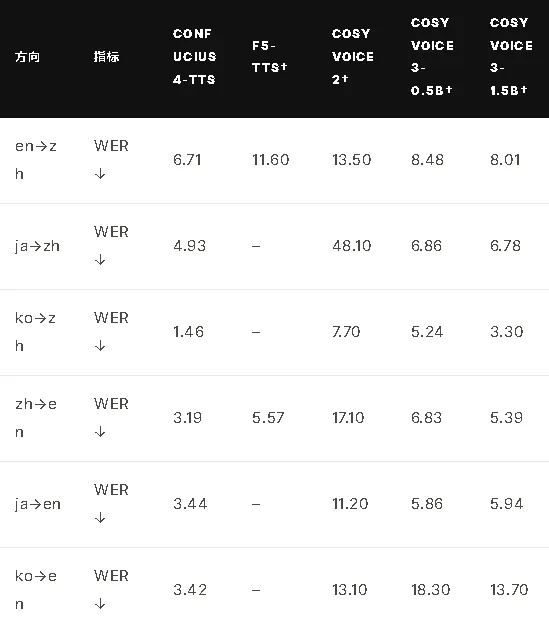
zh→en / ja→en / ko→en 三个方向 Confucius4-TTS 的 WER 是这列对手里最低的。
X-Voice Benchmark(7 个跨语种方向)
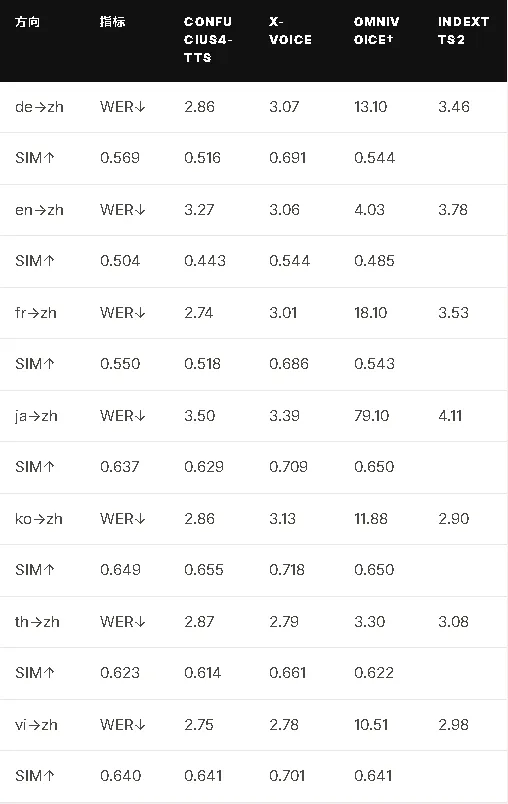
7 个方向中4 个方向的 WER 最低(de→zh、fr→zh、ko→zh、vi→zh)。SIM 整体在 0.50–0.65 区间,OmniVoice SIM 更突出但 WER 偏高。
Seed-TTS-eval(中英零样本)
MiniMax-Multilingual-Test(11 语种)
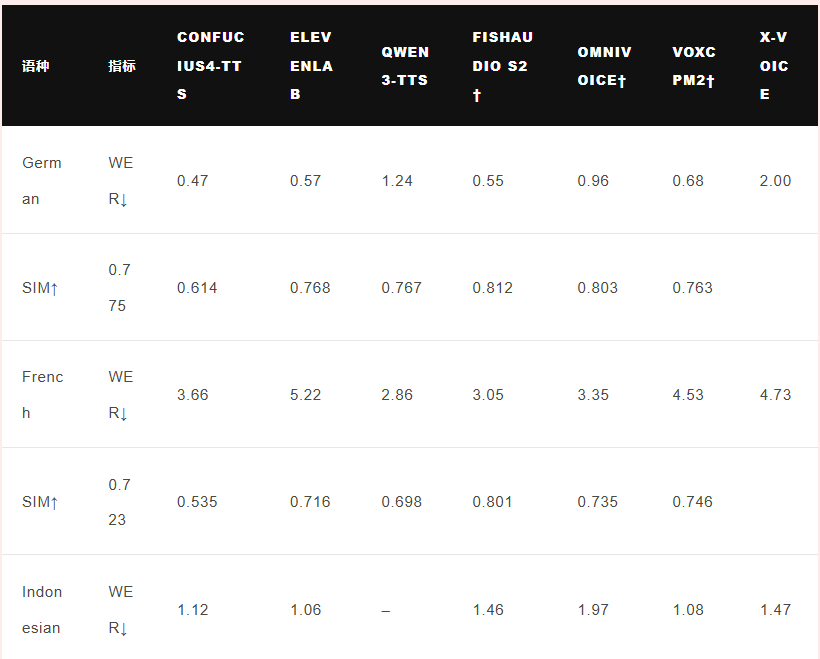
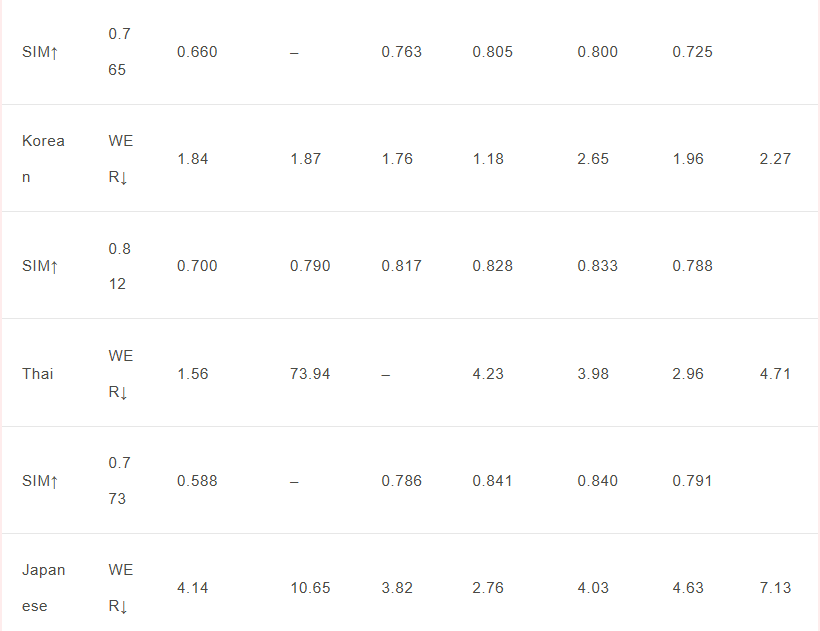
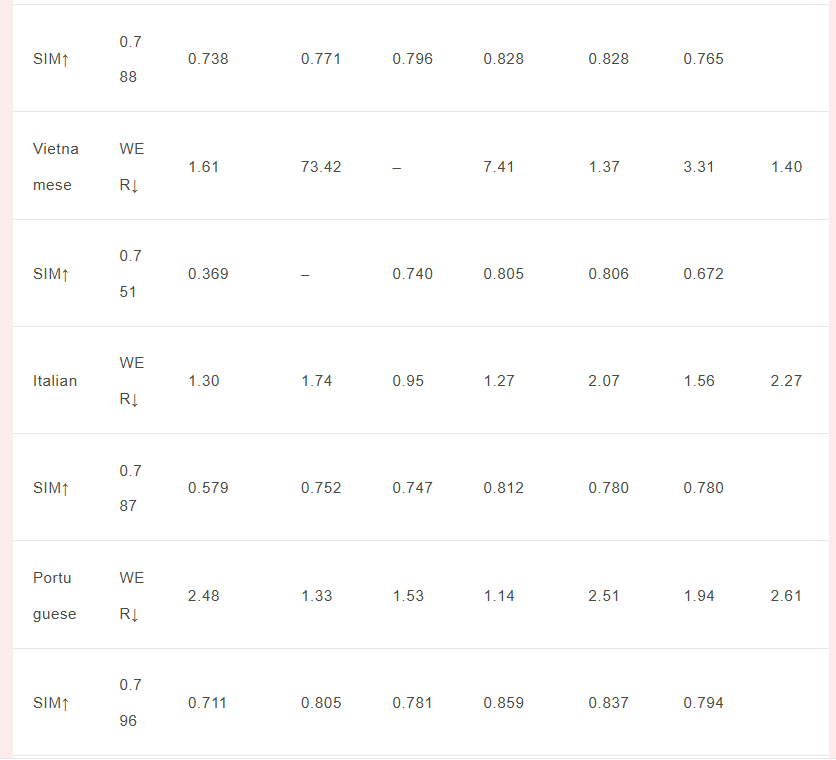
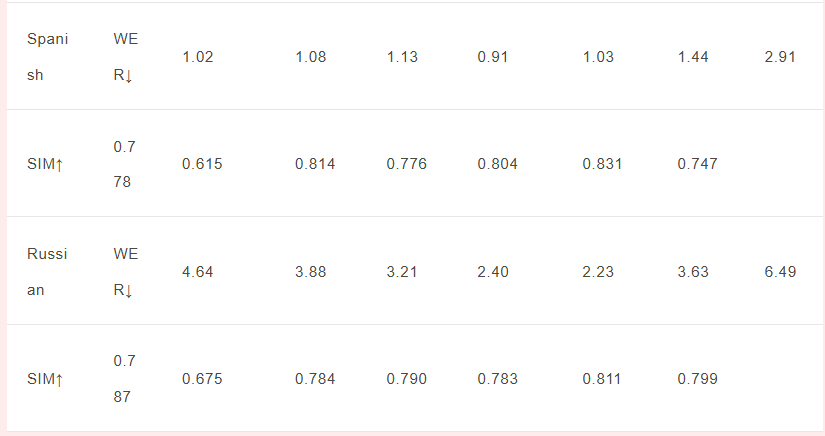
一个直观对比:在泰语、越南语这种小语种上,ElevenLab 的 WER 70+,Confucius4-TTS 在 2 以内。在德语、泰语上,Confucius4-TTS 的 WER 是全场最低。
不适合的场景:
需要实时流式输出:官方没提流式,外部资料也没看到流式接口(直播、低延迟对话场景不友好) 要文本级情绪标签控制:参考音频的情绪可以无意识地迁移,但用户用 [happy][angry]这种文字标签精确控制,README 没说支持100+ 语种覆盖:Confucius4-TTS 14 语种,OmniVoice 600+ 语种,语种广度上 OmniVoice 完胜
权衡的指标:
WER(字错率):Confucius4-TTS 在大多数方向上领先,但SIM(说话人相似度)OmniVoice 更高(如 de→zh 方向 OmniVoice 0.691 vs Confucius4-TTS 0.569) 音质细节:第三方综合评测(communeify)认为它在 CV3-eval 等跨语种榜单上"极具竞争力",但主观听感因场景而异
法律和道德(跟项目无关但要提):
克隆他人声音生成语音,涉及肖像权 / 声音权 / 反诈合规,需取得本人授权 平台合规层面,已发生多起 AI 克隆诈骗案,工信部、网信办均有相关风险提示
1. 资源包 54G 不只是模型权重
完整资源包含模型权重、wav2vec2-bert-2.0、Amphion(含 MaskGCT)、campplus_cn_common.bin 等多个部分,磁盘 IO 友好一点的话建议 SSD。
2. S2A 训练时上游全部冻结
S2A训练时T2S、Wav2Vec2-BERT、CAMPPlus全部冻结,只有 S2A 在更新参数。意味着 T2S 必须先收敛到一定程度,再做 S2A。README §4 Launch S2A Training 里有写。
3. 微调数据是 5 列 TSV
无表头:lang \t wav_path \t norm_text \t semantic_ids_path \t ref_audio_paths。semantic_ids_path是预提取的.npy,需要单独跑一遍 Amphion / MaskGCT 提取。ref_audio_paths多个用逗号分隔。
4. 中文文本要走 CosyVoice 风格的归一化流程
文本归一化是从 CosyVoice 借鉴的流程——数字、符号、英文缩写都要归一化处理,不然合成出来会卡壳。
环境要求(来自 README)
Python 3.10 CUDA 12.6 硬件门槛:README 没列单卡显存下界;外部资料(CSDN 2026-05-29 硬件指南)给到"1.3B 参数级别"做参考,单卡 8-12GB 显存是常见的经验起点,有 GPU 比没 GPU 快得多。
快速开始
git clone https://github.com/netease-youdao/Confucius4-TTS.git
cd Confucius4-TTS

conda create -n confuciustts python=3.10 -y
conda activate confuciustts
pip install -r requirements.txt
推理(命令行)
python example.py \
    --prompt_wav path/to/reference.wav \
    --text "Your text to synthesize" \
    --lang en \
    --out output.wav \
    --config config/inference_config.yaml
推理(Python API)
import torch
import torchaudio
from confuciustts.cli.inference import ConfuciusTTS

model = ConfuciusTTS(
    config_path="config/inference_config.yaml",
    device="cuda" if torch.cuda.is_available() else "cpu",
)

audio = model.generate(
    text="Hello, welcome to Confucius4-TTS.",
    lang="en",
    prompt_wav="path/to/reference.wav",
    verbose=True,
)

torchaudio.save("output.wav", audio.cpu(), model.sample_rate)
微调前的预训练模型准备
"color:"color:#9ca3af;">#9ca3af;"># Wav2Vec2-BERT 2.0
huggingface-cli download facebook/w2v-bert-2.0 \
    --local-dir pretrained/w2v-bert-2.0

"color:"color:#9ca3af;">#9ca3af;"># Amphion(含 MaskGCT)
git clone https://github.com/open-mmlab/Amphion.git external/Amphion
微调时需要的目录结构
checkpoints/
├── t2s_model.safetensors
├── s2a_model.pt
├── wav2vec2bert_stats.pt
├── special_tokens_map.json
├── tokenizer.json
├── tokenizer.model
└── tokenizer_config.json
pretrained/
├── w2v-bert-2.0/
└── campplus/
    └── campplus_cn_common.bin
external/
└── Amphion/
训练数据格式(5 列 TSV,无表头)
zhpath/to/utt1.wav归一化后的中文文本path/to/utt1_semantic.npypath/to/ref1.wav,path/to/ref2.wav
enpath/to/utt2.wavnormalized english textpath/to/utt2_semantic.npypath/to/ref3.wav
... Confucius4-TTS 把三件事合到了一起:14 语种 + 零样本 + 无参考文本 + 跨语种无口音。从 README 公开数据看,在 zh→en / ja→en / ko→en 三个方向上 WER 比对手低;在泰语、越南语、德语上 WER 是这批开源 + 闭源对手里最低的一档;在 SIM 说话人相似度上和 X-Voice、IndexTTS2 处于同一档,OmniVoice 略高。
Apache 2.0 协议、商用无障碍。不需要参考文本这件事是它相对 F5-TTS / CosyVoice / FishAudio S2 / VoxCPM2 等需要参考文本方案的最大不同。
去 Demo 听一下真实效果:https://confucius4-tts.youdao.com/gradio/
