
 语音小管家
以下内容来源:AIMS AI LAB
近日,AIMS AI Lab 共有16 篇论文被国际语音技术领域旗舰会议 Interspeech 2026 接收,覆盖多个前沿方向,包括语音大模型推理和后训练、情感计算、低资源语言、语音应用以及神经元群组建模。
一、语音大模型推理和后训练
LALM Reasoning and Post-Training
01、Disentangling Reasoning in Large Audio-Language Models for Ambiguous Emotion Prediction
Xiaofeng Yu, Jiaheng Dong, Jean Honorio, Abhirup Ghosh, Hong Jia, Ting Dang
合作单位:奥克兰大学,伯明翰大学,ARC OPTIMA
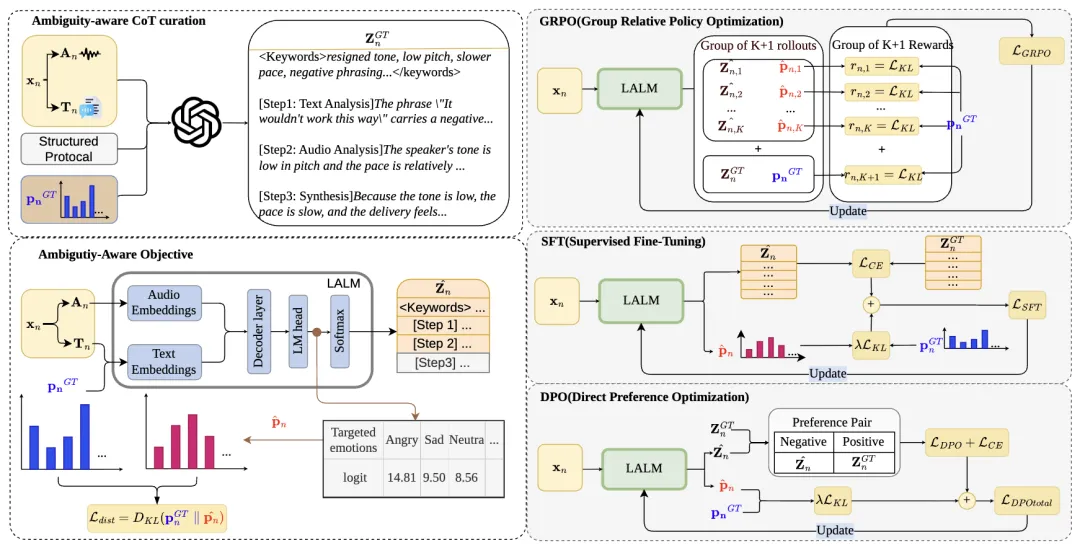
语音情感识别在多种应用中十分重要,但现有方法大多只预测单一情感标签,过度简化了人类情感表达本身的模糊性。该工作将模糊情感识别重新表述为“分布式推理”问题,并系统研究大规模音频语言模型在模糊情感理解中的推理能力。作者提出了面向情感分布对齐的 ambiguity-aware objective,以及结构化的 ambiguity-aware chain-of-thought supervision,引导模型结合多种情感线索进行推理。实验表明,该框架在 IEMOCAP 和 CREMA-D 上能稳定提升 SFT、DPO 和 GRPO 等训练策略的表现。
02、Localizing and Editing Knowledge in Large Audio-Language Models
Sung Kyun Chung, Jiaheng Dong, Qiuchi Hu, Gongping Huang, Hong Jia, Ting Dang
合作单位:奥克兰大学,武汉大学
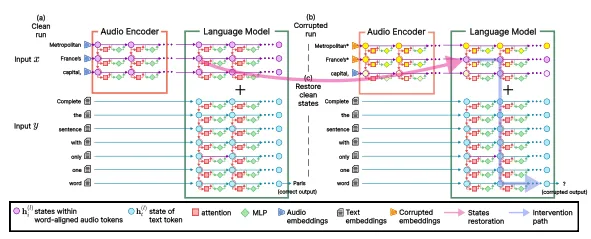
大规模音频语言模型在语音理解任务中表现突出,使语音成为访问事实知识的自然接口。然而,这类模型通常基于静态语料训练,可能编码错误或过时事实。现有模型编辑方法主要面向文本 LLM,难以解释连续语音表示、声学模块和语言模块中知识的存储位置。该工作构建了首个面向 LALM 知识定位与编辑的音频基准,并提出 speech-driven locate-then-edit 框架:先通过 speech-aware causal tracing 定位支持事实检索的层和模块,再在定位位置进行编辑。实验显示,事实知识由音频和文本模块共同编码,音频侧编辑比文本编辑或微调更有效。
03、Activation Steering for Accent Adaptation in Speech Foundation Models
Jinuo Sun, Yang Xiao, Sung Kyun Chung, Qiuchi Hu, Gongping Huang, Eun-Jung Holden, Ting Dang
合作单位:武汉大学
口音差异仍然是自动语音识别中的重要挑战,而多数现有适应方法依赖参数微调,却缺乏对口音信息在模型中如何编码的理解。该工作将口音变化视为隐藏表示空间中的可解释子空间,并通过提取不同层的编码器激活,估计由口音引起的表示偏移方向。作者进一步将这些方向注入特定层,分析它们如何使带口音语音表示向标准语音表示对齐,从而得到逐层的口音敏感性分布。基于这一发现,论文提出无需更新参数的 inference-time accent steering,在 8 种口音上实现了稳定的词错误率下降。
PolyBench: A Benchmark for Compositional Reasoning in Polyphonic Audio04
Yuanjian Chen, Yang Xiao, Han Yin, Xubo Liu, Jinjie Huang, Ting Dang
合作单位:哈尔滨理工大学,韩国科学技术院,萨里大学
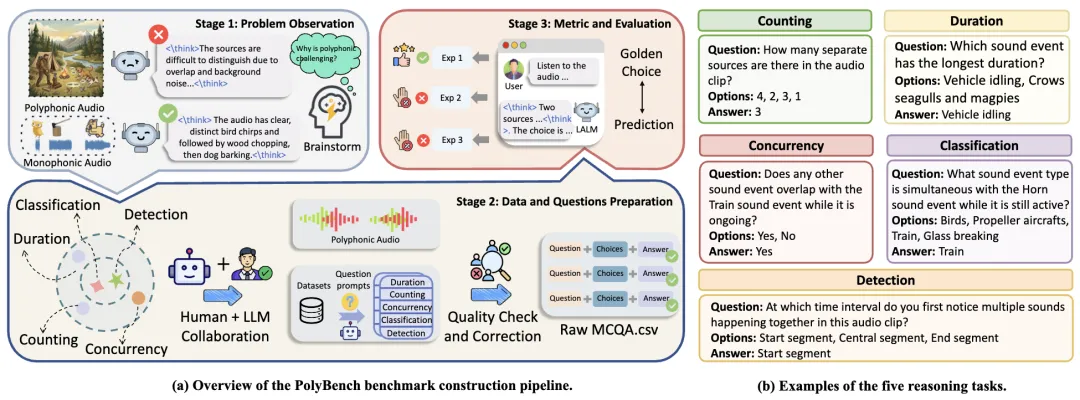
大规模音频语言模型逐渐具备音频推理能力,但现有基准较少覆盖复调音频中的组合推理场景,即多个声音事件同时出现并形成复杂结构关系。该论文提出 PolyBench,用于评估模型在复调音频中的组合推理能力。该基准包含 counting、classification、detection、concurrency 和 duration estimation 五类评测子集,要求模型理解多个并发声音事件及其关系。对当前先进 LALM 的评测显示,模型在复调场景中性能显著下降,说明复调音频推理仍是现有模型的重要瓶颈。
二、情感计算
Affective Computing
05、Edge-Cloud Collaborative Speech Emotion Captioning via Token-Level Speculative Decoding in Audio-Language Models
Xiangyuan Xue, Jiajun Lu, Yan Gao, Gongping Huang, Ting Dang, Hong Jia
合作单位:奥克兰大学,剑桥大学,武汉大学
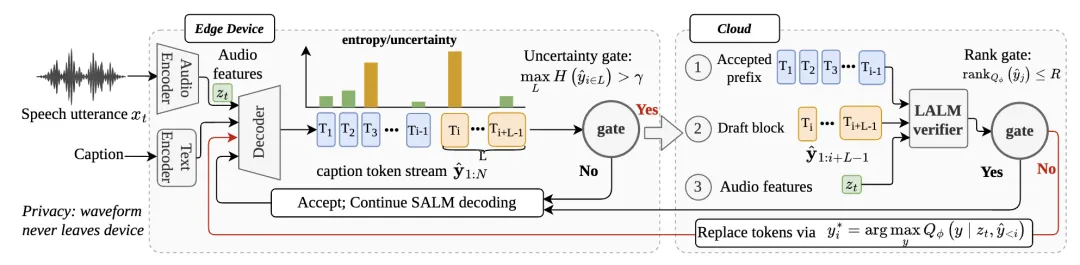
语音情感描述任务利用大规模音频语言模型,从语音中生成丰富且具备上下文感知的情感描述。然而,在真实部署中,边缘设备算力有限,同时上传生物特征语音到云端也存在隐私风险。该论文提出基于 Uncertainty-Guided Speculative Decoding 的边云协同框架:轻量边缘模型先在本地生成 caption draft,只有高不确定性的 token block 才上传给更强的云端模型验证。实验在 MER2024 上显示,该方法显著提升 BLEU,最高提升 62.7%,并相较纯边缘模型实现更低延迟和更高 token throughput。
06、Revisiting Delay Compensation via Feature-Level Temporal Accumulation in Continuous Emotion Recognition
Jian Xiang, Jingyao Wu, Ting Dang, Vidhyasaharan Sethu, Eliathamby Ambikairajah
合作单位:新南威尔士大学,麻省理工学院
连续情感识别(Continuous Emotion Recognition, CER)依赖时间连续的情感标注,但这类标注通常存在延迟,从而导致模型预测与标签之间的时间错位。常见的解决方法是基于平移的延迟补偿(Shift-based Delay Compensation, SDC),即相对于输入移动标签,但该方法需要截断边界数据,并且对延迟参数十分敏感。本文提出累计延迟补偿(Accumulated Delay Compensation, ADC),通过特征层面的时间累积来替代标签平移。通过聚合过去的输入特征,ADC 能够引入历史上下文,并隐式建模延迟,同时保留原始输入与标签之间的对齐关系。在 RECOLA 语料库上的实验表明,相较于 SDC,ADC 对延迟参数选择更加鲁棒。进一步分析显示,arousal 更适合较短的时间整合窗口,而 valence 则能从更长的时间窗口中获益。
三、低资源语言
Low-Resource Languages
07、Continual Adaptation for Pacific Indigenous Speech Recognition
Yang Xiao, Aso Mahmudi, Nick Thieberger, Eliathamby Ambikairajah, Eun-Jung Holden, Ting Dang
合作单位:新南威尔士大学
语音基础模型在低资源太平洋原住民语言上的表现受到数据稀缺限制,而完整微调又容易导致灾难性遗忘。该研究基于真实太平洋语言数据,系统比较 full fine-tuning 和 LoRA 等适应策略,并分析数据量和语言特征如何影响适应效果。作者进一步研究模型连续学习多种语言时的表现,发现模型会出现明显的内部表示漂移,并面临稳定性与可塑性之间的矛盾。研究指出,尽管 LoRA 在初始适应阶段有效,但在连续学习中仍会出现遗忘问题,因此低资源语言需要更稳健的适应方法。
08、Hybrid Continual Learning for Low-Resource Australian Aboriginal Language Identification
Pravina Mylvaganam, Ting Dang, Eliathamby Ambikairajah, Vidhyasaharan Sethu, Jingyao Wu
合作单位:新南威尔士大学,麻省理工学院
语言识别是将濒危澳大利亚原住民语言纳入语音技术的重要一步,有助于支持语言复兴与数字包容。然而,极端的数据稀缺严重限制了模型性能。虽然从高资源语言进行迁移学习展现出潜力,但模型在适应新语言时往往会遭遇灾难性遗忘。持续学习能够缓解这一问题,但在数据极其有限的场景下仍然具有挑战。为此,本文提出两种混合持续学习方法:Replay Augmented Elastic Weight Consolidation 和 Constraint-Guided Knowledge Distillation,用于将预训练语音模型适应到澳大利亚原住民语言识别任务,同时保留此前学习到的知识。基于 Warlpiri、Dalabon 和 Dharawal 的实验表明,所提出方法优于普通微调和现有持续学习基线,能够在适应多种澳大利亚原住民语言的同时,保持模型在此前学习过的高资源语言上的表现。
09、Easper: An Accessible ASR Pipeline for Language Documentation
Aso Mahmudi, Ting Dang, Ekaterina Vylomova, Nick Thieberger
音频转写是濒危语言文档化中的关键瓶颈。尽管 Whisper 等多语言自动语音识别模型提供了潜在解决方案,但田野语言学家通常缺乏使用这些模型所需的技术背景。本文提出 Easper,一个开源、无代码的工作流,使语言学家能够直接基于 ELAN 标注,并通过云端资源迭代式微调 ASR 模型。部署 ASR 还会带来冷启动问题,即如何决定优先转写哪些录音,以便快速启动一个准确的模型。借助 Easper,本文在三种瓦努阿图语言 Bislama、Nafsan 和 Nguna 上模拟主动学习过程,并按录音 session 微调模型,比较优先选择声学质量更高的录音(低噪声、少重叠)与优先选择语言信息更丰富的录音(词汇多样性高、重复性强)时的字符错误率变化。研究发现,即使在有噪声环境下,优先选择词汇密集且具有重复叙事结构的录音,也能带来更快的转写性能提升。
10、Which Languages Transfer Best to Warlpiri? A Similarity-Based Study for Low-Resource ASR
Pravina Mylvaganam, Eliathamby Ambikairajah, Ting Dang, Vidhyasaharan Sethu, Tuende Szalay
合作单位:新南威尔士大学,悉尼大学
本文研究语言相似性如何提升极低资源场景下自动语音识别(ASR)的跨语言迁移效果。Warlpiri 是一种澳大利亚原住民语言,其转写语音数据极为有限,因此迁移学习对于提升 ASR 性能尤为关键。本文提出一个结合声学相似性与语言学相似性的框架:声学相似性来自预训练语音模型,语言学相似性则基于类型学、音素库存、语法和句法特征。该框架用于排序高资源源语言,并评估它们向 Warlpiri 迁移时的有效性。基于 Whisper 的实验表明,声学和类型学上更相似的语言优于单语言和多语言基线。其中,阿萨姆语和印地语显著降低了词错误率和字符错误率。相关性分析进一步表明,声学相似性是预测微调性能的最强因素,而音素库存和类型学相似性则更能解释零样本迁移效果。
11、A Fusion-Aware Two-Stage Framework for Mispronunciation Detection and Diagnosis in Low-Resource Modern Standard Arabic
Jing Yang, Shuqing Zhang, Yongyi Deng, Pan Li, Ting Dang, Gongping Huang, Jingdong Chen, Jacob Benesty
合作单位:武汉大学,魁北克大学
准确的音素识别对于现代标准阿拉伯语(Modern Standard Arabic, MSA)的发音错误检测与诊断(Mispronunciation Detection and Diagnosis, MDD)至关重要,但该任务仍受到数据稀缺以及合成语音与真实学习者语音之间领域差异的限制。本文提出一种两阶段端到端框架,将预训练编码器与因果扩张时序卷积网络结合,以保留细粒度的音素变化信息。该方法采用分层两阶段策略:首先从母语者语料和合成语料中学习通用映射关系,随后适应少量真实学习者数据,以缓解领域偏移并避免过度校正。为进一步增强预测稳定性,本文还引入多检查点集成推理与 N-gram 重打分机制。在 QuranMB.v2 测试集上的评估显示,该系统取得 0.7201 的 F1 分数,相比基线 0.4414 实现了 63.1% 的相对提升。该结果在 IqraEval.2 Challenge 中排名领先,为低资源现代标准阿拉伯语发音错误检测与诊断建立了新的最佳能。
四、语音应用
Speech Applications
12、ImKWS: Test-Time Adaptation for Keyword Spotting with Class Imbalance
Hanyu Ding, Yang Xiao, Jiaheng Dong, Ting Dang
合作单位:江苏大学
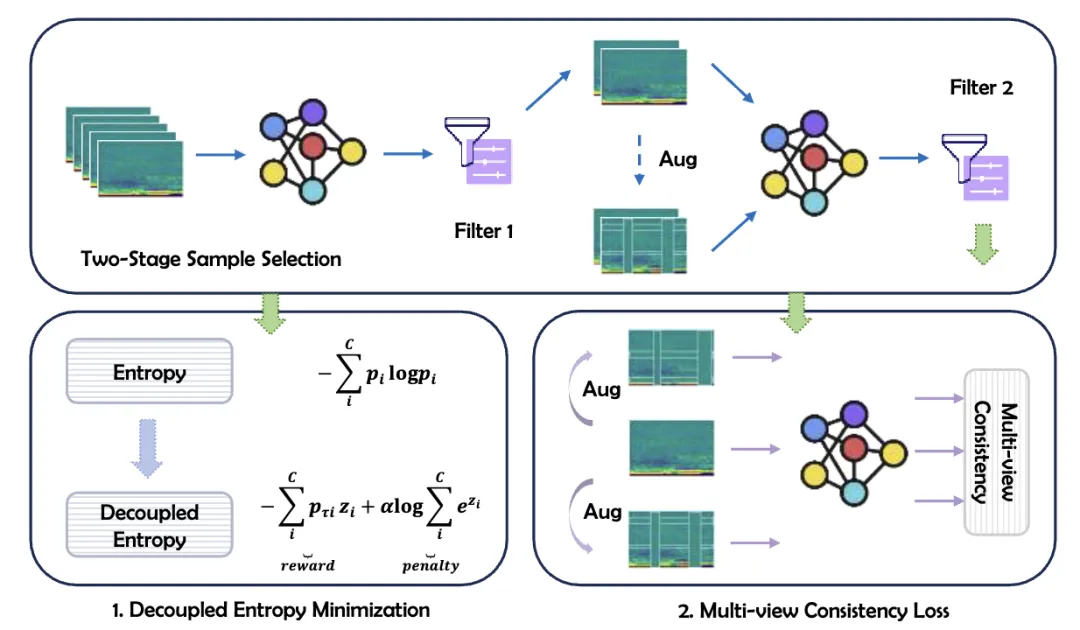
关键词检测需要从语音中识别特定词语,但环境噪声会显著降低准确率。测试时自适应可以利用无标签测试音频进行适应,但现有方法难以处理关键词稀有、背景类频繁的严重类别不平衡问题,导致熵最小化过度偏向背景类。该论文提出 ImKWS,将熵更新过程拆分为 reward branch 和 penalty branch,并为两者设置不同更新强度,同时加入多种音频变换下的一致性约束以稳定更新。实验表明,ImKWS 在 Google Speech Commands 的真实不平衡场景中能实现更可靠的测试时适应。
13、The First Environmental Sound Deepfake Detection Challenge: Benchmarking Robustness, Evaluation, and Insights
Han Yin, Yang Xiao, Rohan Kumar Das, Jisheng Bai, Ting Dang
合作单位:韩国科学技术院,富迪科技新加坡,西安邮电大学,西安联丰声学科技有限公司
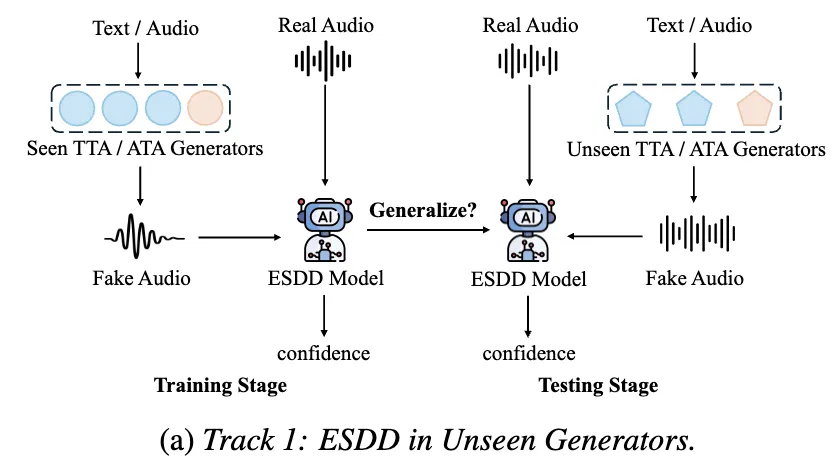
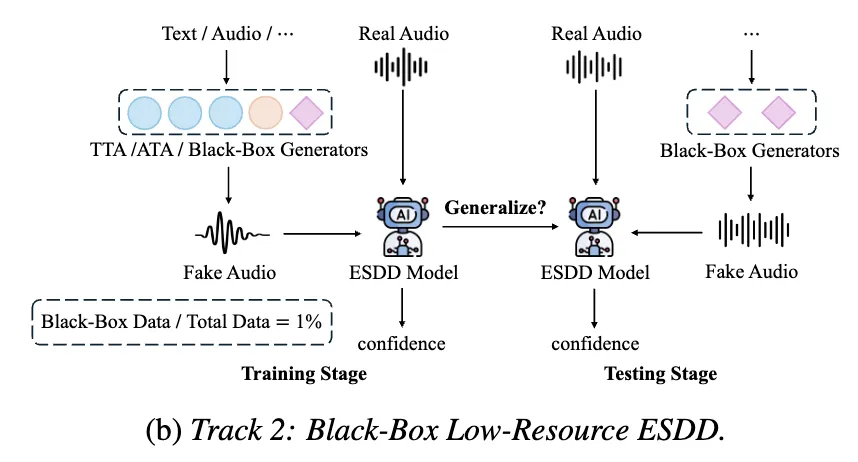
随着音频生成技术进步,逼真的环境声音越来越容易被合成,例如虚假警报、枪声或人群声音,这可能带来公共安全和信息可信度风险。虽然语音和歌声 deepfake 检测已有大量研究,但环境声音 deepfake 检测仍然不足。该论文总结了首届 ESDD Challenge,包括任务定义、数据集构建、评测协议、基线系统和挑战结果分析。该挑战吸引了 97 支注册队伍,并收到 1,748 次有效提交。论文还分析了高排名系统常用的结构设计和训练策略,并讨论了未来 ESDD 研究的关键方向。
14、BG-CRNN: Boundary-Guided Dynamic Attention for Sound Event Detection in Complex Scenarios
Zongmu Lin, Zhongxin Bai, Jisheng Bai, Zhenru Li, Ting Dang, Gongping Huang, Jingdong Chen, Jacob Benesty
合作单位:武汉大学,西安邮电大学,魁北克大学
现有声音事件检测(Sound Event Detection, SED)系统在复杂噪声环境下通常会出现严重的性能下降。为了解决这一问题,本文提出了一种具备噪声鲁棒性的边界引导卷积循环神经网络(Boundary-Guided Convolutional Recurrent Neural Network, BG-CRNN)。该方法引入动态边界注意力模块,通过预测声音事件边界来构建掩码,使自注意力严格限制在单个事件片段内部,从而避免目标声音特征受到相邻背景噪声的干扰。此外,边界引导注意力模块利用这些边界特征生成门控权重,自适应增强活跃事件区域。基于 WildDESED 数据集的实验表明,BG-CRNN 在 10 dB 到 -5 dB 的不同信噪比条件下均持续优于基线方法。尤其是在极端 -5 dB 条件下,该方法仍取得 0.191 的 PSDS1 分数,证明了其较强的噪声鲁棒性。
15、Adaptive Federated Fine-Tuning of Self-Supervised Speech Representations
Xin Guo, Chunrui Zhao, Hong Jia, Ting Dang, Gongping Huang, Xianrui Zheng, Yan Gao
合作单位:武汉大学,奥克兰大学,剑桥大学,Flower Labs
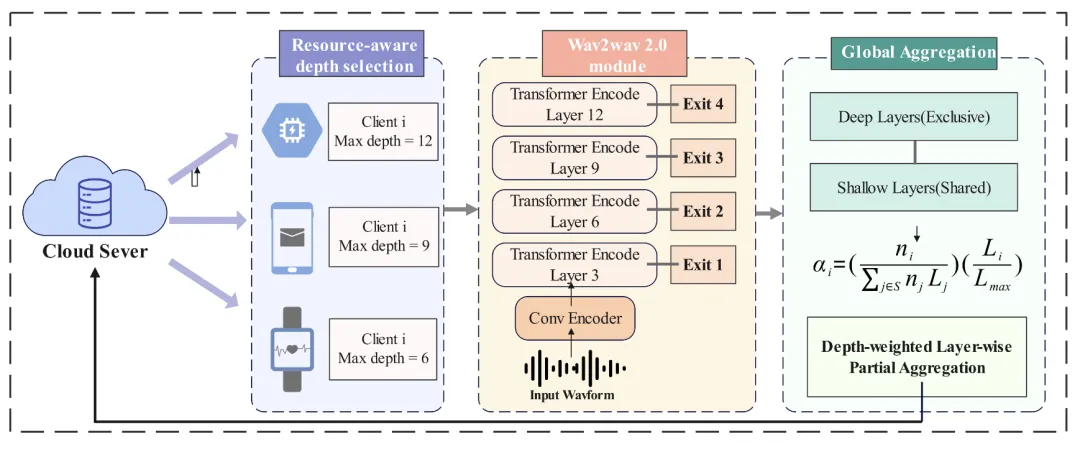
将联邦学习与自监督语音表示结合,可以在保护隐私的前提下进行语音任务微调。然而,联邦环境中客户端之间存在显著异质性,例如计算能力不同会造成 straggler effect,不同下游任务也可能需要不同深度的表示,导致完整模型更新效率低。该论文提出带 early exits 的 adaptive federated fine-tuning 框架,在 SSL backbone 的中间层加入轻量预测头,使客户端能够根据本地算力和任务需求提前结束计算。作者还提出 layer-wise、depth-aware 的部分聚合策略,以更好利用不同网络深度的表示。实验表明,该方法能降低边缘端开销,支持异构硬件,并保持有竞争力的性能。
五、神经元群组
Neural Assemblies
16、长文:Beyond Deep Learning: Speech Segmentation and Phone Classification with Neural Assemblies
Tom Adelson, Vidhyasaharan Sethu, Ting Dang
合作单位:新南威尔士大学
长文:Long Paper Track
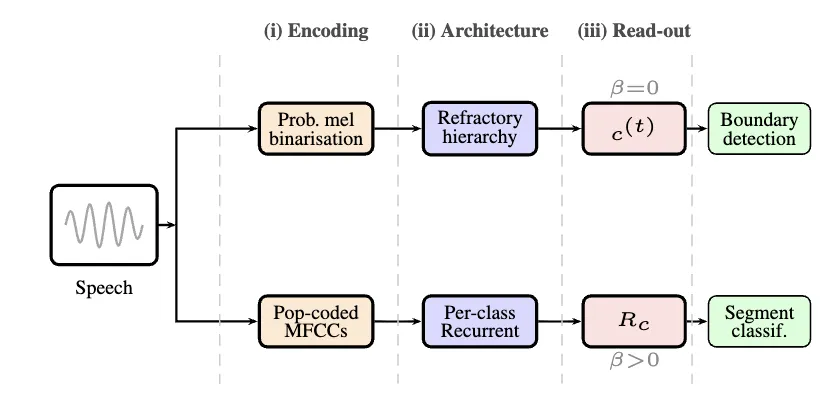
该工作探索一种超越传统深度学习的语音处理框架,基于 Assembly Calculus 构建稀疏神经 assembly 表示,并直接处理连续语音。论文提出三项核心设计:将语音编码为 assembly-compatible spike patterns 的神经编码方式;按照层级时间尺度和类别组织的多区域架构;以及用于下游任务的跨区域更新机制。该方法尝试用更具生物启发性的 Hebbian plasticity 和 winner-take-all competition 来完成语音分割与音素分类,为传统依赖大规模数据、反向传播和稠密表示的深度学习方法提供另一种思路。
