
 语音小管家
实时语音转换(Streaming Voice Conversion, VC)是虚拟人、实时变声、隐私通话等应用的核心技术。它的目标很明确:在极低延迟下,将源说话人的音色转换为目标说话人,同时保留内容和韵律。
然而,现有的流式零样本 VC 方法陷入了一个“不可能三角”的死循环:
信息瓶颈(IB)派:为了剥离源音色,强制提取离散单元或发音特征。
代价:丢失了韵律(Prosody)等信息。
补救:必须显式注入基频(F0)等特征。
瓶颈:为了稳定计算 F0,往往需要缓冲未来帧(Lookahead),导致算法至少向未来看40-60ms,增加时延。
说话人扰动(Perturbation)派:试图通过扰动源语音来模糊音色。
代价:难以平衡音色泄露(Timbre Leakage)与效用保留(Utility Preservation)。
现状:要么音色去不干净(泄露严重),要么把过度破坏韵律。
核心矛盾:如何在不偷看未来(Zero-Lookahead)的前提下,既剥离源音色,又更好地保留韵律细节?
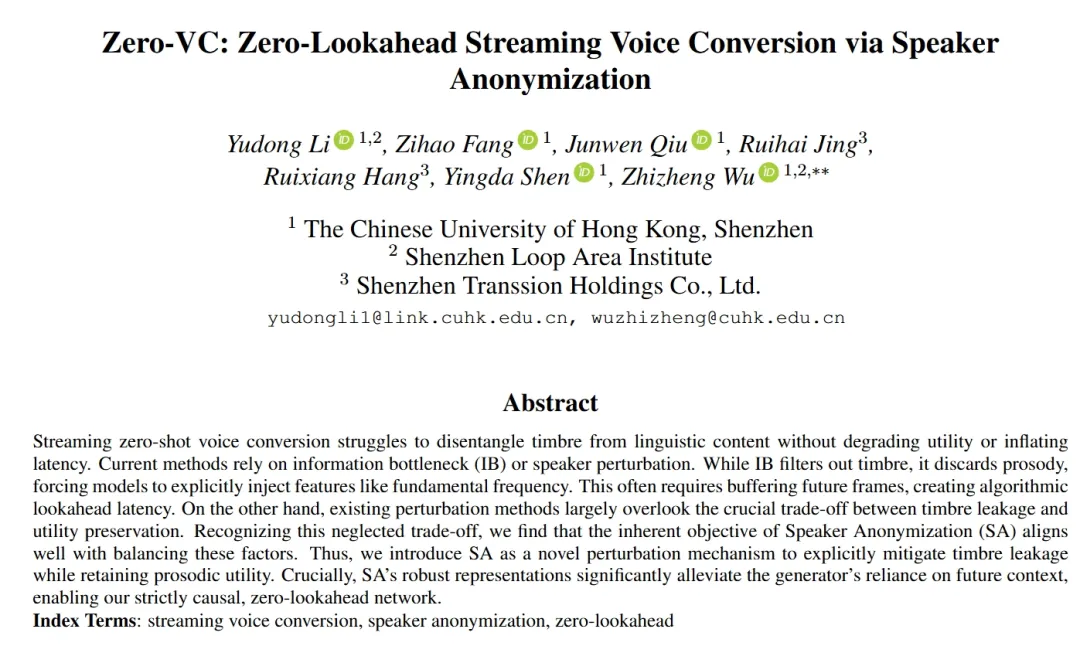
安菲翁社区和传音科技给出了一个巧妙的跨界思路:引入“说话人匿名化(Speaker Anonymization, SA)”技术。
「解决方案」
核心洞察:说话人匿名化(SA)是天生的“完美扰动器”
研究团队发现,SA 的核心目标——“隐藏说话人身份,同时尽可能保留语言内容和韵律效用”——与 VC 对内容特征的需求完美契合。
现有的扰动方法往往是为了扰动而扰动,忽略了平衡;而 SA 是经过专门优化来解决这个平衡问题的。
SA 的优势:它能将源语音映射到一个“伪说话人”空间,天然地抹去源音色,同时最大程度保留时间对齐、韵律轮廓和语音完整性。
架构红利:由于 SA 提供的特征本身就具有极高的韵律完整性和时间稳定性,生成器(Decoder)不再依赖未来上下文来“脑补”平滑的韵律轨迹。
Zero-VC:真正的零 lookahead 流式架构
基于此,我们提出了 Zero-VC,一个严格因果(Strictly Causal)、零前瞻(Zero-Lookahead)的流式语音转换框架。
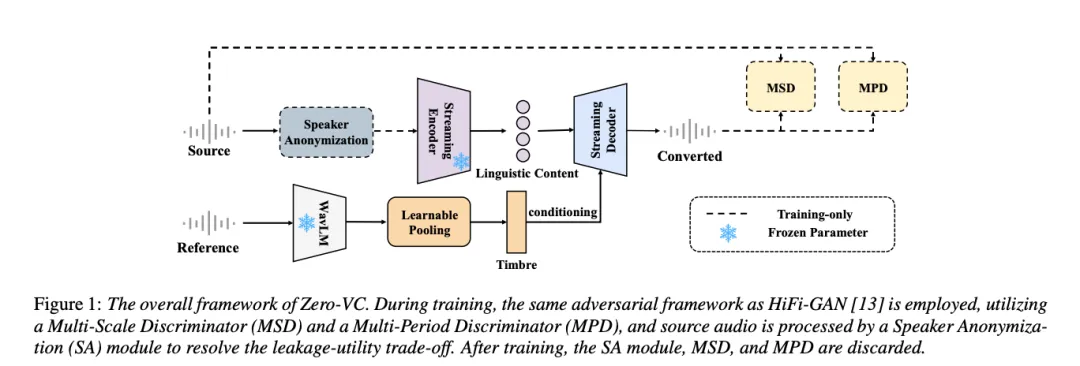
图 1:Zero-VC 整体框架
关键技术点:
训练时基于 SA 的内容提取:
在模型训练时,源语音首先通过现成的 SA 模块处理,生成“匿名化语音”。 该语音输入到流式编码器中,提取语言内容特征。 SA模块只在训练时使用,并不会在推理流程中使用 关键点:整个过程无需任何未来帧(0ms lookahead),帧移仅为 20ms。 音色编码:
利用 WavLM-large 从参考语音中提取音色特征,通过可学习的注意力池化层聚合为全局音色嵌入(Timbre Embedding)。
严格因果的流式解码器:
基于 HiFi-GAN 架构,但将所有卷积替换为因果卷积(Causal Convolution)。
确保当前帧的生成完全不依赖任何未来信息。
推理时采用状态缓存(State Cache)机制,计算复杂度为 O(1),实现恒定的超低延迟。
「效果验证:到底解决了什么?」
我们在 LibriTTS 数据集上训练,并在 Seed-TTS-Eval 数据集上进行了全面评估,对比了先前 LSCodec、Seed-VC 等方法所使用的扰动(perturbation)策略
1. 扰动策略对比:
首先对比不同扰动策略生成的中间音频质量。
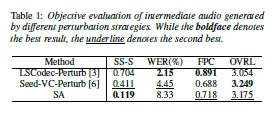
表 1:不同扰动策略的中间音频评估
音色泄露(SS-S):LSCodec 泄露严重(0.704),Seed-VC 有所改善(0.411),而SA 几乎完全消除了源音色(0.119)。
韵律保留(FPC):SA 在更好地去除音色的同时,韵律保留度(0.718)优于 Seed-VC(0.688)。尽管处理的音频WER较高,但后续的结果说明,这并不会严重影响所训练模型的可懂度。
结论:SA 更好地平衡了音色泄露(Timbre Leakage)与效用保留(Utility Preservation)。
2. 核心突破:不再需要“偷看”未来
这是 Zero-VC 最震撼的实验结果。团队测试了模型在不同“前瞻长度(Lookahead Context)”下的性能提升。
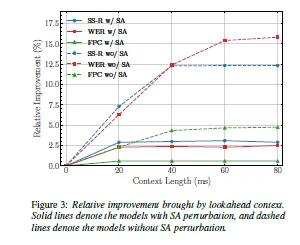
图 3:前瞻上下文带来的相对提升
无 SA 模型(虚线):严重依赖未来信息。需要 40-60ms 的前瞻才能稳定性能,提升幅度高达 12%-15%。
Zero-VC (SA 模型,实线):性能在 0-20ms 处即饱和。即使提供高达 80ms 的未来信息,性能提升也不到 3%。
意义:这证明了模型极大减轻了对未来信息的依赖程度。这使得零前瞻(zero-lookahead)架构成为可能且高效。
3. 综合性能 SOTA:延迟最低,效果最好
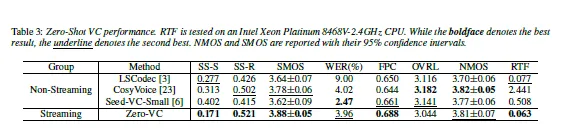
表 3:零样本语音转换性能对比
音色转换质量:
源音色泄露(SS-S):Zero-VC 达到最低的0.171(优于所有非流式基线)。
目标音色相似度(SS-R):Zero-VC 达到最高的0.521。
主观相似度(SMOS):3.88,全场最高。
效用与质量:
韵律保留(FPC):0.688,全场最高。
可懂度(WER):3.96%,仅次于 Seed-VC-Small。
自然度(NMOS):3.81,与强大的非流式模型 CosyVoice 相当。
延迟与效率:
算法延迟:仅20ms(单帧),远低于 IB 方法的 40-60ms。
实时率(RTF):0.063(在 CPU 上),轻松满足实时通信需求。
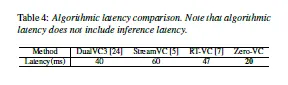
表 4:算法延迟对比
「典型失败案例 vs 成功案例」
传统 IB 方法(如 StreamVC):
现象:为了计算平滑的 F0,必须等待未来 60ms 的数据。
后果:在实时通话中,用户会感觉到明显的“滞后感”,体验大打折扣。如果强行去掉 lookahead,生成的语音韵律会断裂、机械。
Zero-VC:
现象:说完即转,帧进帧出(20ms 延迟)。
效果:生成的语音不仅音色转换彻底(听不出原声),而且韵律自然流畅,情感保留完整,仿佛目标说话人就在现场实时复述。
「总结」
Zero-VC 通过引入说话人匿名化(SA)这一跨界技术,解决了流式语音转换中长期的“延迟 - 质量”瓶颈:
过去:为了保质量,不得不牺牲延迟(引入 Lookahead);为了保延迟,不得不牺牲质量(韵律丢失)。
现在:利用 SA ,减轻生成器对未来上下文的依赖,实现了20ms理论最小延迟下的高保真转换。
核心贡献:
新视角:首次将说话人匿名化(SA)作为扰动机制引入 VC,更好地平衡了音色泄露与效用保留。
新架构:提出了严格因果、零前瞻(Zero-Lookahead)的流式架构,将算法延迟降至单帧(20ms)。
新 SOTA:在延迟最低的情况下,实现了优于非流式模型的音色转换质量和韵律保留度。
局限与展望:训练时,当前系统依赖外部的 SA 模块进行预处理,可能引入额外的训练开销。未来工作将致力于将 SA 目标端到端地集成到流式编码器的训练目标中,进一步降低系统训练开销,并拓展至跨语言转换场景。
想象一下,未来的实时翻译、游戏语音、隐私通话中,声音转换将不再有任何“缓冲感”,真正实现“所说即所得”的无缝体验。Zero-VC 让这一愿景触手可及。
