
 语音小管家
当视觉信息丢失、模糊或被遮挡,模型 还能否精准地从嘈杂人声中提取出目标说话人的声音?本文提出的MeMo 框架,借鉴人类大脑的「注意力动量」机制,让模型像人一样——只要看一眼,就能持续聚焦。 在视觉受损场景下,MeMo 取得了约27% 的相对性能提升,且满足实时流式处理要求。
📄 发表:IEEE Transactions on Audio, Speech and Language Processing (TASLP), 2026
🎧 演示 & 代码:https://mrjunjieli.github.io/demo_page/MeMo/index.html
1. 一个真实的问题:当 模型「看不见」时
想象你正在参加一场鸡尾酒会,想听清楚朋友在说什么,但他的脸被人群挡住了,或者光线太暗看不清嘴唇——这时,你依然能靠记忆和上下文努力跟上对话。
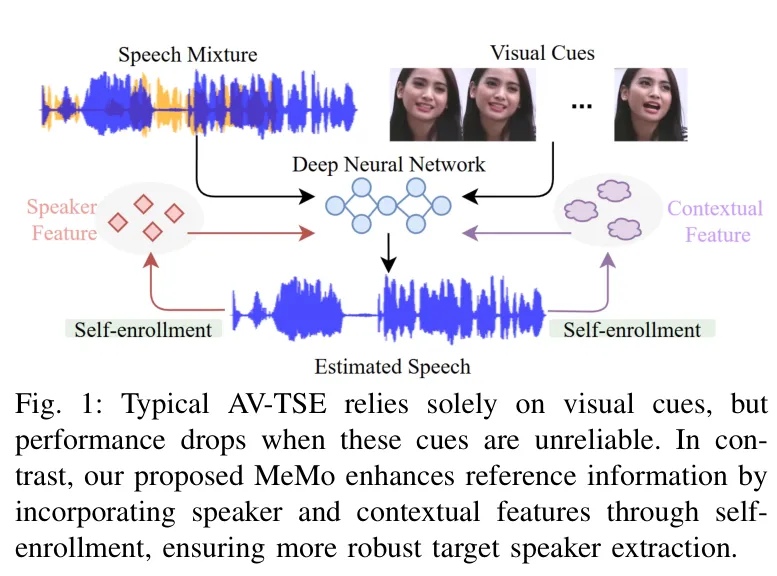
然而,现有的音视频目标说话人提取(AV-TSE)系统做不到这一点。这类系统的核心思路是:盯着目标说话人的嘴唇,从嘈杂的混合语音中分离出他/她的声音。可一旦视觉信息出问题——
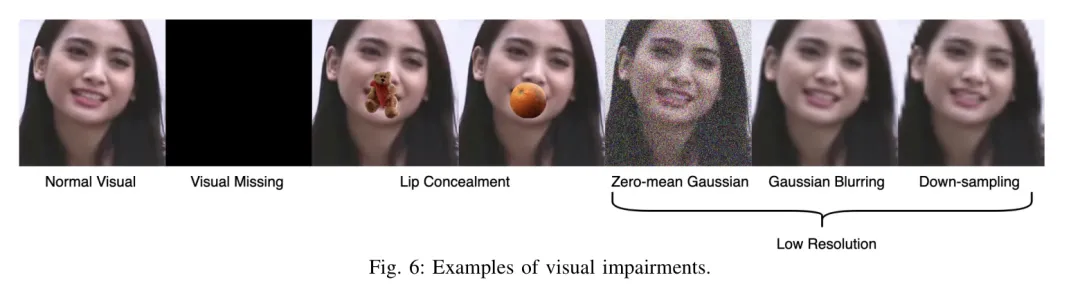
🔴视觉丢失:人脸完全检测不到; 🔴嘴唇遮挡:说话人用手或话筒挡住了嘴; 🔴低分辨率:画面模糊、噪声严重。
——系统性能就会急剧下降,这严重限制了 AV-TSE 在真实场景中的落地。
2. 灵感来源:人类大脑的「注意力动量」
神经科学研究发现,人类在持续关注某个声源时,选择性听觉注意力会随时间逐渐增强。这依赖于工作记忆(Working Memory)——大脑会不断存储、更新当前注意力的焦点。
一个典型现象是「Look Once to Hear」(看一眼就能听):哪怕只瞥了一眼说话人,大脑也能在之后维持稳定的听觉聚焦。
🎯 核心洞察:能不能让 模型 也拥有这种能力?即使当前视觉不可靠,也能从「历史记忆」中提取注意力信号,维持对目标说话人的聚焦?这正是 MeMo(Attentional Momentum,注意力动量) 的由来。
3. MeMo 框架:双记忆库驱动的注意力动量
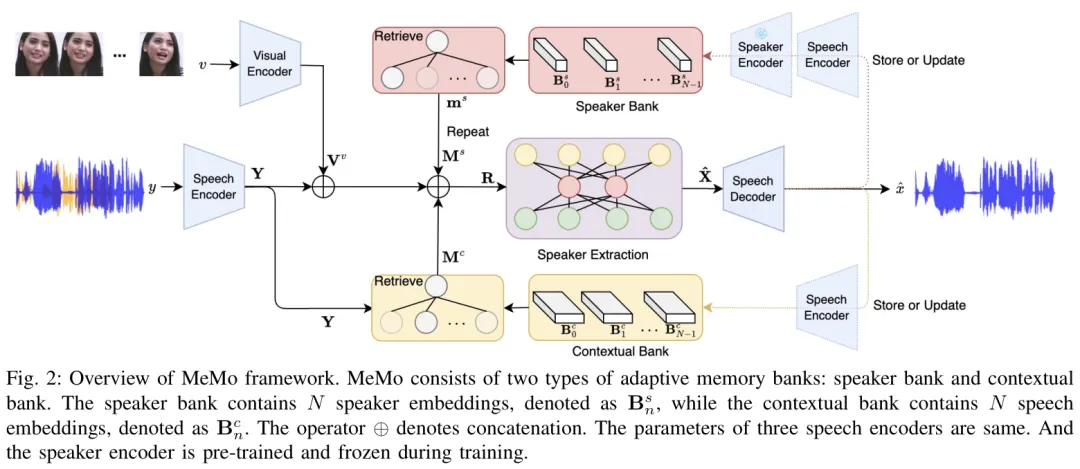
MeMo 的核心思想非常优雅:让模型从自己之前提取出的语音中,学习「该关注谁」和「在说什么」,并用这些历史信息来补偿当前不可靠的视觉线索。
它不是某个特定模型的结构,而是一个通用框架,可嵌入各种 AV-TSE 架构。其核心是两个自适应记忆库(Adaptive Memory Banks):
工作流程上,第 0 步(冷启动)仅用视觉线索完成首次提取,并把结果「自我注册」(Self-Enrollment)存入两个记忆库;之后每一步都从记忆库中检索最相关的历史信息,与当前视觉、当前混合语音一起融合,得到更鲁棒的提取结果,再用 FIFO 或注意力分数(ABS)策略更新记忆库。
4. 实验:视觉受损下约 27% 的相对提升
作者在VoxCeleb2上模拟了三类视觉损伤——视觉丢失、嘴唇遮挡、低分辨率,并以 TDSE 为基线、在在线流式模式下评测。
4.1 上下文记忆库——真正的杀手级特性
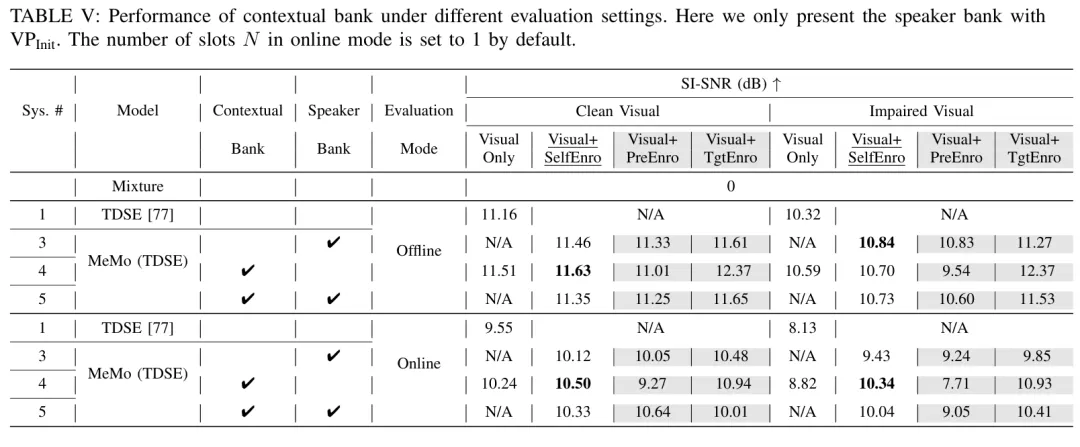
下表中,对比「仅视觉(Visual Only)」与加入记忆库后的「Visual+SelfEnro」:在线模式(Online)受损视觉下,SI-SNR 从8.13 dB 提升到 10.34 dB,提升超过 2 dB;而且自注册(SelfEnro)已逼近使用真实目标语音(TgtEnro)的理论上限。
4.2 对不同视觉损伤类型的鲁棒性
无论哪种损伤类型,配备上下文记忆库的 MeMo(System 4)都保持着惊人一致的高性能——这说明上下文信息能有效补偿任何形式的视觉退化。
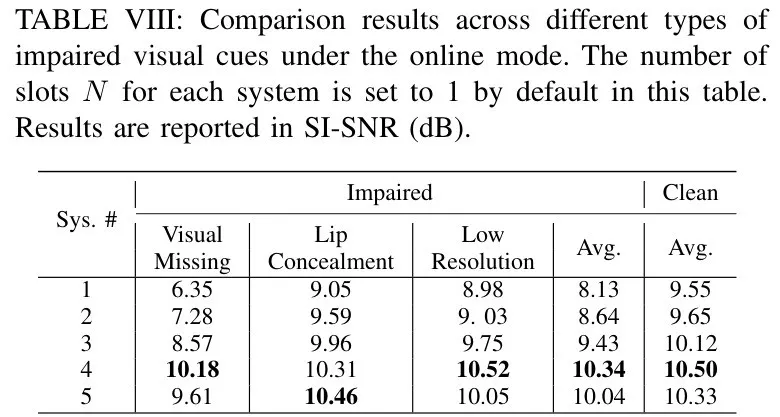
🎉 惊人的一致性:基线在「视觉完全丢失」时只剩 6.35 dB,而 MeMo 仍有 10.18 dB;嘴唇遮挡、低分辨率两类损伤也分别提升到 10.31 / 10.52 dB。
4.3 长时语音:基线衰减,MeMo 依旧稳定
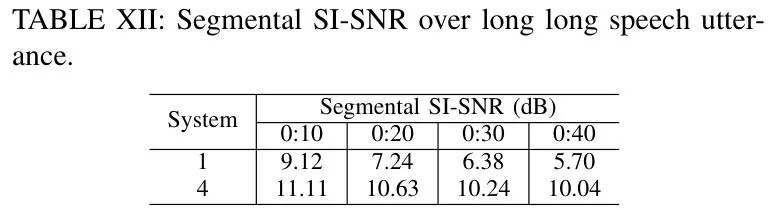
随着语音变长,基线模型会持续掉点(40s 时仅剩 5.70 dB),而 MeMo 凭借不断累积的记忆,始终稳定在 10 dB 左右。
4.4 通用性:换骨干网络一样能涨
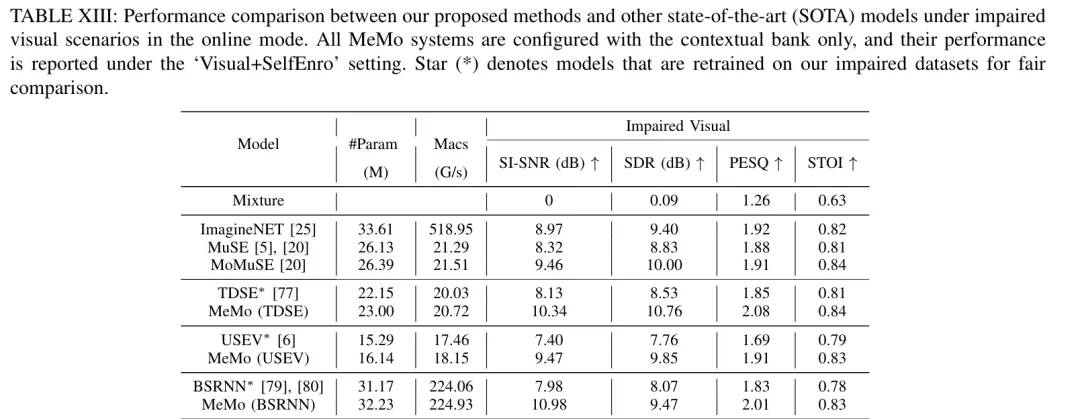
作为通用框架,MeMo 在 TDSE、USEV、BSRNN 三种不同骨干上均取得显著提升,且新增参数量与计算量都很小;与多个 SOTA 方法相比也全面占优。
6. 一些有趣的发现
- 上下文 > 说话人:
说话人记忆库有帮助但有限,上下文记忆库才是真正的大杀器——上下文信息高度时间敏感,最新的嵌入最有用。 - 两者合用反而不好:
同时启用两个记忆库并不互补,可能因信息冗余或冲突导致性能下降。 - Transformer 不太行:
CNN/RNN 骨干在该框架下表现稳定,而 Transformer 对「视觉 → 视觉+语音」的模态切换分布偏移很敏感。 - 说话人切换不需手动清库:
在对话中目标突然切换时,MeMo 能自适应追踪新目标,切换点附近仅轻微下降。
7. 总结
MeMo 提出了注意力动量(Attentional Momentum)这一新颖概念,灵感源自人类认知机制。通过说话人与上下文两个自适应记忆库,它让 AV-TSE 系统在视觉不可靠时,依然能维持对目标说话人的精准聚焦。
✅通用框架:可集成到多种 AV-TSE 架构; ✅显著提升:受损视觉下约 27% 的相对改善; ✅实时处理:RTF≈0.11,满足在线流式延迟要求; ✅强鲁棒性:对各种视觉损伤类型与比例保持稳定; ✅自适应切换:能应对目标说话人动态变化的场景。
💬 一句话总结:MeMo 赋予了 AI「看一眼就够了」的能力——即使视觉受损,也能像人类一样,靠「注意力动量」持续追踪目标说话人的声音。
论文:MeMo: Attentional Momentum for Real-time Audio-visual Target Speaker Extraction under Impaired Visual Conditions
作者:Junjie Li*, Wenxuan Wu*, Shuai Wang†, Zexu Pan, Kong Aik Lee, Helen Meng, Haizhou Li
