
 语音小管家
近日,Interspeech 2026 公布了论文录用结果,上海交通大学跨媒体语言智能实验室共7篇论文被会议接收。Interspeech 是由国际语音通信协会(ISCA)组织的语音研究领域的顶级会议之一,是全球最大的综合性语音信号处理领域的科技盛会。本届会议以“Speaking Together”为主题,内容涵盖语音识别、语音合成、语音编码、语音增强、自然语言处理等多个领域。
01、The Interspeech 2026 Audio Reasoning Challenge: Evaluating Reasoning Process Quality for Audio Reasoning Models and Agents
论文作者:马子阳, 徐瑞阳, 马英浩, Chao-Han Huck Yang, 李波含, Jaeyeon Kim, 徐进, 李锦宇, Carlos Busso, 俞凯, Eng Siong Chng, 陈谐
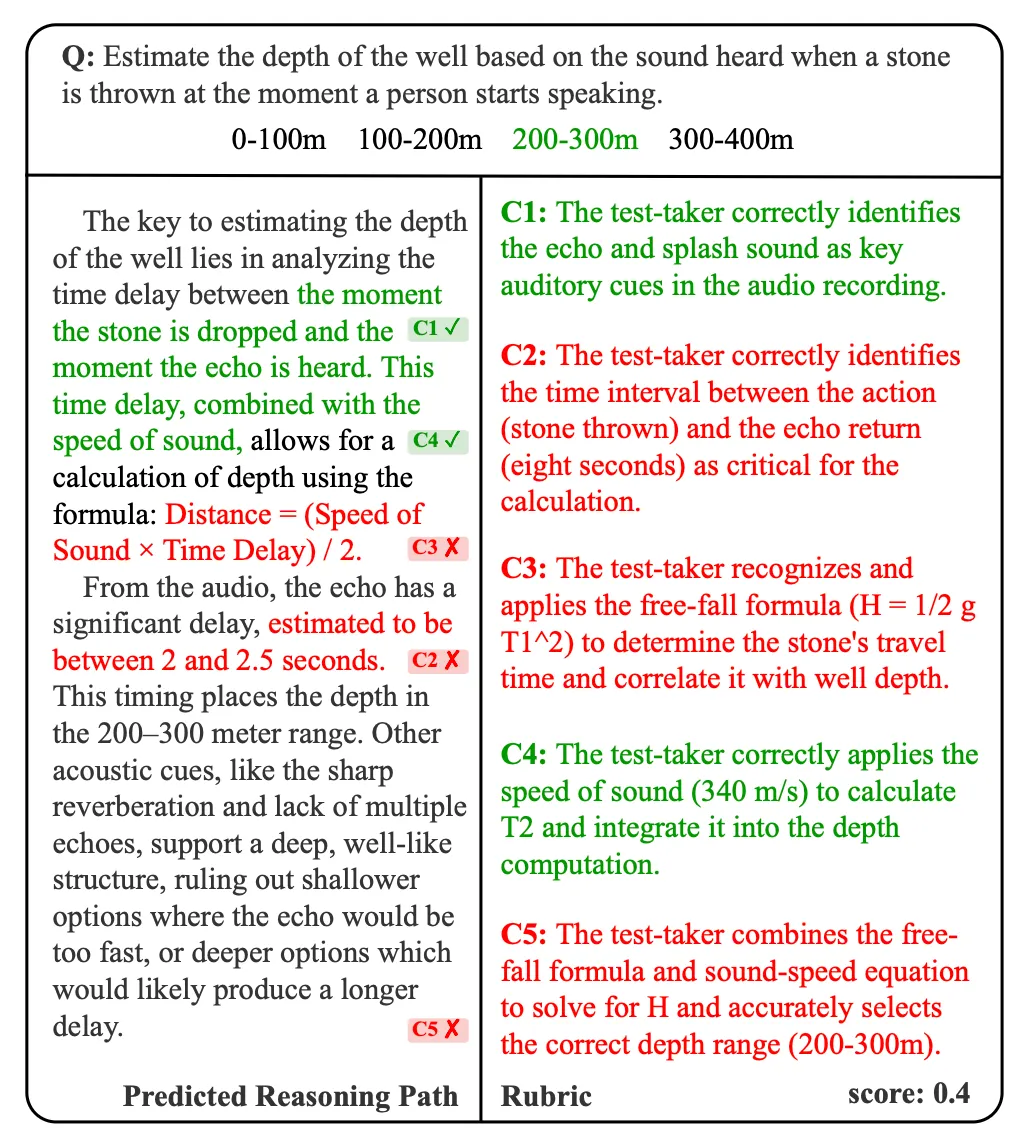
论文简介:近期的大型音频语言模型(LALMs)在音频理解方面表现出色,但往往缺乏透明的推理过程。为了解决这一“黑盒”局限性,我们在 Interspeech 2026 上组织了音频推理挑战赛(Audio Reasoning Challenge),这是首个专门用于评估音频领域思维链(Chain-of-Thought, CoT)质量的任务。本次挑战赛引入了 MMAR-Rubrics——一种新型的实例级评估协议,用于评测推理链的真实性与逻辑性。大赛设立了“单模型(Single Model)”和“智能体(Agent)”两大赛道,吸引了来自 18 个国家和地区的 156 支队伍参赛。结果表明,目前智能体系统在推理质量上处于领先地位,这主要得益于它们能够运用迭代式工具编排和跨模态分析。同时,单模型也在通过强化学习和更精细的数据流水线实现快速突破。我们详细阐述了本次挑战赛的设计、方法论以及对前沿系统的全面分析,为可解释性音频智能提供了全新的见解。
02、RAS: a Reliability Oriented Metric for Automatic Speech Recognition
论文作者:黄文宾,邱雨航,李波含,郭奕玮,彭景,王翰坤,陈谐,俞凯
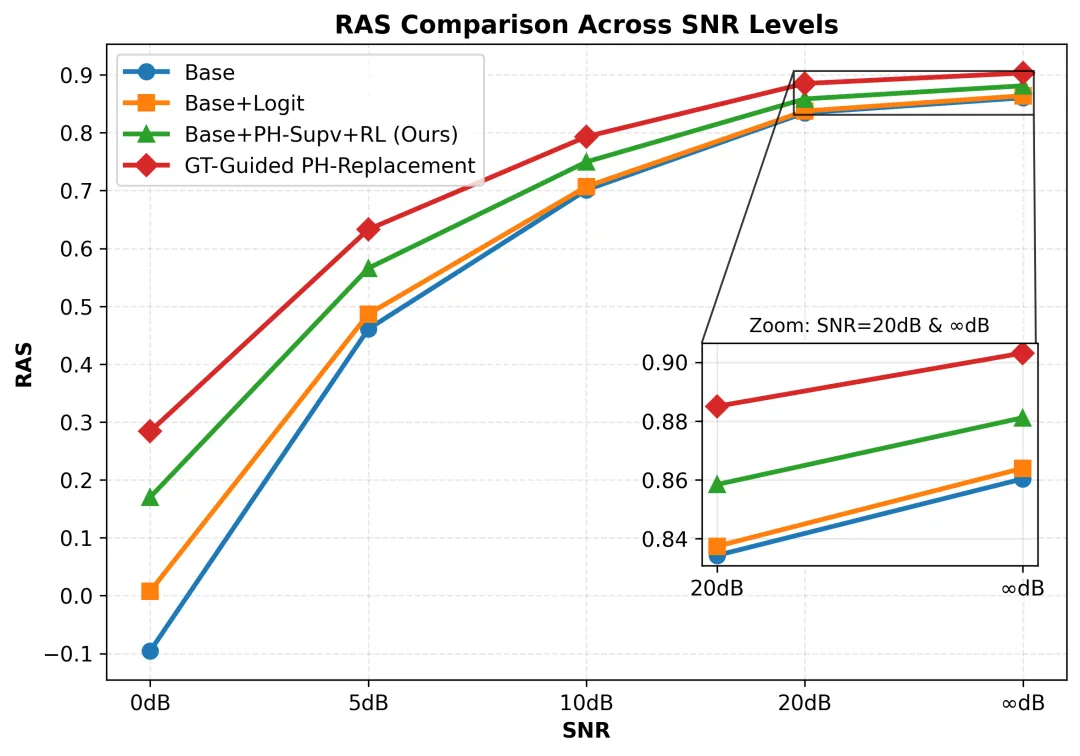
论文简介:自动语音识别系统在噪声或语义歧义条件下,往往会生成看似置信度较高但实际错误的转录结果,从而可能对用户及下游应用产生误导。传统基于词错误率(Word Error Rate, WER)的评估方法仅关注识别准确率,难以刻画转录结果的可靠性。本文提出一种具备弃权感知能力的转录框架,使语音识别模型能够在不确定片段上显式选择弃权。为评估包含弃权行为的识别可靠性,本文进一步提出可靠性导向指标 RAS,该指标在转录信息量与错误规避之间进行权衡,其权衡参数通过人类偏好进行校准。在模型训练方面,我们首先采用监督式自举训练进行初始化,随后结合强化学习方法训练具备弃权能力的语音识别模型。实验结果表明,在保持具有竞争力识别准确率的同时,所提出方法能够显著提升转录结果的可靠性。
03、Semantic-VAE: Semantic-Alignment Latent Representation for Better Speech Synthesis
论文作者:牛志康,胡书杰,Jeongsoo Choi,陈禹伸,陈沛宁,朱鹏程,杨云亭,张博闻,赵剑,王春惠,陈谐
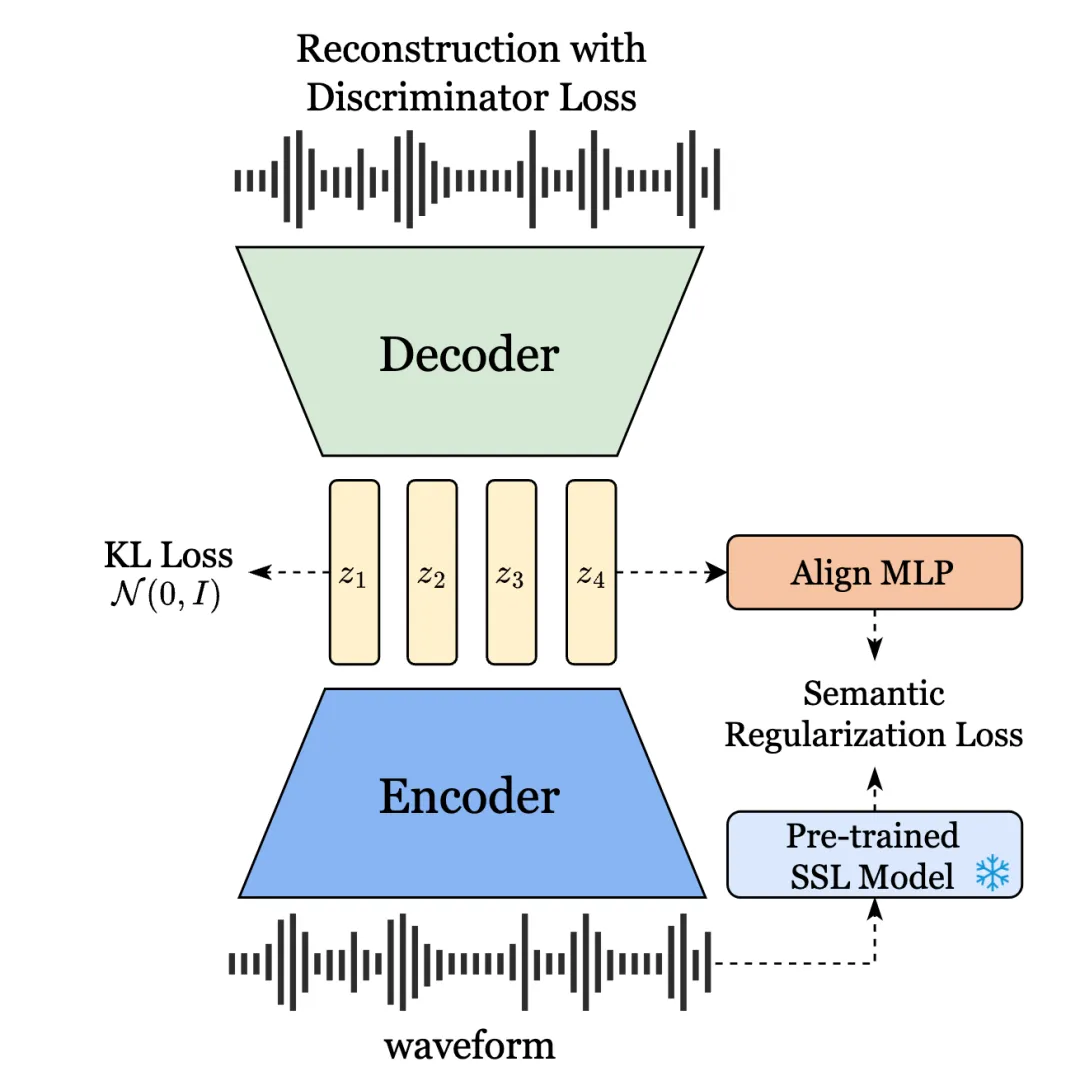
论文简介:Mel 频谱已被广泛用于零样本文本转语音(TTS)任务;然而,其固有的冗余性会导致文本-语音对齐效率较低。紧凑的基于 VAE 的潜在表示已经成为一种更具优势的替代方案,但它们也面临一个优化困境:高维潜变量能够提升重建质量和说话人相似度,却会降低可懂度;低维潜变量则能提升可懂度,但会牺牲重建保真度。为了解决这一困境,本文提出 Semantic-VAE,在潜在空间中引入语义对齐正则化。该设计通过在高维潜在表示中捕获语义结构,缓解了重建与生成之间的权衡问题。当集成到 F5-TTS 中时,该方法在 LibriSpeech-PC 上取得了 2.10% 的 WER 和 0.64 的说话人相似度,优于基于 Mel 的系统和普通声学 VAE 基线,同时提升了训练效率。
04、VISA: A Visual Information Strengthened Audio-Reasoning System for the Interspeech 2026 ARC Agent Track
论文作者:涂文明,高见,霍彦儒,王奕璇,彭景,李波含,马子阳,刘涛,王帅,樊帅,俞凯,陈谐,郑子隆
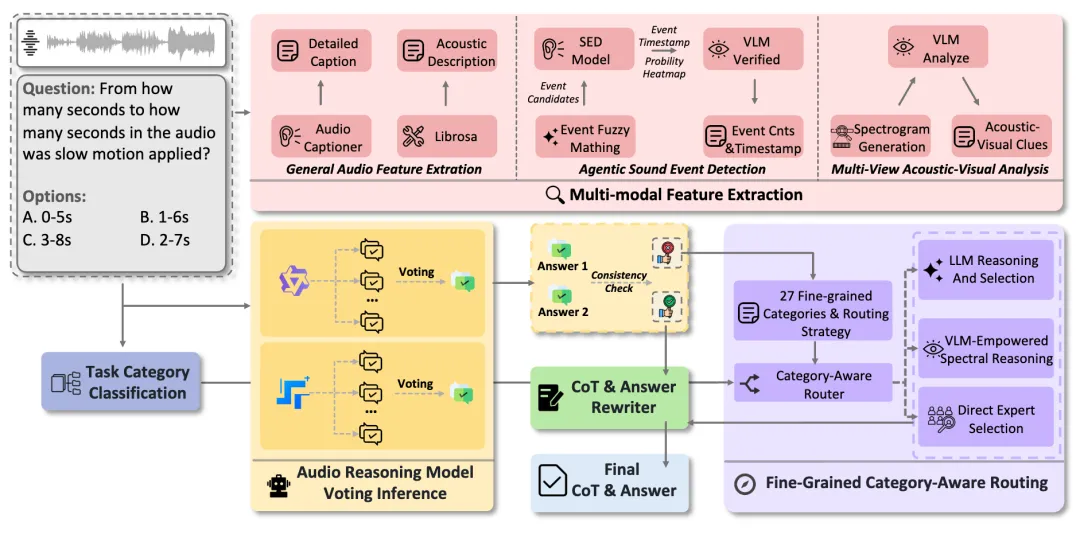
论文简介:音频推理需要对时间动态变化且声学混合的信号进行多步、基于证据的推断,其复杂性超过了 ASR 或 captioning 等传统感知任务。我们提出 VISA,这是我们提交至 Interspeech 2026 Audio Reasoning Challenge(Agent Track)的系统,并采用 MMAR Rubrics 从正确性和推理质量两个方面进行评估。在 “LALM as a Tool” 范式下,VISA 通过引入辅助性的多模态证据来增强大型音频语言模型的推理能力,同时避免过于复杂的系统编排。该系统主要包括三个组成部分:第一,多模态特征提取,用于整合音频信息以及声学—视觉线索;第二,模型投票推理,通过一致性检查提高预测结果的稳定性;第三,细粒度的类别感知路由机制,用于处理不同模型之间的分歧,并选择更符合评分标准的推理链。根据官方 Agent Track 排行榜,VISA 以 66.23% 的 Rubrics 分数位列总排名第二。同时,VISA 取得了 77.40% 的准确率,是 Single Model 和 Agent tracks 所有上榜系统中的最高成绩。
05、TASU2: Controllable CTC Simulation for Alignment and Low-Resource Adaptation of Speech LLMs
论文作者:彭景,王程昊,杨熠,钱丽蓉,李俊杰,奚彧,王帅,俞凯
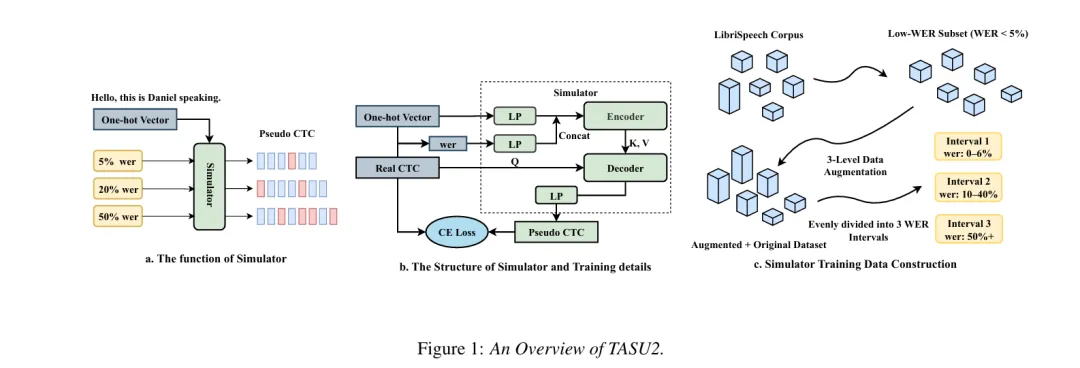
论文简介:语音大语言模型的后训练日益依赖高效的跨模态对齐与鲁棒的低资源适应,然而大规模音频-文本对的收集成本仍然高昂。TASU 等纯文本对齐方法通过从转录文本模拟 CTC 后验分布来减轻这一负担,但它们对不确定性和错误率的控制有限,使得课程设计在很大程度上仍依赖于启发式策略。本文提出 **TASU2**,一种可控的 CTC 模拟框架,能够在指定的词错误率(WER)范围内模拟 CTC 后验分布,生成与声学解码接口更加匹配的文本派生监督信号。这使得系统化的后训练课程成为可能,能够在无需语音合成(TTS)的情况下平滑地调节监督难度。在多种源域到目标域的适应设定下,TASU2 在领域内和领域外识别任务上均优于 TASU,并持续超越包括纯文本微调和基于 TTS 的数据增强在内的强基线方法,同时有效缓解了源域性能退化问题。
06、A Unified and Reproducible Experimentation Framework for Speech Understanding
论文作者:彭景,杜俊皓,王程昊,李翰奇,杨熠,王奕璇,顾笑与,陈冠豫,王雨诚,蒋李,赵章杰,王浩然,涂文明,李浩宇,马夺,钱丽蓉,奚彧,文雯,郭嘉琪,张辉, 樊帅,江文斌,王帅,俞凯
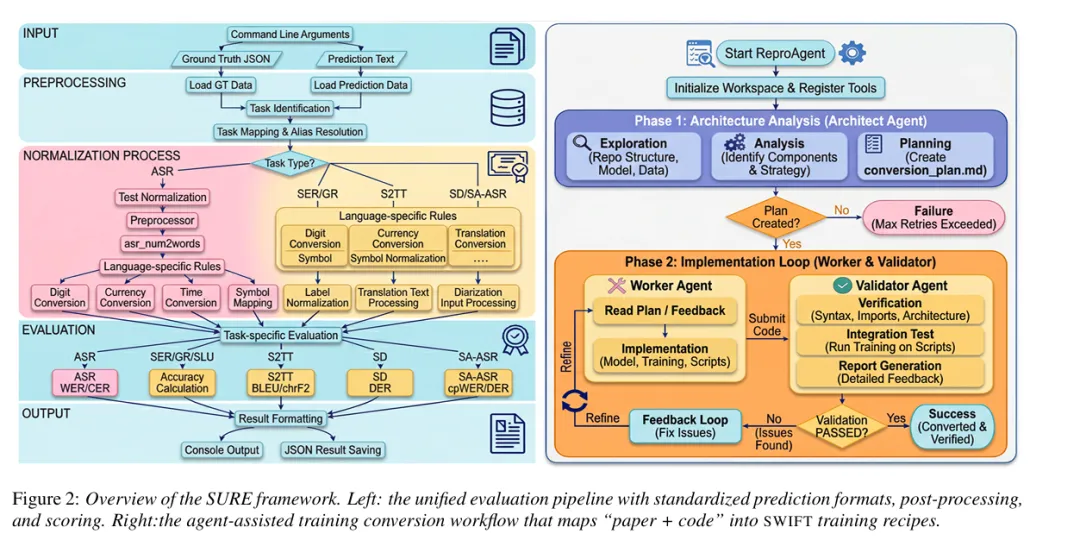
论文简介:语音基础模型与语音大语言模型推动了语音理解的进步,然而面向部署的模型选择却受到两方面阻碍:不匹配的后处理导致评估结果无法直接比较,且在不同数据规模与训练流程下,训练结果难以复现。本文提出 SURE,一个统一的实验框架,对预测格式、文本归一化及评分方式进行标准化。SURE 在真实的声学及语言学压力条件下,针对代表性任务对从传统流水线到语音大语言模型的各类强系统进行了跨范式评估。除评估外,SURE 还引入了智能体辅助的训练转换流程,将论文与代码映射为遵循统一协议、基于匹配开源数据子集的版本化、可运行训练流水线。总体而言,SURE 提升了面向部署的评估的可比性与可复现性。
完整论文:https://arxiv.org/abs/2605.30899
项目仓库:https://sure-eval-framework.github.io/speechllm_series/
07、Read What You Hear: Reference-Free Hypotheses Evaluation with Acoustic Discrepancy
论文作者:李之涵,王翰坤,郭奕玮,李波含,陈谐,俞凯
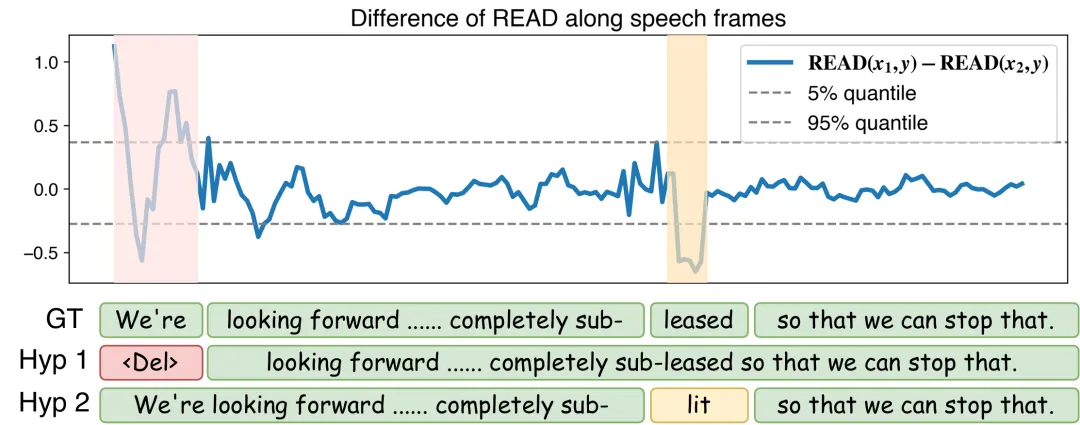
论文简介:自动语音识别系统通常依赖参考转写进行评估,而无参考方法则往往依赖于模型内部的置信度估计或辅助的语言模型。本文提出了READ(Reference-free Hypothesis Evaluation with Acoustic Discrepancy),一种新颖的评估指标,能够直接基于语音信号对ASR识别候选进行评估。READ强调识别候选的声学基础。该方法利用一个预训练的自回归文本到语音(TTS)模型,在给定文本假设的条件下计算语音token的条件似然,从而衡量语音与文本之间的细粒度声学差异。在无需额外训练的情况下,READ可用于识别候选的优化。实验结果表明,READ与具体的识别错误表现出相关性,并能够改善ASR识别结果,实现最高达20%的相对错误率降低,且在噪声环境下表现出尤为显著的提升。
