
 语音小管家
近日,第 64 届国际计算语言学年会(Annual Meeting of the Association for Computational Linguistics,ACL)公布了论文录用结果,上海交通大学跨媒体语言智能实验室共5篇论文被会议接收。ACL 年会是计算语言学和自然语言处理领域国际排名第一的顶级国际学术会议,由国际计算语言学协会组织,每年召开一次,在中国计算机学会(CCF)推荐会议列表中被列为 A 类会议。
01、Towards Fine-Grained and Multi-Granular Contrastive Language-Speech Pre-training
论文作者:杨亦凡*,韩冰*,王卉,王巍,马子阳,周龙,金增锐,杨冠柔,王天锐,谭旭,陈谐
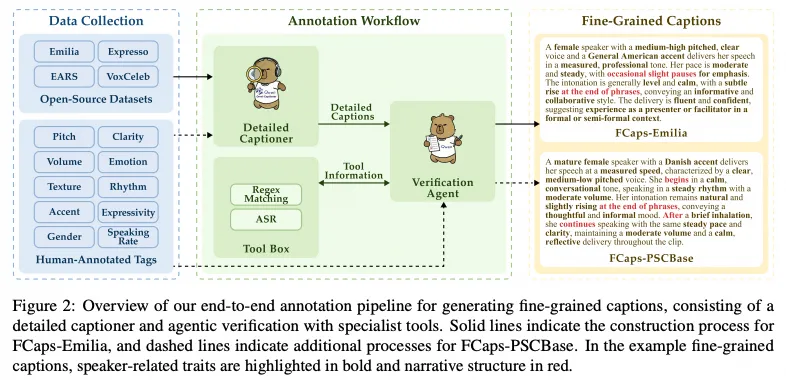
论文简介:细粒度说话风格建模在语言-语音表示预训练仍具有挑战性,现有的语音-文本模型通常使用粗粒度描述或特定任务的监督信号进行训练,且缺乏可扩展的细粒度风格标注数据。我们提出了 FCaps,这是一个具有细粒度自由文本风格描述的大规模数据集,涵盖 47,000 小时的语音和 1,900 万条细粒度字幕,通过一个新颖的端到端流程进行标注,该流程将详细描述直接与音频对齐,从而避免了现有级联流程中基于大语言模型(LLM)改写所导致的误差传播问题。使用"LLM 作为评判者"的评估方式表明,我们的标注在正确性、覆盖率和自然度方面均优于现有的级联标注方法。在 FCaps 的基础上,我们提出了 CLSP,这是一个对比语言-语音预训练模型,融合了全局与细粒度监督信号,从而实现跨多个粒度层次的统一表示。大量实验表明,CLSP 能够学习细粒度和多粒度的语音-文本表示,在全局及细粒度语音-文本检索、零样本副语言分类以及语音风格相似度评分等任务上均表现出色,并与人类判断高度一致。
02、SAC: Neural Speech Codec with Semantic-Acoustic Dual-Stream Quantization
论文作者:陈文熙,王新升,延瑞琦,陈禹伸,牛志康,马子阳,李希泉,梁宇哲,文翰林,尹顺顺,陶明,陈谐
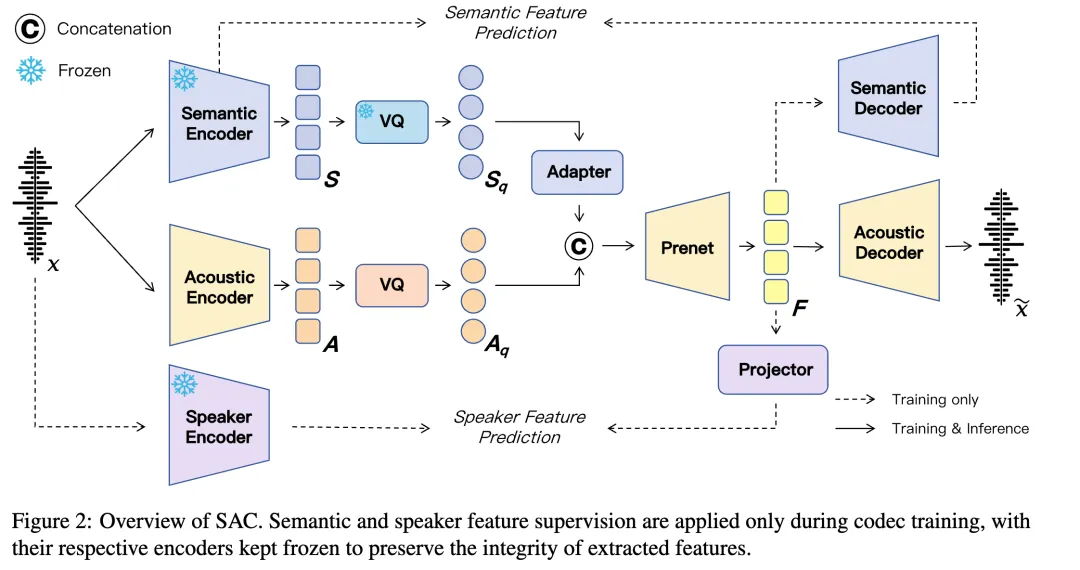
论文简介:语音编码器通过将连续语音信号转换为离散 token,已成为语音语言模型中的关键基础模块。然而,现有方法在高质量重建与语义表达能力之间难以取得平衡,从而限制了其在生成与理解任务中的整体效果。本文提出了一种神经语音编码方法 SAC(Semantic-Acoustic Dual-Stream Codec),通过语义—声学双流量化机制,将语义建模与声学建模解耦为两个专门的分支,使其能够分别针对各自目标进行优化。大量实验结果表明,SAC 在不同码率、干净与噪声条件下均实现了优异的重建性能,并在 UTMOS 和 WER 指标上取得了较高分数,体现出良好的自然度与可懂度。此外,SAC 在语义表征能力上显著优于现有编码方法,其性能已接近连续自监督表征。在将 SAC 作为 LLM 驱动的文本到语音(TTS)系统的 tokenizer 时,我们进一步构建了一个单阶段自回归(AR)TTS 模型,其性能明显优于当前最先进的 AR 方法。最后,通过解耦机制的深入分析,我们验证了双流设计的有效性,并展示了其在可控语音生成方面的潜在价值。
03、FineLAP: Taming Heterogeneous Supervision for Fine-grained Language-Audio Pretraining
论文作者:李希泉, 徐薛楠, 马子阳, 陈文熙, 何昊林, 孔秋强, 陈谐
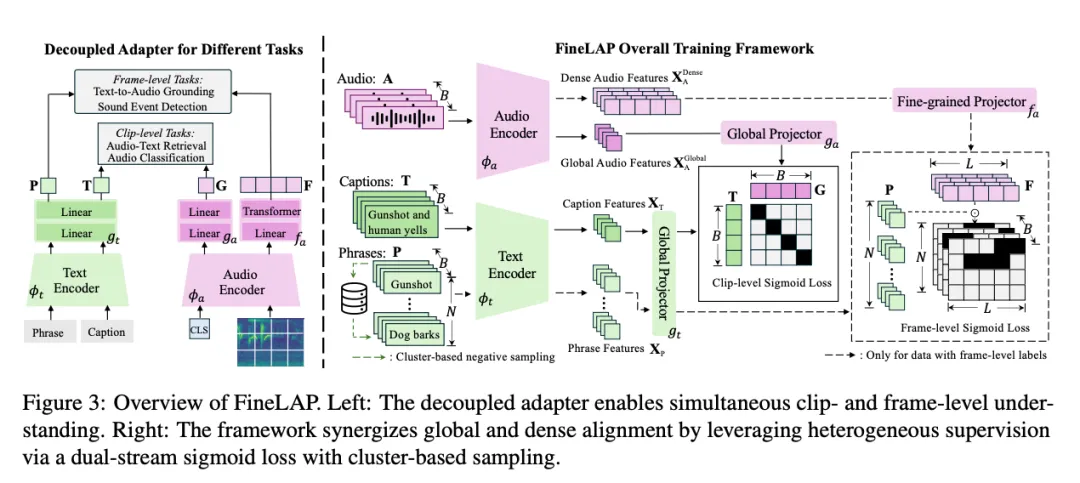
论文简介:对比学习预训练的音频-语言模型(例如 CLAP)在片段级(clip-level)理解任务中表现出色,但在帧级(frame-level)任务上仍存在明显不足。现有方法未能充分利用真实世界音频-文本数据中固有的多粒度特性,即大规模片段级文本描述与相对稀缺的帧级标注同时存在。为此,本文提出细粒度语言-音频预训练(Fine-grained Language-Audio Pretraining, FineLAP),一种在异构数据上同时提升片段级与帧级对齐能力的训练范式。具体而言,FineLAP 通过引入双流 sigmoid 损失函数并结合基于聚类的采样策略,实现对片段级与帧级监督信号的联合学习;同时,在自监督编码器之上设计解耦的音频投影头,以兼顾全局语义与局部细节建模。针对时间标注数据稀缺的问题,本文进一步构建了 FineLAP-100k,一个通过可扩展流程生成的大规模合成声音事件检测(SED)数据集。大量实验表明,FineLAP 在检索、分类、声音事件检测以及文本到音频定位等多种音频理解任务上均取得当前最优(SOTA)性能,消融实验进一步验证了粗粒度与细粒度对齐之间的互补性,为构建更强的音频-语言模型(ALMs)提供了有价值的启示。
04、MeanAudio: Fast and Faithful Text-to-Audio Generation with Mean Flows
论文作者:李希泉*, 刘峻希*, 梁宇哲, 牛志康, 陈文熙, 陈谐
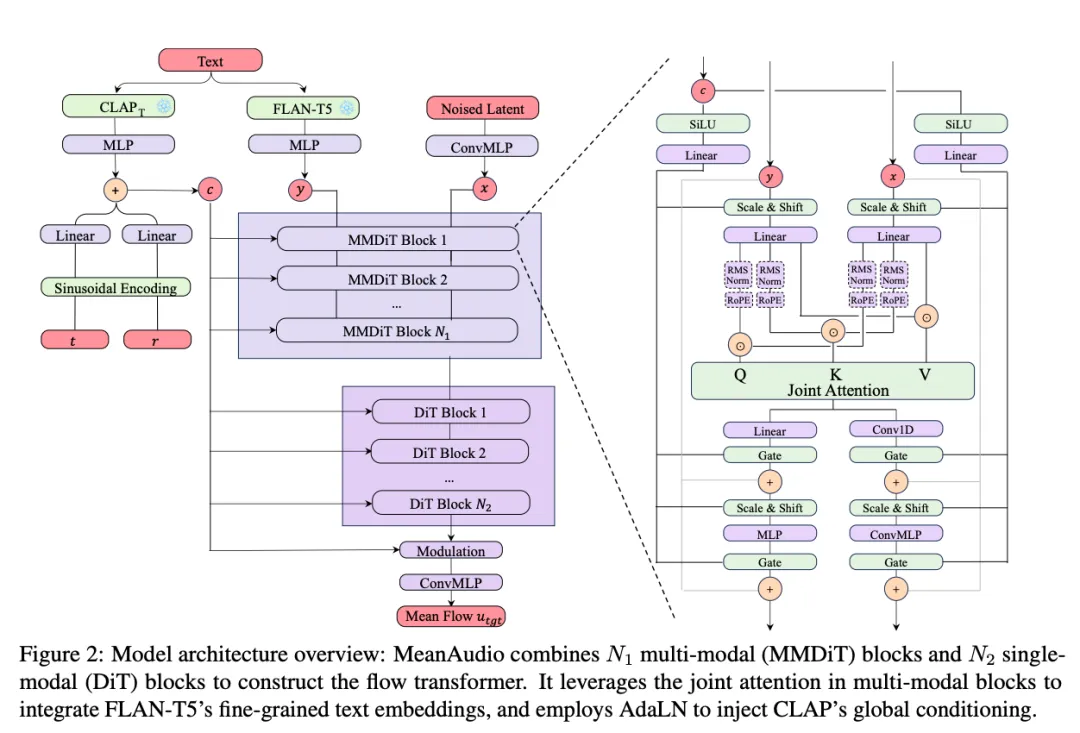
论文简介:近年来,文本到音频生成(Text-to-Audio Generation, TTA)领域取得了显著进展,为声音创作者提供了将灵感转化为生动音频的强大工具。然而,尽管已有这些进步,当前的 TTA 系统在推理速度方面仍然普遍较慢,这在很大程度上限制了音频创作的效率与流畅性。为此,本文提出 MeanAudio,一种快速且高保真的文本到音频生成模型,能够仅通过一次函数评估(1-NFE)生成逼真的声音。MeanAudio 主要基于以下三点设计:(i)引入带有引导速度目标的 MeanFlow 训练目标,大幅提升推理速度;(ii)采用改进的 Flux 风格 Transformer,并结合双文本编码器,以增强语义对齐能力和生成质量;(iii)设计高效的从瞬时分布到均值分布的课程学习策略,加速模型收敛,并支持在消费级 GPU 上进行训练。通过全面的实验评估,我们表明 MeanAudio 在单步音频生成任务中达到了当前最优(SOTA)性能。具体而言,在单张 NVIDIA RTX 3090 上,其实时因子(RTF)达到 0.013,相比基于扩散模型的 SOTA TTA 系统实现了约 100 倍的加速。此外,MeanAudio 在多步生成任务中同样表现出色,能够在连续生成过程中实现平滑的过渡。
05、Semi-Supervised Diseased Detection from Speech Dialogues with Multi-Level Data Modeling
论文作者:李星源,吴梦玥
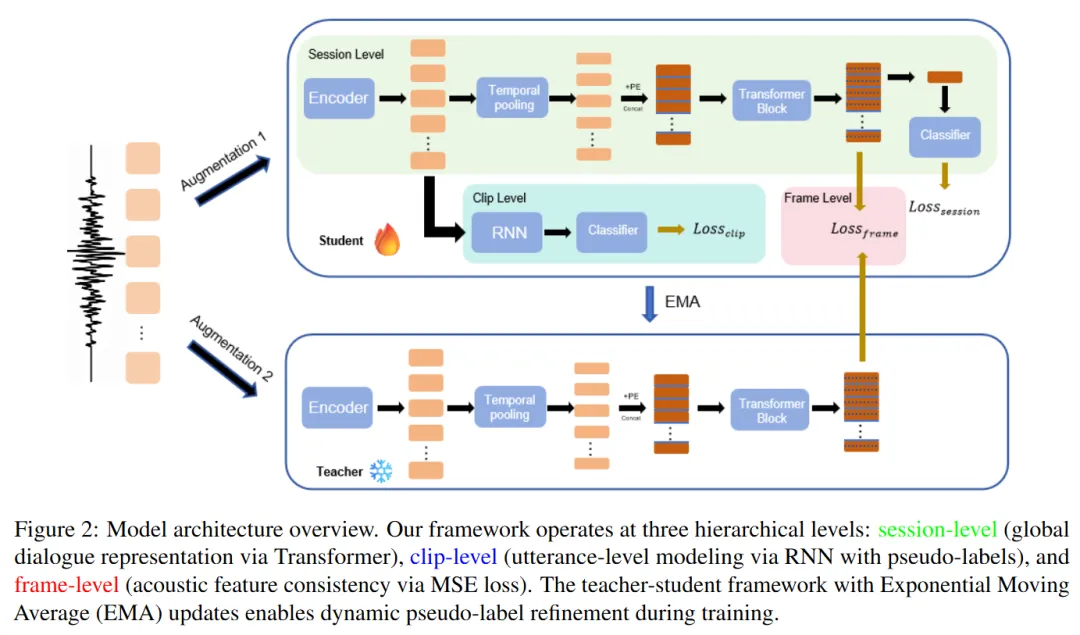
论文简介:从语音声学中检测医学病症本质上是一个弱监督学习问题:必须将单一且往往带有噪声的会话级标签,与长时复杂音频记录中的细微模式关联起来。严重的数据稀缺性以及临床标注的主观性进一步阻碍了该任务的开展。尽管半监督学习(SSL)为利用无标注数据提供了可行途径,但现有的语音处理方法往往未能解决核心挑战——病理特征在患者的语音中并非均匀表达。我们提出了一种新颖的纯语音半监督学习框架,通过从未分割的临床对话中联合学习帧级、片段级和会话级表示,显式地对这种层级结构进行建模。我们的端到端方法动态聚合这些多粒度特征,并生成高质量伪标签,从而高效利用无标注数据。大量实验表明,该框架具有模型无关性,在不同语言和病症下均表现出鲁棒性,且数据效率极高——例如,仅使用11个标注样本即可达到全监督学习90%的性能。这项工作为医学语音分析中从弱监督、远端监督信号中学习提供了一种有理论依据的方法。
