
 语音小管家
生理反应:咳嗽(Cough)、叹气(Sigh)、呼吸声(Breathing);
情绪爆发:大笑(Laughter)、惊讶(Surprise-ah);
交互填充:犹豫时的“呃…”(Uhm)、疑问时的“嗯?”(Question-en)。
现有的 TTS 模型虽然开始尝试加入这些声音,但评估体系却严重滞后,面临三大痛点:
缺乏标准定义:很多模型把 NVs 当作普通的“音效”处理,忽略了其作为交际行为的功能性(比如“呃”表示犹豫,“嗯”表示确认)。
评估指标失效:传统的词错率(WER)无法衡量非语言声音;现有的测试集往往缺乏真实的配对参考音频(Ground Truth),导致评估只能靠“听个响”,无法量化生成声音与真人的差距。
数据分布不均:真实场景中 NVs 是长尾分布的(比如“大笑”常见,“惊讶的吸气”罕见),现有测试集往往类别失衡,少数高频类别会主导总分,把模型在罕见类别上的短板掩盖掉。
核心矛盾:TTS 模型在进化,但“考卷”(评估基准)还停留在小学水平。如何建立一套能真正衡量 AI“人情味”的标准化考试?
论文:https://arxiv.org/pdf/2603.15352
解决方案
NV-Bench是首个基于功能分类学(Functional Taxonomy)的非语言发声合成基准。它不再把 NVs 看作声学瑕疵,而是视为交际行为。
核心思路一句话概括: 构建一个包含真实配对参考音频、类别平衡、双语(中英)的测试集,并提出“指令对齐”与“声学保真”双维度的评估协议。
我们把它拆解为三个关键步骤:
「核心工作一:构建功能化分类体系与多语言 NVASR」
要评估,先要能“听懂”。我们首先训练了一个强大的多语言非语言语音识别模型(NVASR)。
功能分类:借鉴 Batliner 等人的分类法,将 NVs 分为三大类 14 小类(见表 2),涵盖生理、情感和交互功能。
统一标签:整合了 Emilia-NV, NVTTS, SMIIP-NV 等多个数据集,将混乱的标签统一映射到标准分类体系中。
高精度识别:基于 SenseVoice-Small 微调,在 NV 识别任务时在相同测试集上大幅超越MNV-17开源的Qwen2.5-Omni微调版本,成为可靠的“自动阅卷老师”。
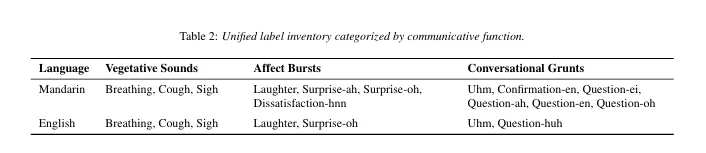
表 2:NV-Bench 统一标签体系
「核心工作二:严选“in-the-wild”数据,打造黄金测试集」
NV-Bench 的数据全部来自2025 年发布的网络视听媒体(确保无数据泄露),并经过地狱级过滤:
初筛:从 56 万条音频(1560 小时)中初步筛选。
去噪与单人验证:利用 Emilia-Pipeline 标准化,并使用MiMo-Audio-7B(音频大模型)进行二次校验,剔除任何包含多人说话的片段,确保单人纯净度。
人工复核:10 名专家对 ASR 生成的标签进行逐一校对,确保语用功能的准确性(Cohen's kappa > 0.85)。
最终构建了1,651条 高质量测试样本,分为:
单标签子集(Single-label):每类 50 条,严格平衡,用于测试基础能力。
多标签子集(Multi-label):包含 2 个以上 NV 事件,模拟真实复杂的对话场景。
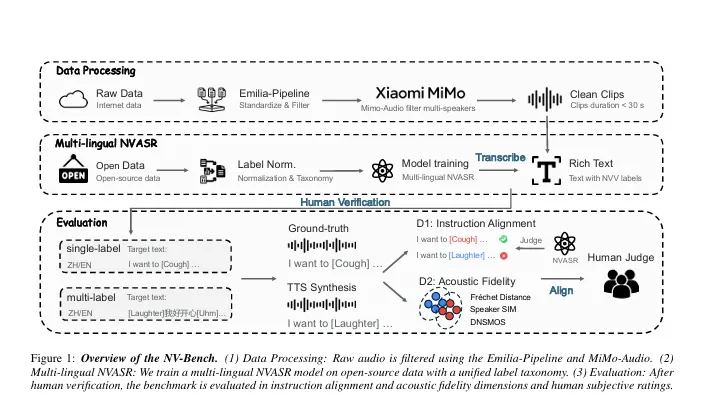
图 1:NV-Bench 构建流程概览
「核心工作三:双维度评估协议」
NV-Bench 提出了两个核心评估维度,彻底解耦“听得懂指令”和“像不像真人”:
指令对齐(Instruction Alignment):
衡量模型是否能在正确的位置生成正确的 NV 事件。
提出新指标 PCER (Paralinguistic Character Error Rate),专门计算非语言符号的编辑距离。
声学保真(Acoustic Fidelity):
衡量生成的声音与真实录音的分布差距。
使用 Fréchet Audio Distance (FAD)、FD 以及 说话人相似度 (SIM)。
效果验证:到底解决了什么?
我们在 NV-Bench 上对当前主流的 TTS 模型(包括 Orpheus-TTS, CosyVoice2/3, FlexiVoice 等)进行了全面“大考”。
1. NVASR:可靠的“自动阅卷机”
首先验证“阅卷老师”是否公正。
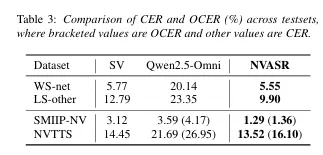
表 3:NVASR 性能对比
结果显示,自研的 NVASR 在保持高 ASR 准确率的同时,对 NV 标签的识别精度达到了 SOTA 水平(CER 低至 1.29%),足以胜任自动化评估任务。
2. 模型大比拼:谁更有人味儿?
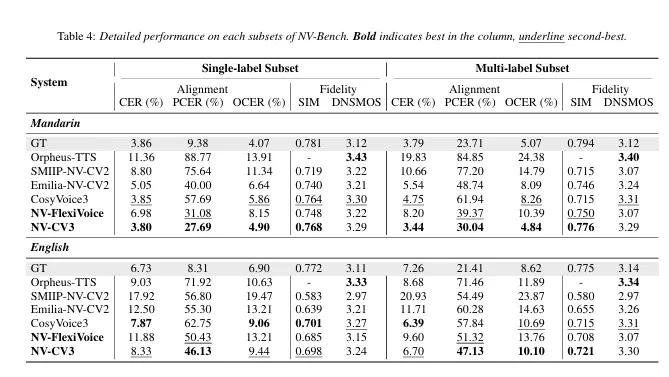
表 4:各模型在 NV-Bench 上的详细表现
指令对齐能力:NV-CV3(基于 CosyVoice3 微调)表现最佳,在中文单标签子集上 PCER 低至 27.69%,说明它能精准地在文本指定的位置插入“咳嗽”或“笑声”,不遗漏也不乱加。
声学保真度:NV-FlexiVoice在分布距离(FAD/FD)上表现最优,说明其生成的 NV 声音在统计分布上最接近真人。
综合冠军:NV-CV3在主观评测(NMOS/IMOS)中也获得了最高分,证明了客观指标与人类感知的高度一致性。
3. 客观指标与人类感知强相关
这是 NV-Bench 最重要的验证之一。
PCER 与 IMOS(指令准确度)呈显著负相关(ρ=−0.65ρ=−0.65):PCER 越低,人类觉得指令执行越准。
FD 与 NMOS(自然度)呈显著负相关:分布距离越近,人类觉得越自然。
这证明了 NV-Bench 提出的客观指标是可信的,未来研究者无需每次都耗费巨资做人工听测,跑分即可知高低。
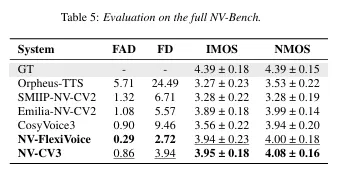
表 5:全榜单综合评估与主观相关性
「典型失败案例 vs 成功案例」
失败案例(基线模型):
指令错误:文本要求“[Cough] 你好”,模型却漏掉了咳嗽,或者在句尾强行加了一个笑声。
声学失真:生成的“笑声”像机器人尖叫,或者“咳嗽声”带有明显的电子伪影,与说话人音色割裂。
成功案例(NV-CV3 / NV-FlexiVoice):
精准执行:在“我[叹气]真的没办法”中,叹气声出现在“我”之后,时长自然,情感到位。
音色融合:咳嗽声、笑声的音色与说话人完全一致,仿佛是真人自然发出的,毫无拼接感。
总 结
NV-Bench 解决的是 expressive TTS 领域“有模型、无标准”的尴尬局面:
过去:评估靠感觉,数据不平衡,指标无法反映真实的交际功能。
现在:有了NV-Bench,我们有了第一把“标尺”。它不仅是一个测试集,更是一套标准化的评估范式。
核心贡献总结:
首个功能化基准:将 NVs 视为交际行为,涵盖 14 类中英双语标签。
高质量配对数据:1,651 条“in-the-wild”真实录音,经过大模型 + 人类双重清洗。
双维度评估协议:提出 PCER 等新指标,解耦了指令控制力与声学自然度。
验证与洞察:通过大规模评测,揭示了当前 SOTA 模型的短板,并证明了客观指标的有效性。
未来展望:随着 NV-Bench 的推广,未来的 TTS 模型将不再只是“念稿机器”,而是能像真人一样呼吸、大笑、犹豫、感叹的智能交互体。这将极大提升虚拟人、情感陪伴助手、有声书朗读等应用的用户体验。
想象一下,未来的 AI 客服在你抱怨时能发出一声真诚的“唉”,或者在讲笑话时配上自然的“哈哈”,这种情感共鸣才是语音技术的终极浪漫。
