
 语音小管家
以下文章来源于Amphion
在隐私通话、声带受损恢复等场景中,耳语转正常语音(Whisper-to-Normal, W2N) 技术至关重要。但这一领域长期被一个“死结”困住:数据极度匮乏。
耳语缺乏声带振动和基频,声学线索严重退化,导致转换难度极大。现有的解决方案普遍陷入以下困境:
平行数据稀缺:收集成对的“耳语 - 正常语音”数据成本极高,现有数据集规模小、语种单一,严重限制了模型上限。
伪数据质量差:传统方法利用数字信号处理(DSP)生成的“伪耳语”存在明显的分布差异(Distribution Gap),不仅无法提升性能,反而引入噪声。
生成质量瓶颈:现有模型在说话人音色保持、韵律自然度和可懂度上难以兼顾,往往顾此失彼。
训练不稳定:基于对抗生成网络(GAN)的方法虽然尝试解决数据问题,但常面临训练崩溃、模式坍塌的风险。
核心矛盾:想要高质量的 W2N 模型,需要海量平行数据;但获取真实平行数据几乎不可能。如何打破这个死循环?
Amphion团队和荣耀共同提出一个思路:既然正向(耳语→正常)数据难找,那能不能利用反向(正常→耳语)来“无中生有”?Demo:https://whispear-demo.github.io/
「解决方案」
我们提出了WhispEar,一个基于统一语义表示的双向耳语转换框架。其核心洞察非常反直觉却极具威力:
耳语和正常语音虽然声学特征不同,但它们共享相同的高层语义信息。
基于此,WhispEar 不再将 W2N 视为单向任务,而是构建了一个双向闭环:既能将耳语恢复为正常语音(W2N),也能将正常语音转换为耳语(N2W)。
核心思路一句话概括:利用相对容易的“正常转耳语(N2W)”能力,从海量无标注的正常语音数据中合成高质量的“伪耳语”,从而构造出大规模的伪平行数据,反向滋养困难的“耳语转正常(W2N)”任务。
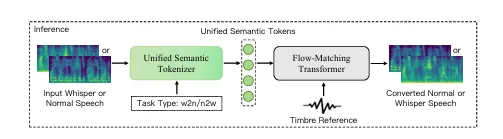
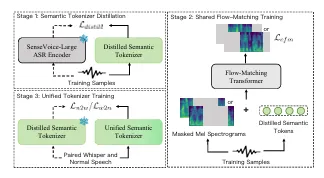
我们把它拆解为一个三阶段训练框架:
「核心工作一:统一语义 Tokenizer —— 抹去说话模式的差异」
要让双向转换成为可能,首先需要一个能够忽略“说话模式”(耳语 vs 正常),只捕捉“语义内容”的表示空间。
语义蒸馏(Semantic Distillation): 从大型 ASR 编码器(Teacher)中蒸馏出一个轻量级的学生模型(Student)。该模型在混合了耳语和正常语音的数据上训练,强迫其学习说话模式不变(speaking-mode-invariant)的语义特征。
离散化表示: 利用有限标量量化(FSQ)将连续语义特征转化为离散 Token。这一步不仅压缩了信息,还进一步过滤了与语义无关的声学噪声(如耳语的气流声、正常语音的基频细节)。
「核心工作二:共享 Flow-Matching 声学模型 —— 一套架构,双向生成」
有了统一的语义 Token,生成模型就可以“只认语义,不认模式”。
共享架构:W2N 和 N2W 任务共享同一个 Flow-Matching Transformer 和同一个声码器(Vocoder)。
条件控制:仅通过一个方向指示符(d∈{w2n,n2w}d∈{w2n,n2w})来切换生成模式。
解耦训练:声学模型在蒸馏后的语义 Token 上训练,与后续的语义对齐过程解耦,保证了训练的稳定性。
「核心工作三:双向数据 Scaling 策略 —— 用 N2W 反哺 W2N」
这是 WhispEar 最重要的“数据飞轮”设计:
先易后难:首先利用少量真实平行数据训练N2W(正常转耳语)模型。实验发现,N2W 任务比 W2N 更容易收敛,且质量更高。
伪数据生成:利用训练好的 N2W 模型,将互联网上海量的正常语音数据(如 Emilia 数据集)转换为高保真伪耳语。这样,我们就得到了大规模的 (正常语音,伪耳语)(正常语音,伪耳语) 平行对。
反向增强:将这些生成的伪平行数据与少量真实数据混合,用于训练W2N(耳语转正常)模型。
「效果验证:到底解决了什么?」
为了验证 WhispEar 的有效性,我们不仅做了详尽的实验,还发布了目前规模最大的中英双语耳语平行语料库——wEar。
1. 数据集规模刷新纪录
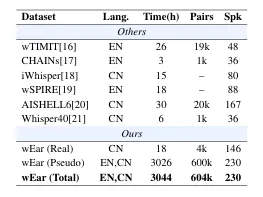
【表 1:耳语数据集对比】
wEar (Real):146 位说话人,18 小时真实录音(中英双语)。
wEar (Pseudo):利用 WhispEar 生成的 3000+ 小时伪平行数据。
总计:超过 3000 小时,60 万对平行数据,是此前最大数据集的百倍以上。
2. 性能全面 SOTA
在英文(wTIMIT)和中文(wEar)测试集上,WhispEar 在可懂度、音质、韵律、说话人相似度四个维度上全面超越现有最强基线(如 WESPER, DistillW2N, CosyVoice2)。
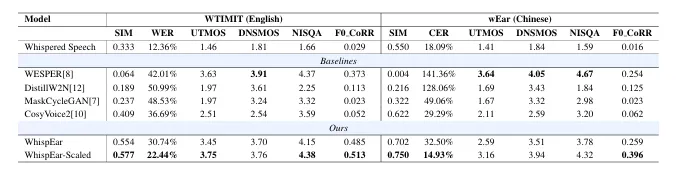
【表 2:主实验结果对比】
可懂度飞跃:在中文测试集上,词错率(CER)从基线的 29% 降至 14.93%,提升近一倍。
音色保持:说话人相似度(SIM)显著提升,证明模型没有“换脸”。
跨语言泛化:在中文数据上训练的模型,在英文任务上依然表现强劲,证明了统一语义表示的泛化能力。
3. 伪数据真的有用吗?
消融实验直接回答了这个问题。
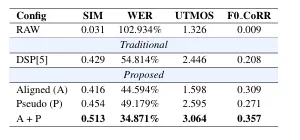
【表 3:不同数据策略消融实验】
DSP 伪数据:传统方法生成的伪数据提升有限,甚至引入噪声。
WhispEar 伪数据:仅使用模型生成的伪数据(P),效果就超过了传统 DSP 方法。
真实 + 伪数据(A+P):组合效果最佳。证明高质量的对齐与大规模伪数据缺一不可。
4. 数据 Scaling 效应显著
随着伪平行数据规模的增加,模型性能是否持续增长?
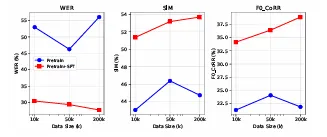
【图 3:Scaling 实验曲线】
预训练 + 微调(Pretrain + SFT) 是最佳范式。
随着伪数据规模扩大,经过少量真实数据微调后,模型在 WER、SIM、F0 CoRR 等指标上一致提升,未出现饱和迹象。
这验证了Data-Centric AI在语音转换领域的巨大潜力:更大的数据规模 = 更强的模型智能。
「典型失败案例 vs 成功案例」
基线模型失败案例:在输入干净耳语时,基线模型往往生成带有“机械音”或“韵律平淡”的语音,且在说话人音色上发生漂移。
WhispEar 成功案例:生成的语音不仅清晰可懂,还完美还原了原说话人的音色特征,韵律自然流畅,甚至能捕捉到细微的情感变化。
「总 结」
WhispEar 解决的是语音转换领域长期的“数据饥渴”痛点:
过去:苦于没有平行数据,模型性能触顶,甚至依赖低质量的 DSP 伪数据。
现在:用双向框架打通数据闭环,用N2W 生成能力换取海量伪数据,实现W2N 性能的无限 Scaling。
它最大的意义不只是刷榜,而是提供了一套可复制的方法论: 对于其他低资源语音任务(如方言转换、病理语音修复),是否也能通过构建“双向任务”,利用易获取的数据生成难获取的数据,从而打破数据瓶颈?
