
 语音小管家
本期分享中国科学技术大学语音及语言信息处理国家工程研究中心研究团队近期发表在IEEE Transactions on Audio, Speech and Language Processing期刊上的2篇关于超低码率语音编解码器的研究。
01、Ultra-Low-Bitrate Mel-Spectrogram-based Neural Speech Coding with Flow-Matching-based Refinement and Vocoding-driven Reconstruction
【论文标题】Ultra-Low-Bitrate Mel-Spectrogram-based Neural Speech Coding with Flow-Matching-based Refinement and Vocoding-driven Reconstruction
【论文作者】杜荟鹏, 艾杨, 江晓航, 田园, 凌震华
【论文单位】中国科学技术大学语音及语言信息处理国家工程研究中心
【作者邮箱】redmist@mail.ustc.edu.cn; yangai@ustc.edu.cn; jiang_xiaohang@mail.ustc.edu.cn; ytian1507@mail.ustc.edu.cn; zhling@ustc.edu.cn
【论文亮点】
在带宽受限通信和深度压缩等应用场景中,语音编码器需要将语音压缩为极低码率的离散表示,并在解码端重建自然、可懂且能够保持说话人特征的语音。然而,当码率降低到几百 bps 量级时,传统波形域神经编码器往往面临严重的信息丢失、量化不稳定以及计算复杂度过高等问题。针对这一挑战,本文提出了一种基于梅尔谱的超低码率神经语音编码器 FMelCodec,将语音编码建模为编码、细化与重建(Coding-Refinement-Reconstruction,CRR)三阶段流程。该方法首先在梅尔谱域中采用单码本向量量化实现极强压缩,并通过在线聚类策略缓解码本坍塌;随后利用条件流匹配(Conditional Flow Matching,CFM)对粗糙解码梅尔谱进行细节恢复;最后借助神经声码器将细化后的梅尔谱重建为语音波形。实验结果表明,FMelCodec 能够在 16 kHz 语音的 250 bps 和 48 kHz 语音的 750 bps 设置下取得稳定且高质量的重建效果,并在语音自然度、说话人相似度以及模型复杂度之间取得了较优平衡。
【引言】
语音编码器的目标是将语音信号转换为紧凑的表示,并在解码端恢复出清晰、自然且可理解的语音。码率是评价语音编码器压缩能力的核心指标之一,也直接决定了其在真实通信系统中的可用性。在卫星通信、低资源设备通信、边缘部署以及大规模语音传输等场景下,可用带宽可能非常有限,因此在极低码率下保持高质量语音重建具有重要的研究价值和实际意义。
早期标准化语音编码器主要依赖人工设计的数字信号处理流程,例如 Opus 和 EVS 等系统通常在数 kbps 到十几 kbps 的码率范围内工作。当码率进一步降低时,语音的音色、韵律和说话人相关信息会明显受损。近年来,基于深度学习的神经语音编码器通过端到端建模、可学习量化和神经解码显著提升了低码率语音重建质量,逐渐成为语音编码领域的重要方向。
现有神经语音编码器大多直接在波形域进行编码和解码,例如 SoundStream、Encodec、DAC 等方法通常采用多层下采样/上采样网络和残差向量量化(RVQ)来获得离散码流。这类方法虽然能够在较低码率下取得较好性能,但通常需要多个量化码本来维持表示能力,模型和计算复杂度也相对较高。对于资源受限和低延迟部署场景而言,如何进一步降低码率并保持可接受复杂度仍然是一个关键问题。
为降低计算负担,一些研究开始将编码目标从原始波形转向频谱域表示。例如,APCodec 在 STFT 幅度和相位谱上进行编码,MDCTCodec 在 MDCT 频谱上建模,Spectral Codec 则尝试压缩梅尔谱并使用神经声码器重建波形。频谱域特征天然具有时间下采样效果,因此更适合实现高效压缩。然而,已有频谱域编码器通常仍依赖多个量化单元,工作码率多处于 kbps 量级,尚未充分解决几百 bps 超低码率下的高质量重建问题。
基于上述观察,本文提出 FMelCodec。它充分利用梅尔谱的感知相关性、低时间分辨率以及与神经声码器的天然兼容性,将极低码率压缩、生成式细节恢复和波形重建解耦为三个相互协作的阶段。与依赖大规模自监督语音表征或超大模型容量的方案不同,FMelCodec 是一种纯声学层面的编码框架,目标是在极低码率、较低复杂度和高感知质量之间取得更实用的折中。
【研究背景】
本文提出的 FMelCodec 主要涉及三个研究方向:频谱域神经语音编码、基于扩散或流匹配的语音生成式建模,以及神经声码器驱动的波形重建。
频谱域神经语音编码
频谱域语音编码将建模对象从原始波形转向时频表示,能够利用频谱分析本身带来的时间下采样,减少神经网络额外下采样和上采样的压力。典型方法包括基于 STFT 幅度与相位谱的 APCodec、基于 MDCT 频谱的 MDCTCodec,以及面向梅尔谱 token 的 Spectral Codec 等。这类方法在降低计算复杂度方面具有明显优势,但在极低码率设置下,仍需要解决量化能力不足、细节缺失和高频结构恢复困难等问题。
扩散模型与条件流匹配
扩散模型和条件流匹配模型能够通过生成式建模恢复压缩或失真过程中丢失的细节。扩散模型通常通过多步去噪逐步生成目标样本,效果较强但推理步骤较多;条件流匹配则学习一个时间相关的速度场,通过求解常微分方程将简单先验分布映射到目标数据分布。近年来,CFM 已被用于语音合成、语音增强和语音编码后处理等任务。本文将 CFM 引入梅尔谱细化阶段,用于从粗糙解码梅尔谱中恢复更接近自然语音的细粒度结构,并进一步通过自一致性训练降低推理迭代次数。
神经声码器
神经声码器能够将梅尔谱等声学特征转换为高保真语音波形,并且在文本转语音等任务中已被证明对预测梅尔谱具有较强鲁棒性。这一性质启发本文将声学表示建模与波形重建解耦:编码器和细化模块专注于在梅尔谱域中压缩并恢复语音结构,而预训练或单独训练的 HiFi-GAN 声码器负责最终的波形合成。
【研究方法】
概述
FMelCodec 的总体框架如图 1 所示。该方法采用三阶段 CRR 框架,包括梅尔谱编码阶段、基于 CFM 的梅尔谱细化阶段以及声码器驱动的波形重建阶段。给定输入语音,系统首先提取梅尔谱,并将其压缩为单码本离散 token;随后解码得到粗糙梅尔谱,再通过 CFM 细化模块恢复频谱细节;最后,神经声码器根据细化后的梅尔谱重建最终语音波形。三个阶段分别训练,并在推理时顺序连接。
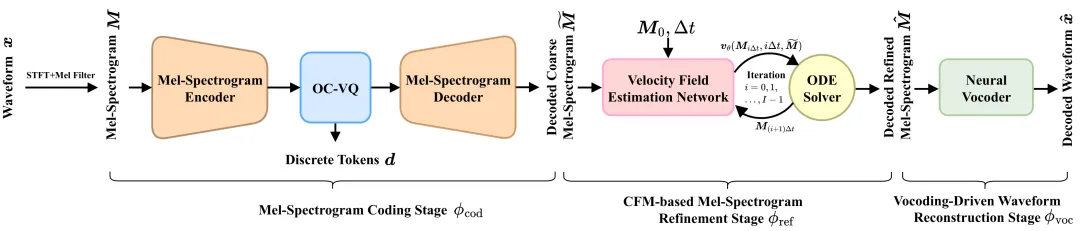
图1: FMelCodec 在 CRR 框架下的整体推理流程图
梅尔谱编码阶段
梅尔谱编码阶段负责将输入语音的梅尔谱压缩为紧凑的离散 token,并输出一个粗糙解码梅尔谱,作为后续细化模块的条件输入。具体而言,输入波形首先经过 STFT 和 Mel 滤波器得到梅尔谱;随后,梅尔谱编码器基于 ConvNeXt v2 结构进行时序建模和下采样,将梅尔谱映射为低帧率潜在表示;该潜在表示经过在线聚类向量量化(OC-VQ)得到离散码流;最后,梅尔谱解码器将量化后的表示恢复为粗糙梅尔谱。
单码本向量量化与在线聚类
为了达到超低码率,FMelCodec 采用单个 1024 项 VQ 码本进行离散化,并结合较大的时间压缩率,使系统在 16 kHz 条件下可达到 250 bps,在 48 kHz 条件下可达到 750 bps。单码本量化虽然能够显著降低码率,但容易出现码本坍塌,即只有少量码字被频繁使用,导致有效表示能力下降。为此,本文引入在线聚类策略,在训练过程中监测码字使用情况,并动态重定位使用不足的码字,使其更好地覆盖当前特征分布。该设计在不增加推理复杂度的前提下,提高了码本利用率和低码率量化稳定性。
基于 CFM 的梅尔谱细化阶段
在极低码率压缩后,粗糙解码梅尔谱通常会丢失细粒度频谱结构,直接送入声码器会导致自然度下降或谐波细节受损。为解决这一问题,FMelCodec 使用条件流匹配模型对粗糙梅尔谱进行生成式细化。该模块以粗糙梅尔谱为条件,学习从简单先验分布到自然梅尔谱分布的速度场,并通过 ODE 求解器逐步得到细化后的梅尔谱。与直接在波形或 STFT 频谱上修复相比,在梅尔谱域进行细化可以降低建模难度,并与后续神经声码器自然衔接。
自一致性训练策略
CFM 类模型通常需要一定数量的 ODE 迭代步骤才能获得高质量结果。为了降低推理开销,本文在细化阶段引入自一致性损失,使模型在较少迭代步数下仍能保持稳定的生成轨迹。实验表明,带有自一致性训练的 FMelCodec 在 4 次迭代时即可达到接近去除该损失并使用 8 次迭代的效果,从而显著改善了质量与计算成本之间的折中。
声码器驱动的波形重建
最后,细化后的梅尔谱被输入 HiFi-GAN 声码器以生成时域语音波形。由于 HiFi-GAN 已在大量梅尔谱到波形映射任务中表现出较强重建能力,FMelCodec 可以将复杂的波形细节恢复任务交由声码器完成,而前两阶段则集中解决低码率压缩和梅尔谱细节恢复问题。这种解耦式设计降低了整体训练难度,也提升了框架的模块化程度。
训练策略
FMelCodec 采用分阶段训练策略。首先训练梅尔谱编码阶段,通过梅尔谱重建损失和 VQ 正则项优化编码器、OC-VQ 和解码器,使其在单码本条件下尽可能保留梅尔谱结构。随后,在固定或使用已训练编码阶段的基础上构造粗糙梅尔谱与自然梅尔谱配对数据,训练 CFM 细化模块及其自一致性目标。最后,HiFi-GAN 声码器使用与系统一致的梅尔谱配置进行训练,并在推理阶段将细化梅尔谱转换为波形。分阶段训练能够避免编码器和细化器同时变化造成的目标不稳定问题,使每个模块学习目标更加清晰。
实验结果
实验在 LibriTTS 16 kHz 和 VCTK 48 kHz 两个数据集上进行,分别测试 250 bps 和 750 bps 的超低码率语音编码性能。FMelCodec 与 DAC、MDCTCodec、BigCodec、WavTokenizer、FlowDec、FocalCodec 等代表性神经语音编码器进行了比较,评价指标涵盖 ViSQOL、UTMOS、说话人相似度 SIM、dWER、MCD、自然度 MOS(NMOS)、说话人相似度 MOS(SMOS)、实时率 RTF、GFLOPs 和参数量。
在 LibriTTS 16 kHz、250 bps 设置下,FMelCodec 取得了 3.56 的 ViSQOL、3.48 的 UTMOS、0.92 的 SIM、3.72 的 NMOS 和 3.51 的 SMOS,整体质量和说话人保持能力优于大多数同码率基线。虽然 FocalCodec 依赖自监督语音表征,在 dWER 上表现更好,但它需要更高的模型复杂度;主观 ABX 结果显示,FMelCodec 与 FocalCodec 的感知自然度差异并不显著,说明 FMelCodec 在纯声学框架下仍能取得很有竞争力的听感质量。
在 VCTK 48 kHz、750 bps 设置下,FMelCodec 也表现稳定,取得了最佳 ViSQOL、SIM、dWER、MCD 和 SMOS,并在 UTMOS 与 NMOS 上接近最优结果。这表明该方法不仅适用于 16 kHz 宽带语音,也能够扩展到 48 kHz 高采样率语音编码任务。
表1: FMelCodec 与基线方法在 LibriTTS 和 VCTK 测试集上的客观与主观结果
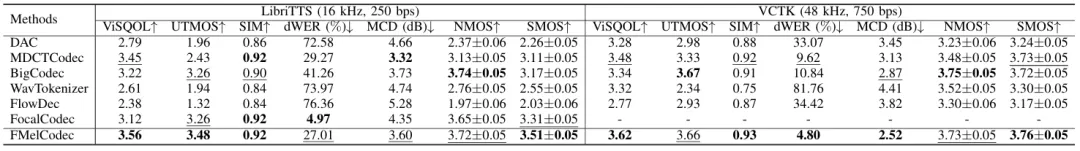
从效率和复杂度来看,FMelCodec 的整体 RTF 为 0.022,对应约 44.82 倍实时速度,参数量为 27.17M。相比之下,BigCodec 和 FocalCodec 分别具有约 158.31M 和 143.30M 参数,FlowDec 的计算量也显著更高。虽然 MDCTCodec 在模型规模和计算量上更轻量,但其主客观语音质量明显弱于 FMelCodec。综合来看,FMelCodec 在极低码率语音质量、说话人保持、推理速度和模型规模之间实现了较好的平衡。
进一步的高码率基线比较和消融实验验证了各模块的有效性。ABX 结果表明,FMelCodec 在 250 bps 下可与部分 500 bps 甚至 1000 bps 基线达到相当或更优的主观偏好,体现出明显的码率节省效果。移除在线聚类会导致严重码本坍塌,仅有 359 个码字被有效使用;移除 CFM 细化阶段会带来最大的听感偏好差距;去除分阶段训练或自一致性损失也会降低系统性能。这些结果说明,单码本 OC-VQ、CFM 细化、自一致性训练和声码器重建共同构成了 FMelCodec 在超低码率下保持高质量的关键。
【结论】
本文提出了一种基于梅尔谱的超低码率神经语音编码器 FMelCodec。该方法在 CRR 框架下将语音编码过程拆分为梅尔谱编码、梅尔谱细化和声码器重建三个阶段:首先利用 ConvNeXt v2 编码器-解码器和单码本 OC-VQ 在梅尔谱域实现强压缩;随后采用 CFM 细化模块恢复粗糙解码梅尔谱中的细粒度结构,并通过自一致性训练减少 ODE 推理迭代次数;最后使用 HiFi-GAN 声码器生成高质量语音波形。大量实验表明,FMelCodec 能够在 250 bps 和 750 bps 的极低码率条件下保持较高语音自然度和说话人相似度,并相较多种强基线展现出更有竞争力的码率-质量-复杂度折中。总体而言,本文证明了在梅尔谱域中结合单码本低码率离散化、生成式频谱细化和神经声码器重建,是实现实用超低码率神经语音编码的一条有效路径。未来工作可进一步探索更低延迟的流式建模、更轻量的声码器以及更复杂真实通信场景下的鲁棒性。
【论文链接】https://arxiv.org/abs/2605.25669
02、CFMDCTCodec: A Low-Bitrate Neural Speech Codec with Noise-Prior-aware Conditional Flow Matching for MDCT-Spectral Enhancement
【论文标题】CFMDCTCodec: A Low-Bitrate Neural Speech Codec with Noise-Prior-aware Conditional Flow Matching for MDCT-Spectral Enhancement
【论文作者】江晓航, 艾杨, 杜荟鹏, 凌震华, 吴及
【论文单位】中国科学技术大学语音及语言信息处理国家工程研究中心;清华大学电子工程系
【作者邮箱】jiang_xiaohang@mail.ustc.edu.cn; yangai@ustc.edu.cn; redmist@mail.ustc.edu.cn; zhling@ustc.edu.cn; wuji_ee@tsinghua.edu.cn
【论文亮点】
高质量低码率语音编码是带宽受限通信中的关键技术,但在极低码率条件下,有限的离散码流往往只能保留语音的粗略结构,难以恢复自然度、清晰度和说话人特征等细节。现有神经语音编解码器大多依赖多级残差向量量化、较大规模的编码器/解码器,或复杂的后处理模块;当码率进一步压低时,音质下降、计算开销上升和部署复杂度之间的矛盾更加突出。
针对这一问题,本文提出 CFMDCTCodec。该方法完全工作在改进离散余弦变换(Modified Discrete Cosine Transform, MDCT)频谱域,将一个轻量级单码本 MDCT 频谱编解码器与一个噪声先验感知的条件流匹配(Conditional Flow Matching, CFM)频谱增强器进行联合建模。前端编解码器负责将 MDCT 频谱压缩为极低码率离散表示并生成粗重建频谱,后端增强器则在归一化 MDCT 频谱上学习从噪声先验到高质量频谱的确定性速度场,并通过 ODE 求解器逐步恢复更丰富的频谱细节。
实验结果表明,在 0.65 kbps 的极低码率场景下,CFMDCTCodec 显著提升了轻量级 MDCTCodec 的主观听感质量,并在接近大模型 BigCodec 感知质量的同时,仅使用其约 13% 的参数量和不足四分之一的计算量。该结果说明,在低码率语音编码中,与其单纯扩大模型规模或增加量化层数,不如在高效频谱域内引入面向解码端的生成式频谱增强机制,从而在音质、码率和复杂度之间取得更平衡的折中。
【引言】
语音编解码器的核心目标,是将语音波形映射为紧凑的比特流,并在接收端尽可能自然、清晰地重建语音。传统通信与流媒体系统通常工作在数 kbps 甚至更高码率范围,这一设置能够满足多数日常语音通信需求。然而,在卫星链路、高频无线电、远程监测以及大规模云端语音传输等场景中,系统常常面临极其严格的带宽与能耗限制,语音编码必须在更低码率下保持可接受的感知质量。
近年来,神经语音编解码技术快速发展。以 SoundStream、EnCodec、DAC 等为代表的波形域神经 codec 通常采用残差向量量化(Residual Vector Quantization, RVQ)逐级细化离散表示,在中高码率下能够取得较好重建质量。但在极低码率条件下,减少量化层数或降低 token 速率会直接削弱离散表示能力,使解码器难以恢复语音中的细粒度频谱结构。另一类代表性方法是扩大模型容量,例如低码率场景下的大规模编码器/解码器模型能够改善感知质量,但也带来较高参数量、计算量和部署成本。
与直接处理波形相比,频谱域建模能够利用语音在时频表示中的结构性,有助于降低计算复杂度。团队前期提出的 MDCTCodec 证明,直接在实值 MDCT 频谱上进行神经编码可以构建更轻量的语音编解码器。然而,MDCTCodec 仍然依赖 RVQ 细化表示,在低码率场景下面临离散容量瓶颈。如何在保持频谱域高效性的同时进一步增强低码率解码能力,成为本文关注的核心问题。
扩散模型和流匹配模型为语音 codec 的生成式后处理提供了新的思路。相比传统回归式解码,生成式后处理能够从严重压缩的粗重建结果中补充缺失的细节。已有方法如 FlowDec 将 CFM 后处理器用于 STFT 频谱增强,但主要面向较高码率、波形域 codec 和两阶段训练流程。本文进一步提出:如果整个 codec 与增强器都在 MDCT 域内建模,并通过端到端联合训练使二者协同适配,就有可能在极低码率下获得更高效、更稳定的重建质量。
【研究背景】
低码率神经语音编解码
神经语音 codec 通常由编码器、量化器和解码器组成。编码器将输入语音压缩为低帧率潜在表示,量化器将连续潜在向量映射为离散 token,解码器再根据 token 重建语音。RVQ 通过多个码本逐级量化残差,能够在较高码率下持续补充声学细节,但在码率极低时,减少码本数或降低帧率会明显压缩可传输信息。单码本量化虽然结构简洁、token 序列更紧凑,但解码端需要具备更强的细节恢复能力。
MDCT 频谱域建模
MDCT 是音频编码领域常用的实值时频变换,具有较好的能量聚集特性和重叠重建性质。相比 STFT 的复值表示,MDCT 只需处理实值系数,避免同时建模实部和虚部,因而更适合构建轻量化频谱 codec。本文延续 MDCTCodec 的频谱域设计思想,但将低码率表示从多级 RVQ 推向更激进的单码本量化,并通过后端生成式增强弥补粗重建频谱中的细节缺失。
条件流匹配与生成式频谱增强
条件流匹配是一类生成式建模方法,它学习一个确定性速度场,将初始噪声分布通过常微分方程轨迹逐步传输到目标数据分布。与传统扩散模型相比,CFM 训练形式更直接,采样过程可通过较少的 ODE 步数完成。本文将 CFM 引入 MDCT 频谱增强任务,使模型从粗解码频谱出发,在条件信息约束下恢复更接近真实语音的频谱结构。
【研究方法】
概述
CFMDCTCodec 的整体框架由两个主要部分组成:单码本 MDCT 频谱编解码器,以及噪声先验感知的 CFM-MDCT 频谱增强器。给定输入语音波形,模型首先通过 MDCT 得到实值频谱表示;随后前端编解码器将其编码、量化并解码为粗 MDCT 频谱;增强器在粗频谱的条件引导下生成增强后的 MDCT 频谱;最后通过反 MDCT 将增强频谱还原为语音波形。
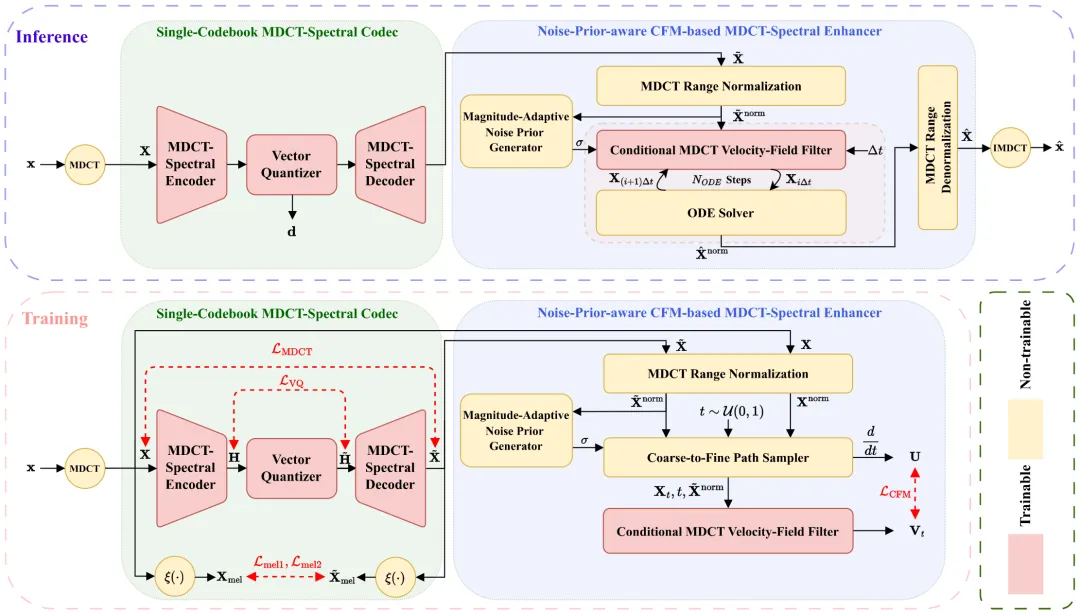
图1:CFMDCTCodec 的总体框架。模型在推理阶段由单码本 MDCT 频谱编解码器与噪声先验感知 CFM-MDCT 频谱增强器组成;训练阶段采用端到端联合优化。
单码本 MDCT 频谱编解码器
前端编解码器以 MDCT 频谱为输入,使用 ConvNeXt-v2 风格的一维频谱编码器提取紧凑潜在特征,并通过单个向量量化码本生成离散 token。与 RVQ 不同,单码本量化不依赖多级残差累加,因此能够在极低码率下保持简洁的离散表示。解码器与编码器结构相对应,将量化后的潜在表示重建为粗 MDCT 频谱。为了缓解单码本训练中的码本塌缩问题,论文还引入了 codebook forced updating 策略,以提升码本使用稳定性。
噪声先验感知的 CFM-MDCT 频谱增强器
增强器是 CFMDCTCodec 的关键创新。由于低码率 token 只能恢复粗略频谱结构,直接将粗频谱作为最终输出会造成高频谐波缺失和明显伪影。为此,本文首先对粗 MDCT 频谱进行范围归一化,使其落入更稳定、更适合神经网络优化的数值区间;随后根据粗频谱的局部幅度能量构造 magnitude-adaptive noise prior,使噪声初始状态与语音频谱能量分布相适配。
在 CFM 过程中,模型学习一个条件 MDCT 速度场滤波器。该滤波器以当前状态、粗频谱条件和时间嵌入为输入,预测从初始噪声状态到目标高质量频谱之间的速度方向。推理时,ODE 求解器从噪声先验出发,经过少量步数逐步得到增强后的归一化 MDCT 频谱,再通过反归一化与 IMDCT 生成最终语音。
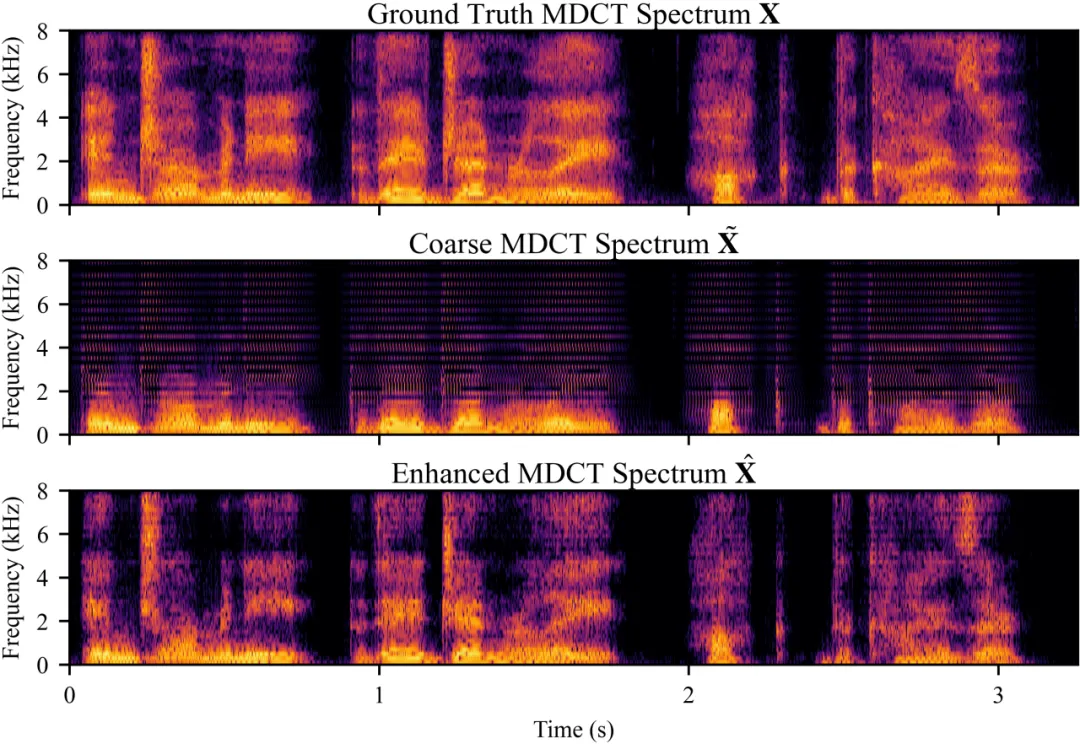
图2:0.65 kbps 条件下的 MDCT 频谱可视化。粗重建频谱在高频区域损失明显,经过 CFM-MDCT 增强后,谐波结构和时频轨迹更加接近真实频谱。
端到端联合训练
不同于先训练 codec、再冻结 codec 训练后处理器的两阶段范式,CFMDCTCodec 采用非对抗式端到端联合训练。训练目标由 MDCT 频谱重建损失、多尺度 mel 重建损失、量化损失和 CFM 损失共同组成,使前端编解码器的粗输出分布与后端增强器的输入需求共同适配。论文中的训练方案消融表明,联合训练显著优于两阶段训练,说明在低码率场景下,codec 与生成式增强器之间的协同适配十分关键。
【实验结果】
论文在 16 kHz LibriTTS 与 48 kHz VCTK 数据集上进行了系统实验,覆盖 0.65 kbps、1.3 kbps、1.95 kbps 和 3.9 kbps 等码率设置,并从客观指标、主观 MUSHRA 测试、实时因子、FLOPs、参数量以及消融实验等多个角度评估模型性能。
表1:16 kHz LibriTTS 测试集上 0.65 kbps 低码率条件下的质量相关结果(节选)
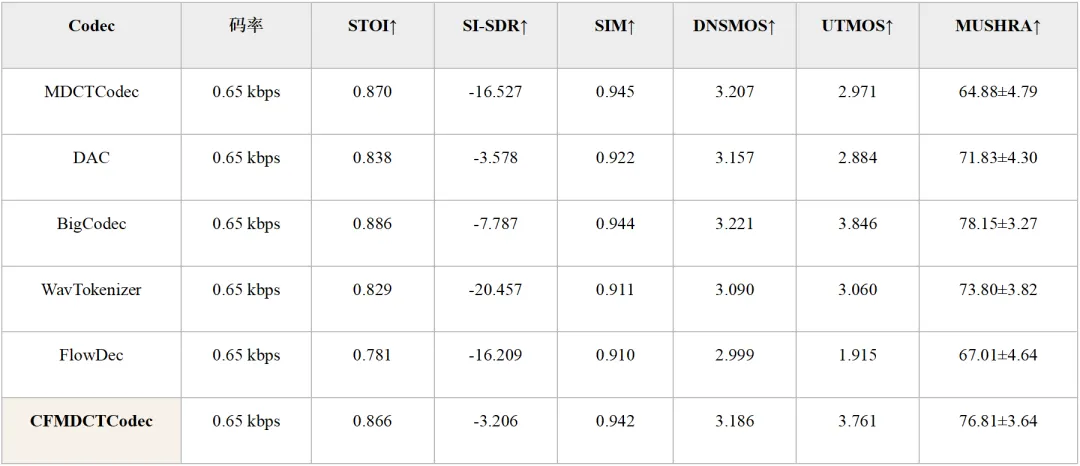
在极低码率 0.65 kbps 条件下,CFMDCTCodec 的主观 MUSHRA 得分达到 76.81±3.64,相比轻量级 MDCTCodec 提升约 12 分,并明显优于 DAC、WavTokenizer 和 FlowDec 等代表性基线。与大规模 BigCodec 相比,CFMDCTCodec 的主观得分略低,但二者已经处于相近区间;考虑到 BigCodec 依赖上亿参数规模,而 CFMDCTCodec 保持较轻量的 MDCT 域建模,这一结果体现了本文方法在质量与复杂度之间的优势。
表2:16 kHz LibriTTS 测试集上 0.65 kbps 条件下的效率与复杂度结果(节选)
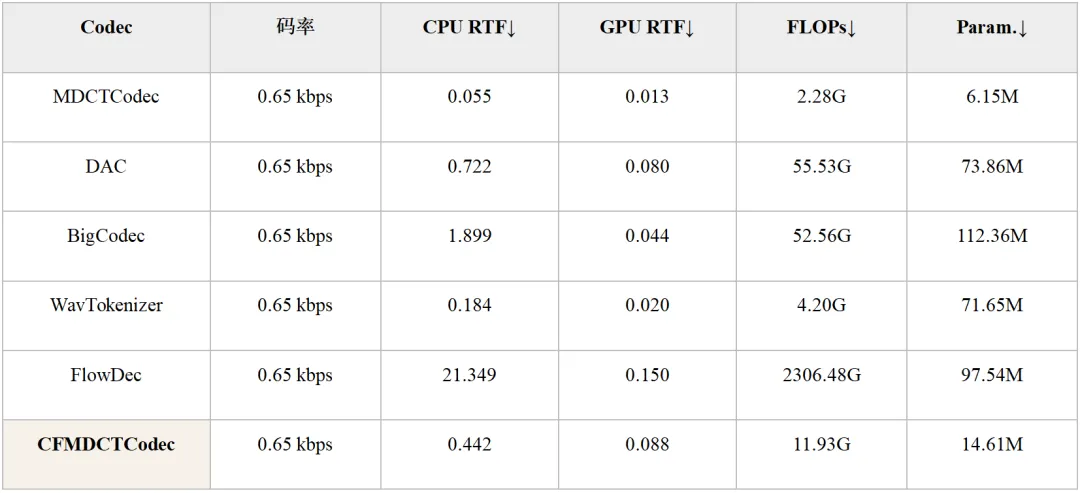
效率方面,CFMDCTCodec 在 0.65 kbps 下可在 CPU 和 GPU 上实现实时生成。与 DAC 相比,其 FLOPs 约为 DAC 的 20%;与 BigCodec 相比,其参数量仅约为 13%,FLOPs 也低于后者四分之一;与同样使用 CFM 后处理思想的 FlowDec 相比,CFMDCTCodec 的计算量和 CPU RTF 均大幅降低。这说明,将 codec 与增强器统一放在实值 MDCT 域内建模,可以显著减少复杂值 STFT 或波形域处理带来的额外开销。
消融实验与可视化分析
论文进一步对增强器中的两个核心设计进行了消融分析:MDCT 范围归一化与 magnitude-adaptive noise prior。去除范围归一化会降低 DNSMOS 和 UTMOS,说明归一化有助于稳定 CFM 在重尾 MDCT 系数分布上的训练;将自适应噪声先验替换为固定全局噪声也会导致多项指标下降,特别是频谱失真相关指标明显变差。可视化结果显示,自适应噪声先验能够帮助模型恢复更明亮、更连贯的高频结构,避免过平滑和细节衰减。
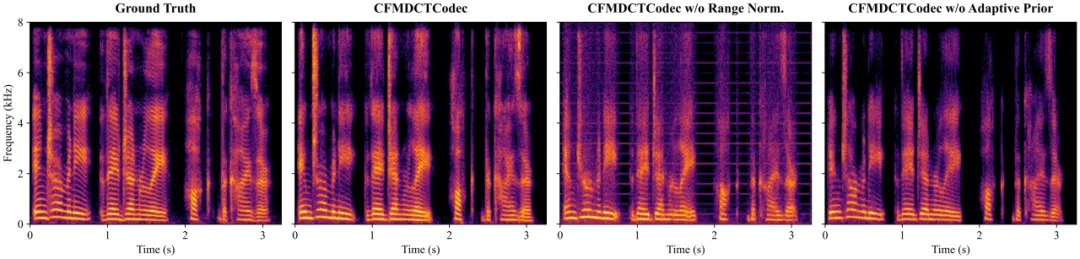
图3:CFMDCTCodec 与两个消融变体的频谱可视化。去除范围归一化或自适应噪声先验后,频谱细节恢复和高频能量保持均出现退化。
此外,论文比较了 MDCT 与 STFT 表示在相同框架下的表现。结果表明,在 0.65 kbps 条件下,MDCT 版本在多数质量指标上优于 STFT 版本,并且 FLOPs 与参数量显著更低。其原因在于 STFT 需要同时处理实部和虚部,而 MDCT 的实值表示更适合与轻量级频谱 codec 和 CFM 增强器结合。
【结论】
本文提出了 CFMDCTCodec,一种面向低码率语音编码的 MDCT 域神经语音编解码方法。该方法将单码本 MDCT 频谱编解码器与噪声先验感知的 CFM-MDCT 频谱增强器结合,在极低码率下先生成粗重建频谱,再通过条件流匹配恢复缺失的频谱细节。与依赖多级 RVQ、超大模型或复杂两阶段后处理的方法相比,CFMDCTCodec 在结构上更加紧凑,并通过端到端联合训练提升了 codec 与增强器之间的协同适配能力。
大量实验表明,CFMDCTCodec 在 0.65 kbps 低码率场景中能够显著改善主观听感,并在接近大模型感知质量的同时大幅降低参数量和计算量。该工作说明,MDCT 频谱域不仅可以用于轻量化神经 codec,也可以作为生成式频谱增强的有效建模空间,为低带宽语音通信、远程传输和实时语音服务提供了一条具有实际部署潜力的技术路线。未来工作将进一步探索更低码率、更低算法延迟和更适合流式通信的 CFMDCTCodec 配置。
【论文链接】https://arxiv.org/abs/2605.26812
【代码及Demo链接】https://xhjiang1.github.io/CFMDCTCodec/
整理编辑:张雯,李雅
初审|吴锡欣,复审|朱 璇,终审|凌震华
