
 语音小管家
录取信息:ICML 2026
论文标题:SPEAR: A Unified SSL Framework for Learning Speech and Audio Representations
作者:Xiaoyu Yang, Yifan Yang, Zengrui Jin, Ziyun Cui, Wen Wu, Baoxiang Li, Chao Zhang, Phil Woodland
主要单位:剑桥大学、上海人工智能实验室、清华大学
论文链接:https://arxiv.org/pdf/2510.25955
开源地址:https://huggingface.co/collections/marcoyang/spear-encoders
⏩TL;DR
长期以来,声音编码器在“语音语义理解”与“音频环境感知”之间存在性能割裂。针对这一声音基础模型的核心瓶颈,剑桥大学、上海人工智能实验室、清华大学等研究团队提出了全新的统一自监督表征学习框架SPEAR(已入选ICML 2026)。
核心痛点:攻克了传统单一编码器无法同时兼顾人类语音(speech)高层语义理解与通用音频(general audio)多维环境感知的缺陷,打破了双域难以融合的底层壁垒。
关键创新:针对语音和通用音频信息尺度不同的挑战,创新性地将多码本向量量化(MVQ)与掩码自监督预训练相结合;并首次提出动态Token-Mixing机制,专门强化模型在现实复杂混叠声场中对多声源的独立建模能力。
卓越性能:成功打破双域性能回退瓶颈。SPEAR在语音(SUPERB)和通用音频(HEAR)两大主流Benchmark上均取得了SOTA表现:在SUPERB上全面超越语音SOTA模型WavLM Large,在HEAR上与相同参数量的音频专家Dasheng持平。
应用前景:为构建多模态大语言模型(MLLMs)的全能听觉前端提供了全新的融合思路,展现出替代传统分立式双编码器设计的巨大潜力。
⏩背 景
随着自监督学习(Self-Supervised Learning, SSL)的飞速发展,文本与视觉领域已率先确立了统一的通用表征范式。然而,在听觉信号领域,长期以来“人类语音”与“通用音频(如环境音、音乐等)”这两个子领域一直处于割裂状态。
语音自监督模型(如WavLM)善于捕捉人类说话的语义、声调和说话人身份,把通用音频(如环境音等)当作“噪声”过滤掉;
通用音频自监督模型(如Dasheng)则擅长分辨音频事件,例如动物的叫声、机器轰鸣或各种乐器声。但在面对人类语音时,它往往只能得出诸如“有人在说话”的结论,难以解析其中丰富的语义细节。
然而,在真实世界的声学场景中,这两类信号往往是高度混叠、交织在一起的。例如,在嘈杂街头的边走边聊、在背景音乐环绕的咖啡厅里开会,或是伴随警笛呼啸的紧急呼救。对于这些复杂声场,一个理想的通用听觉编码器不仅需要精准理解人类说话的语义信息(语音维度),更需要敏锐地捕捉背景环境中的声学事件与场景特征(通用音频维度)。
现有的单一领域自监督模型由于设计初衷的局限,显然无法同时兼顾语音和通用音频这两个领域。为了解决这一痛点,现有的折中方案往往采用双编码器级联(例如同时挂载Whisper与BEATs)。然而,由于两个独立模型的输入格式、特征维度和帧率通常并不一致,在进行多模态融合时必须设计繁琐的对齐与投影适配器,这极大地增加了整体系统的设计复杂度。
那么,能否仅使用单个自监督编码器,同时构建语音语义理解与通用音频感知的统一表征空间?
⏩01核心挑战:双域联合预训练的冲突与瓶颈
构建能够兼顾语音与通用音频的统一自监督模型面临以下三大核心技术瓶颈:
1.关注的信息维度截然不同(高层语义vs.声学细节):
语音高度依赖高层语义,适合利用粗粒度的掩码预测(如k-means离散化目标)来捕获上下文关联。而通用音频则包含大量不规则的声学微观细节,传统的离散聚类会因分辨率不足,导致高频声学特征大幅丢失。
2.现有的SSL目标不适用于混合数据的训练:
在联合预训练中,直接搬用现有的SSL目标无法在双域混合数据上取得理想效果。实验表明,即便是在各自领域表现优异的特征预测模型(如data2vec),一旦在语音与音频的混合数据上进行训练,其表现也会显著弱于分别训练的单领域专家模型,出现性能回退。
3.真实世界复杂的混叠声场缺乏有效建模:
现实中的音频往往伴随着噪声和多方说话人的重叠。然而,现有的自监督模型大多在干净的单音源数据上训练,或者采用“强行去噪”的机制来保护语音主信号。这种做法虽然对语音有利,但却粗暴地滤除了背景人声或环境声,导致模型无法还原声场中完整的环境事件特征。
⏩02 SPEAR核心方法:基于细粒度MVQ量化的多专家蒸馏
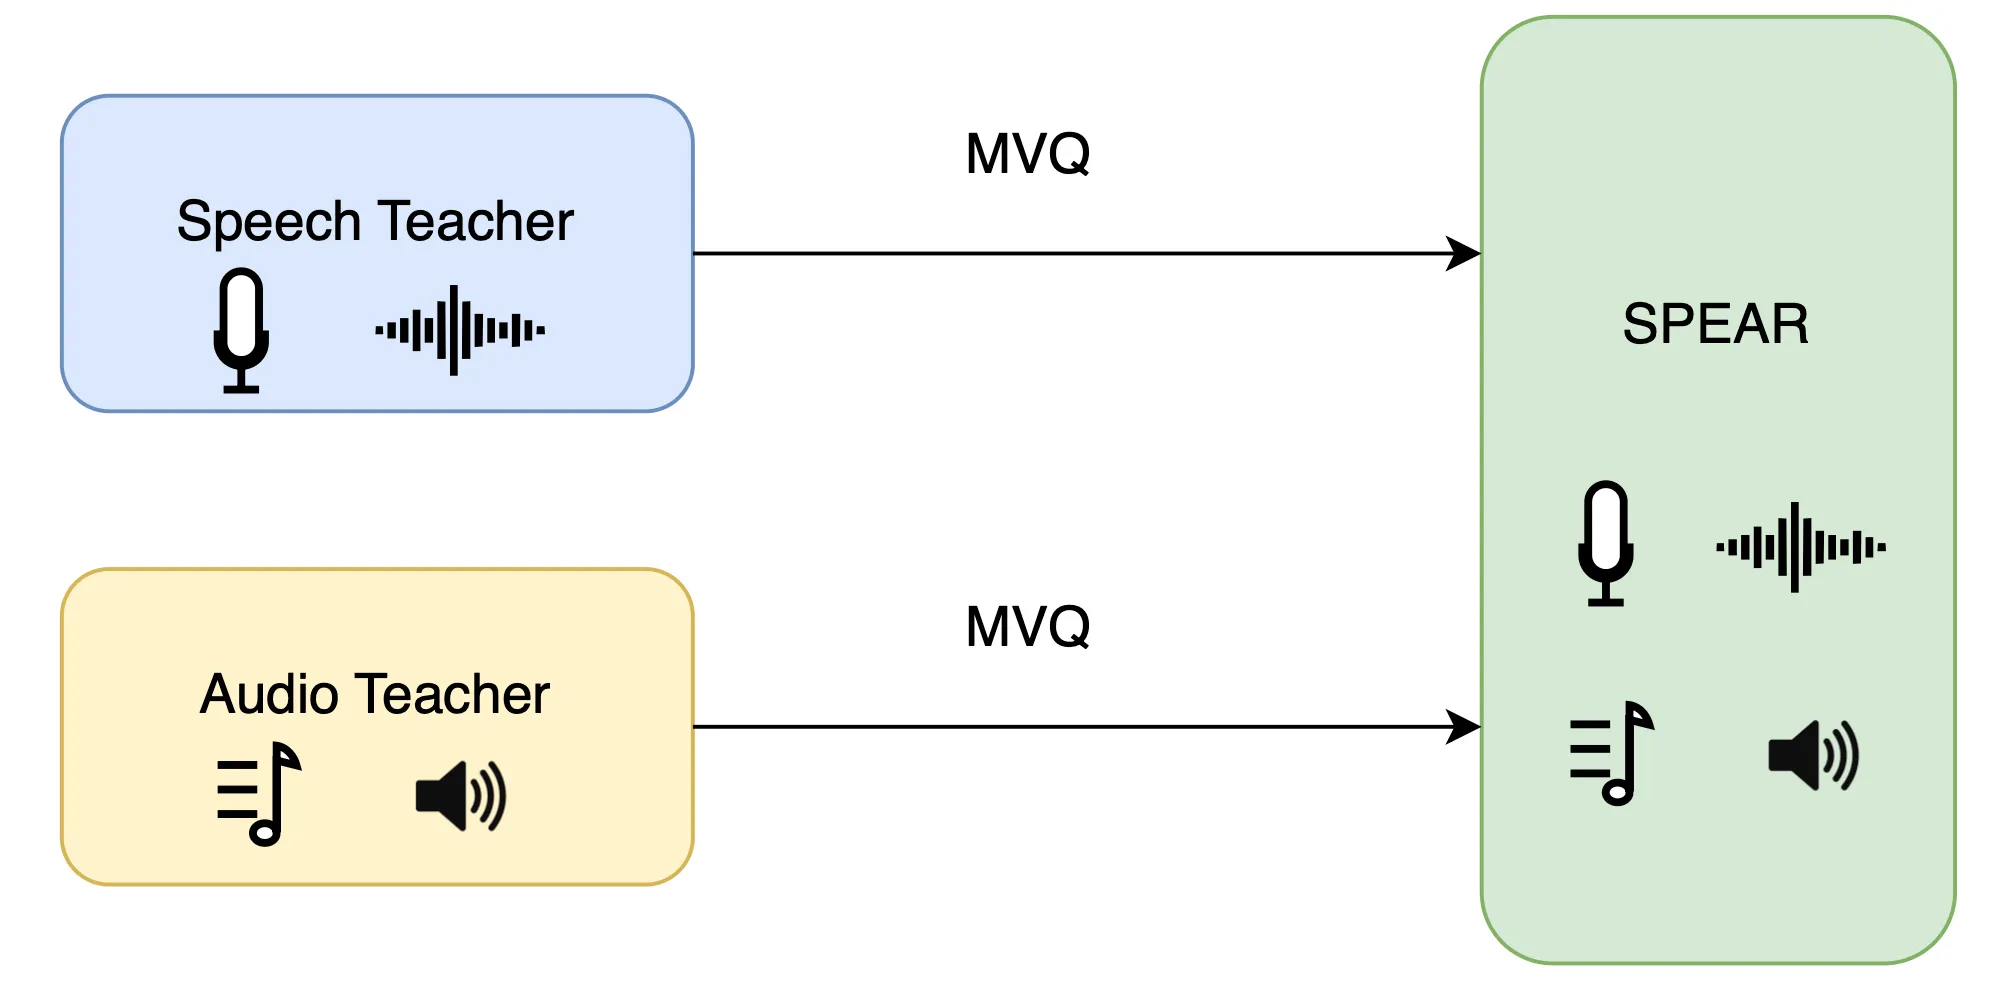
为了克服上述瓶颈,SPEAR框架提出了一种通过多教师知识蒸馏(Knowledge Distillation)将单域专家表征进行对齐与融合的方案,并引入了一系列创新的底层机制:
1\.互补型双教师蒸馏
SPEAR引入了两个领域的顶尖自监督专家作为教师模型,从而继承其互补的表征优势:
语音域教师:WavLM Large,具备极强的音素、语义以及副语言表征能力。
通用音频域教师:Dasheng 1.2B,在大规模混合音频上经过自编码重构(MAE)训练,具备极佳的时频微观细节捕获能力。
2\.基于MVQ多码本离散标签的自监督预训练
传统的掩码语言建模(如HuBERT)通常采用k-means将教师的连续特征离散化,这在表达频谱结构更为复杂的通用音频时分辨率严重不足。
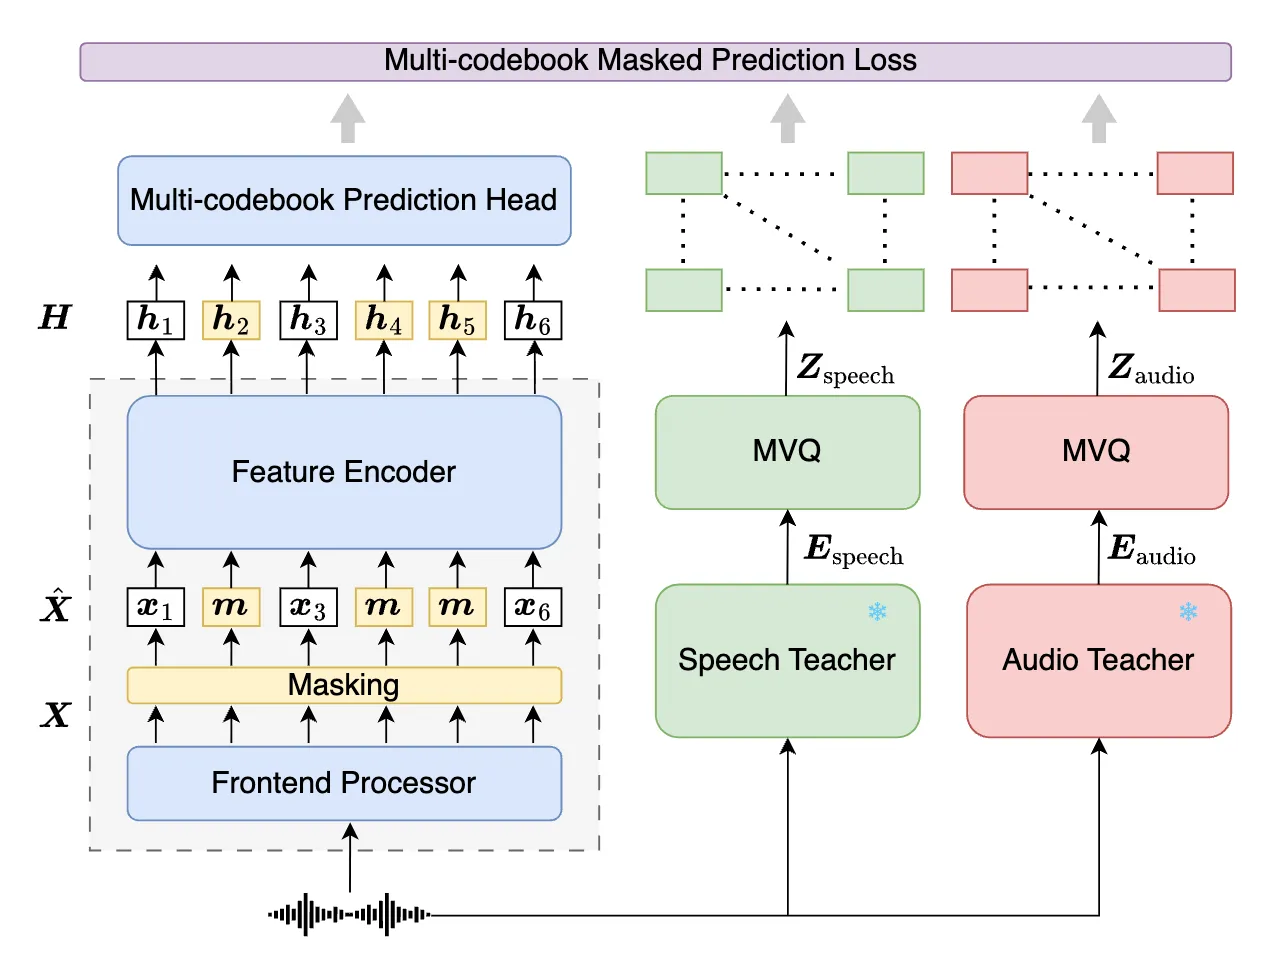
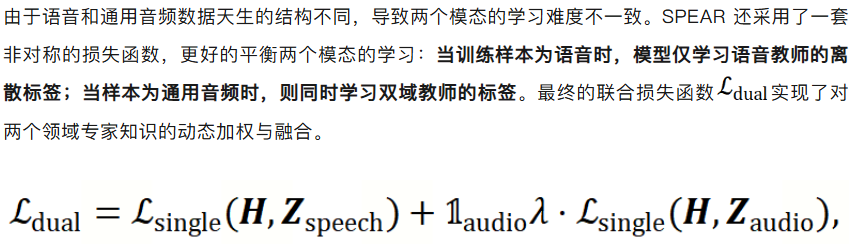
在预训练阶段,SPEAR会同时对语音和通用音频两个专家的所有码本目标进行掩码预测训练(Masked Language Modeling)。这种联合多码本监督机制强迫模型在同一个表征空间中对齐并融合两个领域的专家知识。示意图如下:
3\.动态Token混合机制(Token Mixing)
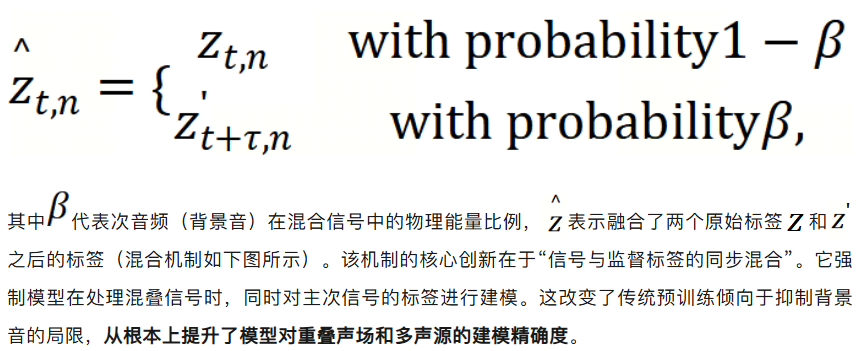
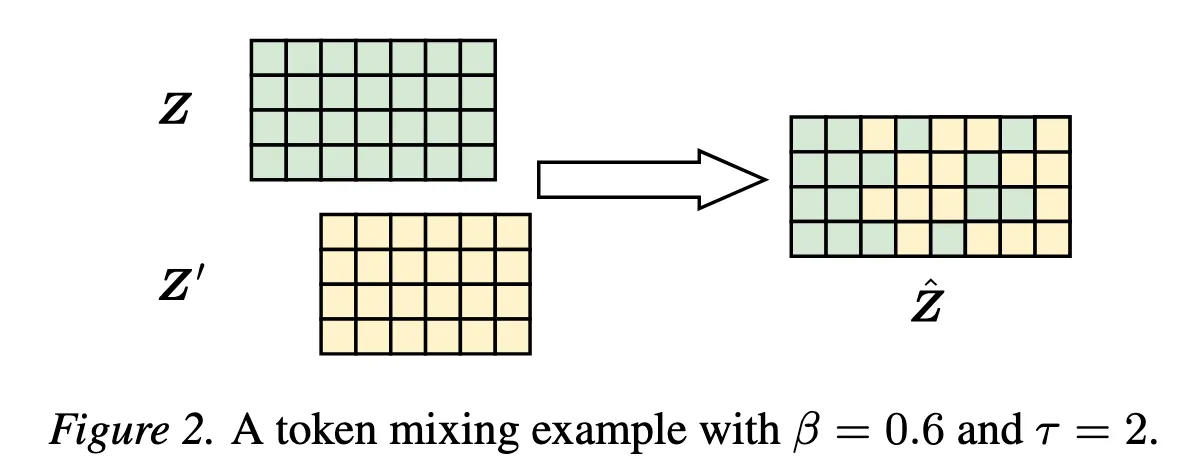
针对真实世界复合声学场景中模型建模能力缺失的痛点,SPEAR抛弃了传统“仅保留单一主音源、消除背景音”的降噪策略,提出了全新的Token-Mixing机制。
在训练中,我们将主音频与次音频按照其物理能量比例进行线性混合。与以往模型不同的是,我们不仅在输入端混合波形,连提取出的预训练MVQ监督标签也按照相同的能量比例进行概率混合:
⏩03实验结果:双域通用表征能力的全面展现
研究团队在ASR(语音识别)、Audio Tagging (AT)(音频事件标签)两个经典的下游全微调任务,以及SUPERB、HEAR两个主流的通用表征评测基准上,对双域统一模型SPEAR进行了全方位评估。
1\.下游微调任务表现:单一编码器全面超越双领域基线与单域专家
实验在LibriSpeech 100小时(ASR)和AudioSet 20k/2M (AT)上进行。下表展示了全微调后的实验结果:
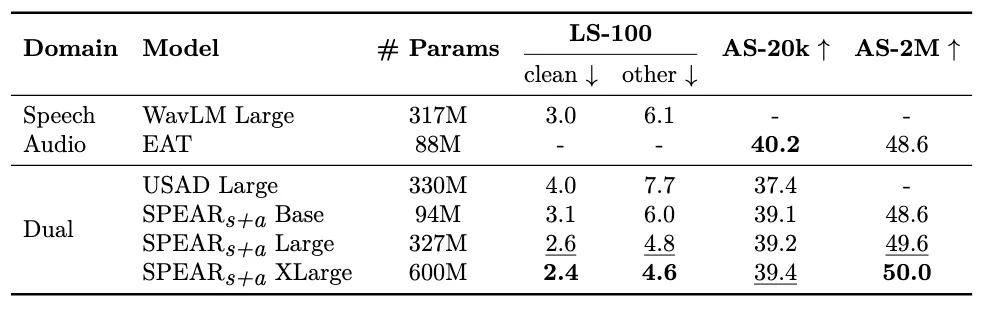
实验结果表明,相较于此前双领域模型USAD,SPEAR表现出更全面且显著更优的性能。在ASR任务上,SPEAR的表现不仅大幅超越双领域基线模型USAD Large,更显著优于纯语音领域的专家模型WavLM Large,取得了2.6/4.8(Large)和2.4/4.6(XLarge)的词错率。同时,在侧重通用音频感知的AT任务上,SPEAR的表现同样突出,在AS-2M上取得了高达50.0的mAP。这有力地验证了SPEAR作为一个统一的声音编码器,同时学到了高质量的语音语义和通用音频特征。
2\. SUPERB语音通用性评估:副语言与复杂声场能力的跨越式提升
SUPERB (Speech processing Universal PERformance Benchmark)是一个全方位衡量语音SSL模型特征通用表征能力的基准测试,包含15种语音相关的任务。在冻结自监督特征、仅微调轻量下游网络的设定下,SUPERB基准能够真实、客观地反映原始模型表征在各项语音任务上的泛化能力。
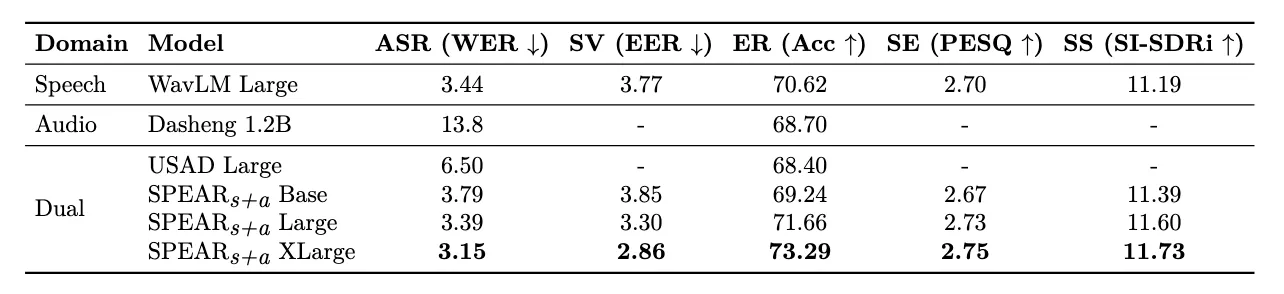
SPEAR在语音基准SUPERB上超越纯语音预训练的WavLM Large:
副语言能力的显著提升:传统的k-means离散化由于分辨率过低,在聚类时会抹去细微的声学波动,导致说话人和情感特征受损。而SPEAR采用的MVQ量化通过多独立码本组合出指数级状态,保留了的更细腻的时频声学细节,使说话人验证(SV)和情绪识别(ER)表现实现显著提升。
复杂声场鲁棒性的显著增强:常规SSL预训练通过“去噪”强行抑制背景信号,限制了模型处理复合声场的能力。我们提出的Token-Mixing机制通过在预训练阶段对多源音频及对应的MVQ标签进行动态比例混合,让SPEAR在预训练中就具备了同时对多个声音事件进行完整建模的感知力,因此在语音分离(SS)、语音增强(SE)上优势明显。
3\.综合音频特征评估:打破领域壁垒,兼备专家级通用音频感知能力
HEAR基准测试涵盖了环境(Env)、语音(Speech)和音乐(Music)三个领域的18个任务。相较于SUPERB,HEAR测试更关注通用音频特征的质量。下表对比了纯语音模型WavLM、纯音频SOTA模型Dasheng 0.6B以及我们的双领域SPEAR模型的表现:
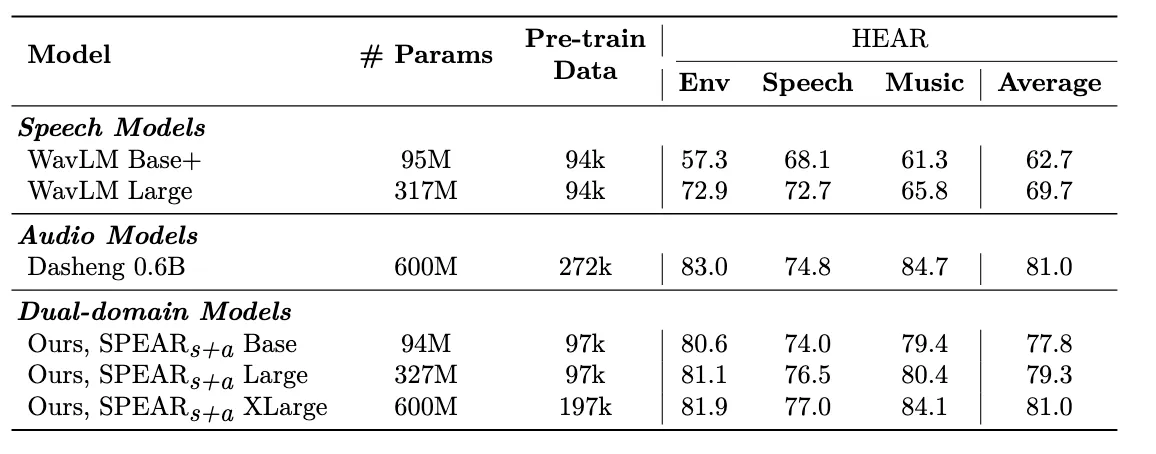
HEAR基准测试本身是一个高度偏向通用音频感知的评估集。因此,传统的语音专家模型(如WavLM)表现出明显的跨域泛化局限,平均分仅为69.7。
SPEAR XLarge则展现出了与顶尖音频专家并驾齐驱的极强表现。作为一个双领域统一模型,SPEAR在HEAR上斩获了81.0的平均分,与专门针对通用音频优化的音频专家Dasheng 0.6B持平。值得注意的是,SPEAR成功打破了双域模型常见的性能权衡瓶颈。 它在HEAR基准上斩获了81.0的平均分,追平了专门针对通用音频优化的音频专家模型Dasheng 0.6B;与此同时,它依然保持了在语音领域(SUPERB基准)上的顶尖性能。这种双域兼顾的能力,是传统单领域专家模型所不具备的。
⏩04核心消融研究
1\.离散标签选择:MVQ vs k-means
为了探究MVQ在预训练中的作用,我们使用相同的教师模型分别抽取MVQ(16码本)和经典k-means(2000聚类中心)作为监督标签分别进行预训练,并且保持其他的训练设定一致。两种方案的结果对比如下:
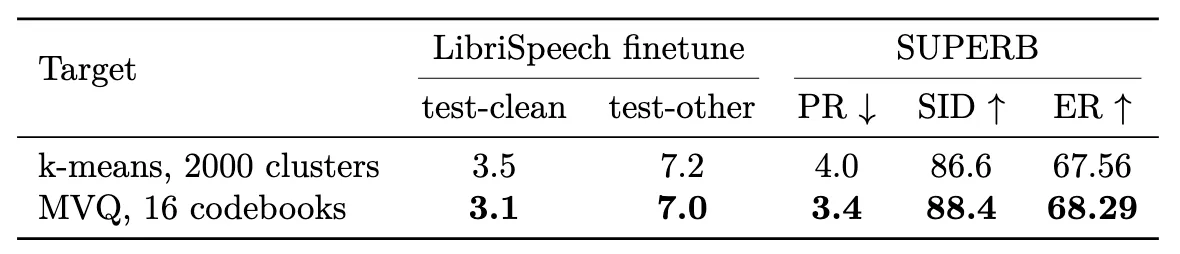
实验表明,使用细粒度的MVQ作为预训练标签显著优于k-means标签。在维持语义理解能力(ASR,PR)的同时,编码器学习到了更丰富的副语言特征,在说话人识别(SID)和情感识别(ER)上显著优于k-means标签。这都要归功于MVQ的多码本设计。为此,我们还研究了MVQ中的不同码本,发现其中一个256-class的码本特别擅长捕捉说话人特征(详见论文附录F.4)。
2\.复合场景建模:Token-Mixing效能验证
我们在涉及重叠声源建模的任务(说话人日志SD、语音分离SS、语音增强SE)中,在都适用MVQ作为训练标签的情景下,比较了无增强、WavLM降噪策略以及我们提出的Token-Mixing机制:
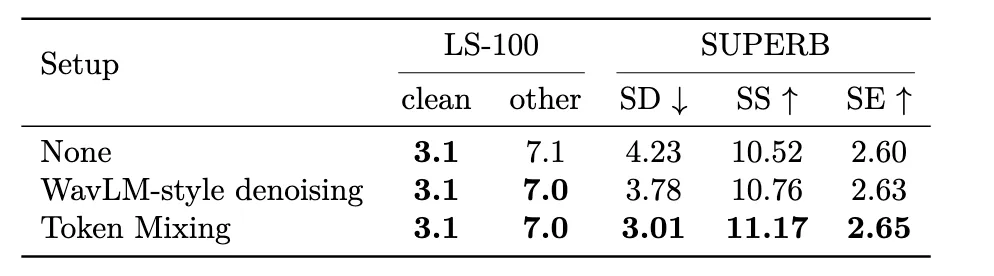
我们发现,Token-Mixing在这几项任务上显著强于传统的WavLM式的降噪策略。这是由于传统的降噪策略倾向于忽略和抑制次要声源、仅保留主声源信号,导致其在处理复杂声场任务时显得“力不从心”。而Token-Mixing的训练目标同时兼顾主次目标信号的内容,在复杂混叠声学场景的任务中展现出明显的优势,证明了该创新机制的卓越性能。
⏩05结 论
SPEAR的提出,成功解决了语音语义理解与通用音频感知难以在单一编码器下调和的难题。
尤为重要的是,SPEAR展现出了作为多模态大语言模型(MLLMs)下一代听觉前端的巨大应用潜力。通过无缝替代现有的分立式双编码器设计,SPEAR能够以单一底座同时为大模型注入全面的语义理解与声学环境感知能力。这不仅能有效精简系统架构,更将助力多模态大模型获得更为完整、立体的听觉交互体验。
