
 语音小管家
资源导航
论文链接:https://arxiv.org/abs/2605.19833
项目主页:https://xzf-thu.github.io/Mega-ASR/
GitHub Repo:https://github.com/xzf-thu/Mega-ASR
Hugging Face 模型:https://huggingface.co/zhifeixie/Mega-ASR
Hugging Face 数据集:https://huggingface.co/datasets/zhifeixie/Voices-in-the-Wild-2M
发布机构:NTU(南洋理工大学)、NUS(新加坡国立大学)、上海人工智能实验室
发布日期:2026 年 5 月 19 日
开源协议:Apache 2.0(完全开源,可商用)
先说一件可能让人有点意外的事。
现在的 ASR(自动语音识别)模型,在干净录音室里录的音频上,词错误率(WER)能压到 1% 以下。
听起来很完美对吧?
但你把麦克风搬到地铁上试试。
或者开一个网络不稳定的视频会议。
或者让人站在门后、用手捂着嘴说话。
WER 直接飙到 10%、30%,严重的时候能到 70%。
这不是在夸张,这是论文里白纸黑字写的现实数据。
这就是所谓的"声学鲁棒性瓶颈"——模型在实验室里很优秀,到了真实世界里就开始翻车。
Mega-ASR 这个项目,就是专门冲着这个问题来的。
Mega-ASR 是一个专门解决"真实世界语音识别翻车"问题的开源框架——它用涵盖54种噪声、回声、丢帧等复合场景的240万条数据训练,让模型在嘈杂现实环境下的词错误率降低30%+,同时大幅减少"听没了"和"乱编内容"这两种高频故障。完全开源,Apache 2.0协议。
简单说,它要解决的核心问题是:在各种嘈杂、失真、回声、断连的现实场景下,尽可能准确地把语音转成文字。
它不是一个从零开始的全新 ASR 模型。它基于 Qwen3-ASR-1.7B(阿里 Qwen 团队 2026 年 1 月发布的开源语音识别模型)进行后训练,通过一套专门设计的数据集和训练方法来强化"恶劣环境下的识别能力"。
Qwen3-ASR 本身已经在干净和轻度噪声场景下表现很强了,Mega-ASR 相当于在它基础上专门补了"脏活累活"这块短板。
在语音识别这个领域,目前能用到的主流选择大概有这几类:
通用开源 ASR 模型
Whisper Large-v3 是 OpenAI 的老牌模型,在多语言和干净音频上表现稳定,但碰到复杂噪声环境掉得比较厉害。
Qwen3-ASR-1.7B 是 2026 年初登场的开源新星,在标准 benchmark 上表现很亮眼,在轻中度噪声下也还行,但真到了极端噪声或者多重失真叠加的场景,就开始出问题了。
Kimi-Audio、Step-Audio-2-mini、Voxtral-Mini 等大音频语言模型(LALM)在理解和对话上有优势,但鲁棒性不是它们的主攻方向。
闭源商业模型
Gemini-3-Flash、GPT-4o-transcription 这类闭源 API,在干净场景下能力很强,但在极端噪声下也会产生严重的"幻觉输出"(就是说了一堆听起来很流畅但完全不是原文的内容)。
Mega-ASR 的定位
Mega-ASR 不打算在干净场景下争第一,它的目标是在复合型恶劣声学条件下做到最好的识别,同时保留干净场景下的基础能力。
这是一个取舍清晰的定位,不是"我全都要"。
有一个背景值得提:2026 年 1 月 Qwen3-ASR 发布之后,开源 ASR 领域经历了一次比较大的洗牌。Qwen3-ASR-1.7B 在多语言标准 benchmark 上超过了 Whisper Large-v3,而且开源 Apache 2.0,整体体验做得很完整。在那之后,"怎么在 Qwen3-ASR 基础上进一步强化某些能力"就成了一个自然的研究方向。Mega-ASR 是其中瞄准"复杂声学鲁棒性"这个细分问题的一个工作。
另外 Kimi-Audio、Step-Audio 系列这类大音频语言模型(LALM)虽然参数量更大(7B 级别),在这个 benchmark 上反而未必比 Mega-ASR 好——主要原因是它们的设计目标更偏向理解和对话,对极端噪声的鲁棒性训练没有针对性地加强过。这倒不是说它们差,而是大家解决的问题侧重点不同。
说"嘈杂环境",其实是把很多不同性质的问题混在一起说了。
论文里把常见的声学干扰拆成了 7 种"原子效应":
•噪声(Noise):街头、餐厅、车内的背景音 •远场(Far-field):说话人离麦克风很远,信号衰减严重 •遮挡(Obstructed):隔着门、墙、口罩说话,高频信号损失大 •回声与混响(Echo & Reverb):大厅、地下车库、教堂里的声音反射 •录音失真(Recording Coloration):用手机外放再被另一台设备录下来这种情况 •电子失真(Electronic Distortion):设备过载、信号剪切造成的波形变形 •传输丢帧(Transmission Dropout):网络不好导致的音频断断续续
这 7 种在现实中很少单独出现。
你在一个吵闹的餐厅里用蓝牙耳机开视频会议,背景噪声、远场衰减、传输丢帧可能同时存在。
这就是为什么现有模型普遍翻车——它们的训练数据基本只覆盖了单一的轻度干扰,根本没见过"三件套"同时叠加的情况。
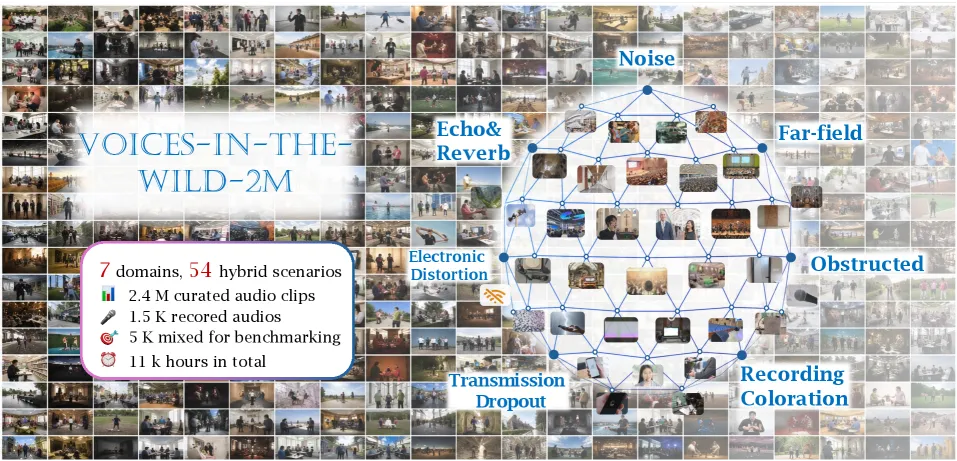
📷论文 Figure 2:VOICES-IN-THE-WILD-2M 数据集的结构图,展示了从 7 个元场景扩展到 54 个混合场景的覆盖范围。
Mega-ASR 提出了一个新的大规模数据集VOICES-IN-THE-WILD-2M。
规模:2.4M 个音频片段,共约 11,000 小时。
覆盖:7 种原子声学效应,54 种复合声学场景。
这 54 种是怎么来的?
逻辑比较清晰:把 7 种原子效应分成两类——"场景锚定效应"(远场、回声混响、遮挡)和"可携带修饰效应"(噪声、录音失真、电子失真、传输丢帧)。
锚定效应决定主声学环境,修饰效应可以附加在任何环境上。
54 个场景的构成:7 个单一效应场景,18 个双效应场景(锚+修饰的组合,以及修饰之间的两两组合),13 个三效应场景,16 个更高阶的组合场景(论文 Table 17 有完整枚举)。
然后有个 AI Agent 在组合的时候做"物理合理性检验"——比如教堂场景就应该有远场加回声,而不会随便组合出"远场加远场"这种不合理的情况。
这个 Agent 验证机制有点意思,相当于给数据生成加了一道常识过滤,而不是暴力枚举所有可能组合。比如"传输丢帧+录音失真"这种组合是合理的,因为手机录音里同时出现网络卡顿和设备失真很正常;但"回声混响+回声混响"这种重复叠加就被排除了。
数据集的另一个特点是难度分布设计。
论文做了一个对比实验:用线性分布、偏简单、偏困难、中等集中几种采样策略分别生成数据,最终选择了线性分布(论文 Figure 3 展示了各策略的训练曲线对比)。
原因很直接——线性分布对简单、中等、困难样本的覆盖最均衡,最终下游鲁棒性最好。
还有一个细节:WER 超过 70% 的样本会被过滤掉。
不是因为这些样本没意义,而是它们会让训练不稳定——损失函数在这种"几乎什么都识别不出来"的情况下会抖得很厉害。
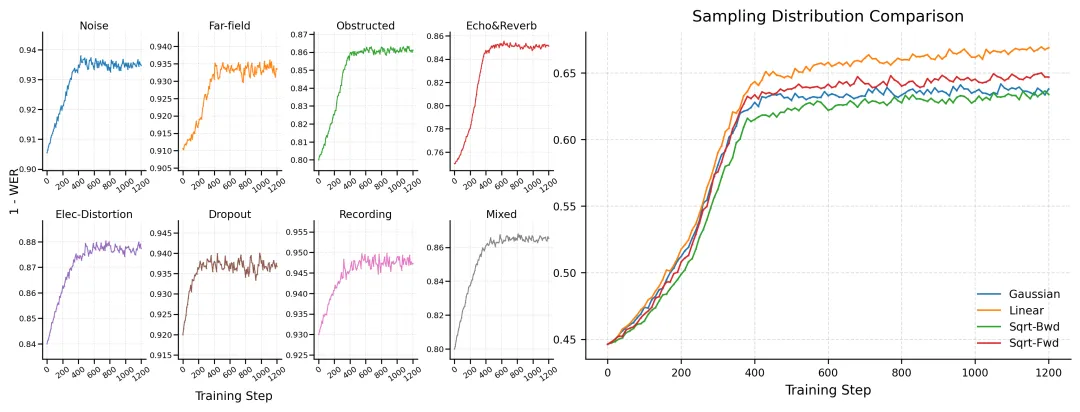
📷论文 Figure 3(左):在不同原子效应单独训练与混合训练后,在真实音频上的 SFT 精度曲线。
对比一下已有的鲁棒性数据集,可以看出差距(论文 Table 1):
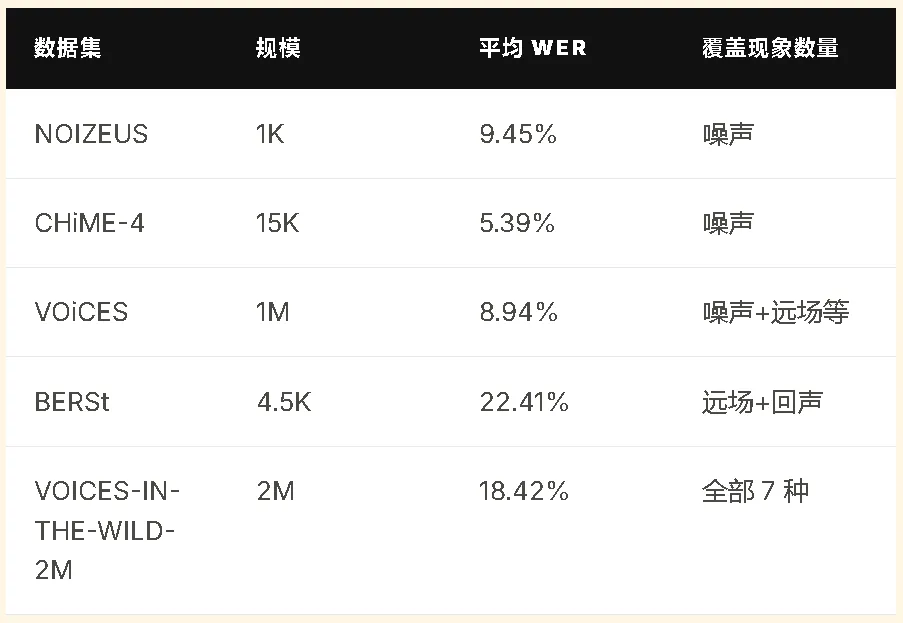
18.42% 的平均 WER 说明这个数据集整体难度就比其他的高一个档次——这才是真实世界的样子。
数据有了,怎么训练是另一个问题。
Mega-ASR 的训练分两个阶段。
第一阶段:A2S-SFT(声学到语义的渐进式监督微调)
这个名字有点长,核心逻辑其实很简单。
模型在复杂噪声下会出两种问题:
一是音频编码器没法从失真信号里提取可靠的声学特征——编码器层面的问题;
二是就算提取出了一些线索,语言模型没法从这些不完整的线索里推断出正确的语义——语义推理层面的问题。
两个问题得分开解决。
A2S-SFT 分三步走:
第一步:只训练音频编码器和对齐层,用 WER 分级课程学习——先用 WER<30% 的相对简单样本,再扩到 WER<50%,最后到 WER<70%。从容易到难,逐步提升声学感知能力。
第二步:冻住编码器,只训练语言模型部分,让它学会从不完整的声学信号里"猜"出正确语义。
第三步:三部分一起联合微调,做端到端对齐。
这个"先练耳朵再练大脑最后一起磨合"的逻辑,其实挺符合人学听外语的过程的——先适应语音,再靠上下文理解,最后整合。当然,跟人脑实际机制肯定差很远。
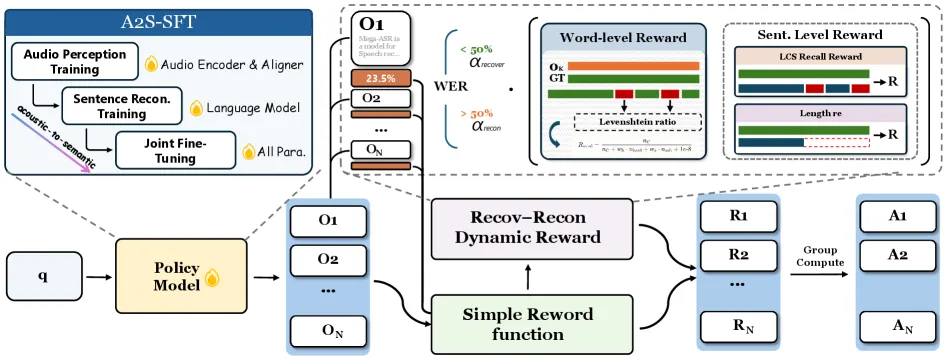
📷论文 Figure 4:DG-WGPO 框架的整体流程图,从 A2S-SFT 初始化开始,到策略模型生成多个假设并由动态奖励评分。
图片来源:https://xzf-thu.github.io/Mega-ASR/assets/training.png
第二阶段:DG-WGPO(双粒度 WER 门控策略优化)
这是强化学习阶段,基于 DAPO 框架。
发现了一个挺关键的训练现象:
WER 低于 30% 的时候,错误主要是词级别的替换错误(比如听错了某个词)。
WER 超过 30% 之后,错误性质完全变了——大量句子被整段丢弃(empty output),或者产生跟原文毫无关联的幻觉内容,这是句子级别的语义失败。
普通的 WER 奖励函数对这两种错误的激励方式是一样的,这就导致在困难样本上奖励信号几乎失效。
DG-WGPO 的解决方案是双粒度动态奖励:
•词级细化奖励:针对 WER 较低的情况,用编辑距离相似度区分"软错误"和"硬错误",对接近正确的词给更多分。 •句子级重建奖励:针对 WER 较高的情况,用 LCS(最长公共子序列)来衡量语义骨干是否保留,同时惩罚输出过长或过短。
两种奖励根据当前样本的 WER 动态切换权重:
WER < 30% → 词级奖励权重 0.75,句级 0.25
WER ≥ 30% → 句级奖励权重 0.75,词级 0.25
(这个设计逻辑很直接:错得少就专注改词,错得多就先保住句子结构。)
门控阈值 τ 设在 0.3,论文做了超参数敏感性分析(Table 9)。把 τ 设到 0.5 会让性能变差,设到 0.2 和 0.4 差别不大。说明这个切换点定在 0.3 是比较关键的设计选择。
另外还有一个"反重复惩罚"(Rrep)——如果模型输出里出现了重复的 n-gram 短语,直接把这条 rollout 的奖励归零。防止模型在困难样本上学会用重复内容填充来规避 WER 惩罚。
最终奖励 = 静态 WER 奖励(0.4 权重)+ 动态双粒度奖励(0.6 权重)。
每次 RL 训练从同一个输入采样 K=12 条不同的转录假设,用组内相对优势来更新策略(这是 GRPO/DAPO 的标准做法)。温度设在 0.5,这个值是通过小规模探索性实验选出来的,在多样性和稳定性之间取了一个平衡。
这是个有意思的小设计,值得单独说一下。
Mega-ASR 在复杂噪声上训练之后,鲁棒性上去了,但干净音频上的某些能力(比如热词识别、流式识别)有一定损失。
解决方案是:训练一个轻量级的二分类器,在推理时判断当前输入是干净音频还是噪声音频,然后自动决定用 Qwen3-ASR 原始权重还是切换到 Mega-ASR 的 LoRA 增强权重。
这个路由器:
• 输入是 80 维 log-Mel 声谱图 单层 Transformer 架构,参数极少 在验证集上分类准确率超过99.5% 推理时额外开销几乎可以忽略不计(论文 Table 21 测出来比直接用 Qwen3-ASR 还快了 0.8%,误差范围内)
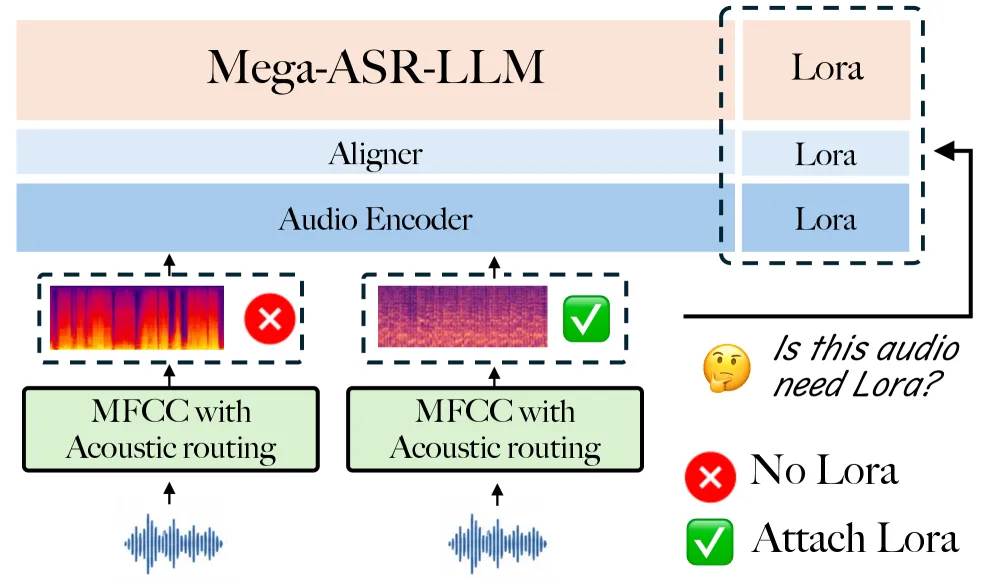
📷论文 Figure 5:环境感知路由的示意图,展示 LoRA 的动态挂载与卸载。
LoRA 权重切换是通过预计算权重差值(delta)来实现的,不需要重新加载整个模型,切换很轻。
这是个很务实的工程决策——与其让一个模型试图同时做到两头都好,不如用一个聪明的路由器来分流。
噪声鲁棒性 benchmark(论文 Table 2)
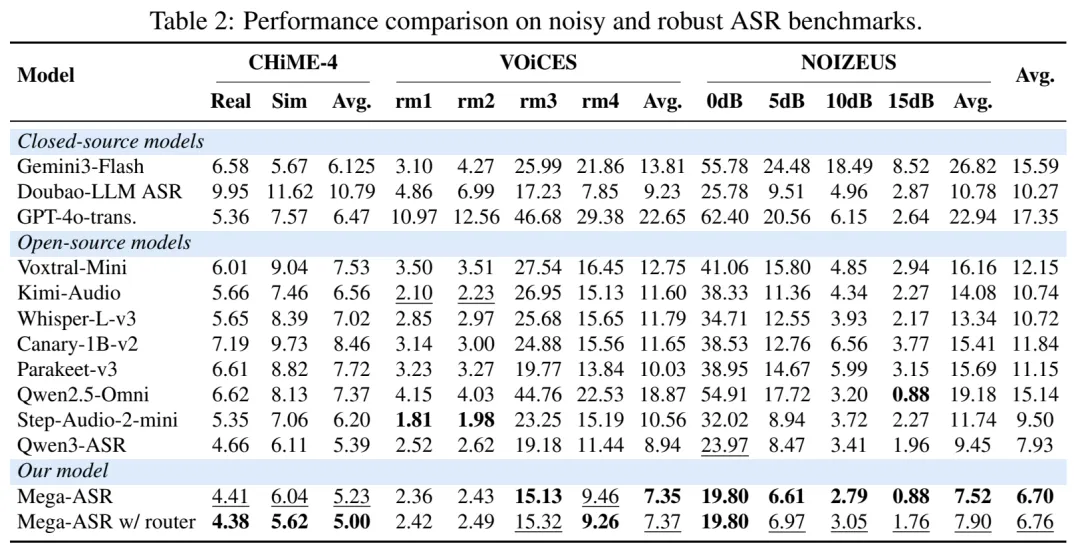
在三个经典的鲁棒性测试集上,Mega-ASR 的平均 WER 是6.70,对应 Qwen3-ASR 是7.93。
拆开看几个具体数字:
NOIZEUS 极端噪声 0dB 条件下:
• Mega-ASR: 19.80% • Qwen3-ASR: 23.97% • Gemini-3-Flash: 55.78%
这个 0dB 是什么概念——信噪比为 0,也就是背景噪声和语音信号一样响。这种条件下 Gemini-3-Flash 直接达到了 55.78%,可以说基本失效。
VOiCES R4-B-F(远场+杂音组合):
• Mega-ASR: 45.69% • Qwen3-ASR: 54.01%
这里改善幅度大一些,因为这个测试集本身场景很复杂。
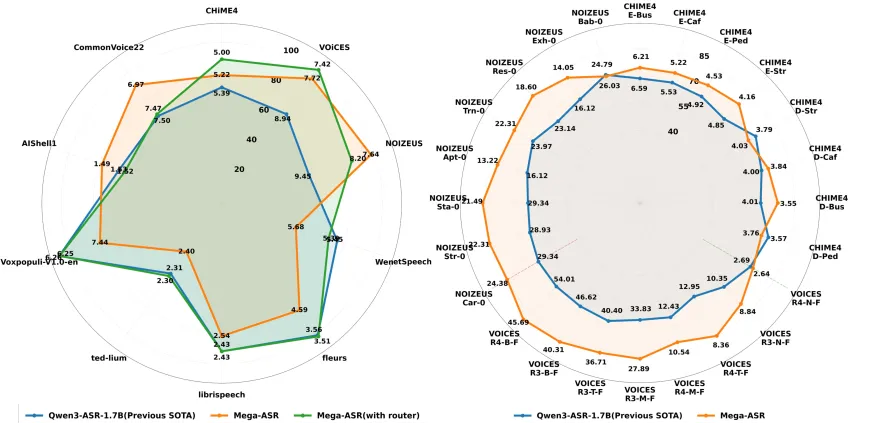
📷论文 Figure 1:Qwen3-ASR-1.7B 与 Mega-ASR 在全部测试子集上的雷达图对比,覆盖干净场景和鲁棒性场景。图片来源:论文第 1 页。
值得注意的是,Mega-ASR 在 CHiME-4(实际录音环境)上的提升相对有限(5.23 vs 5.39),因为 CHiME-4 的场景相对较轻,而且 Qwen3-ASR 本身在这里已经很强了。
这也是为什么说结果要拆开看,不能只看平均数。
干净音频标准 benchmark(论文 Table 3)
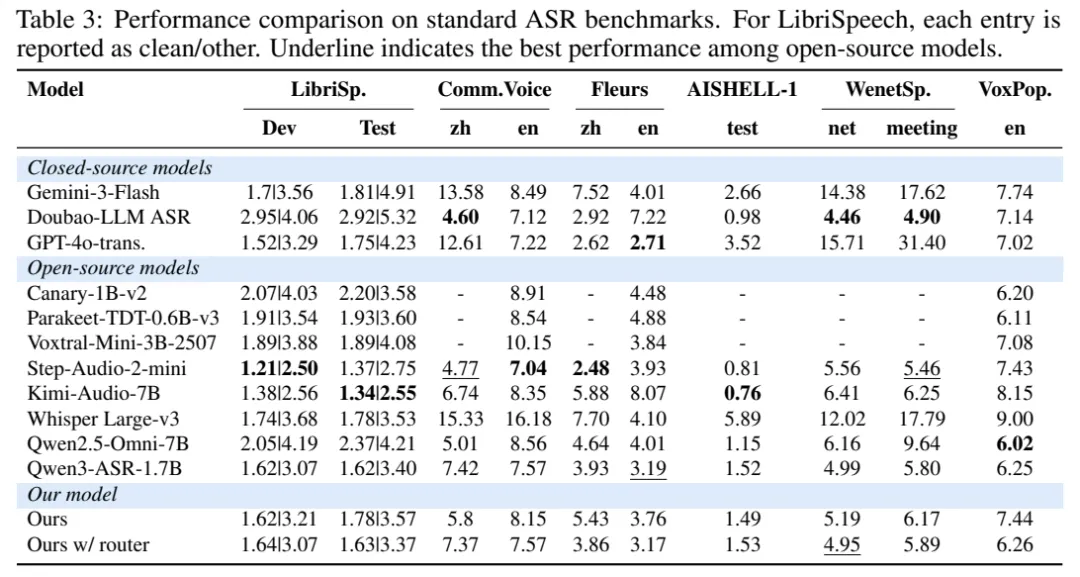
带路由器的 Mega-ASR 在干净音频 benchmark 上表现:
• LibriSpeech test-clean/other: 1.63/3.37(Qwen3-ASR: 1.62/3.40,基本持平) • Fleurs zh/en: 3.86/3.17 • AISHELL-1: 1.53(Qwen3-ASR 对应 1.52,基本持平)
干净场景下跟 Qwen3-ASR 几乎一样,说明路由器的设计确实保住了干净音频的性能没有退步。
复合场景 Voices-in-the-Wild-Bench(论文 Table 4)
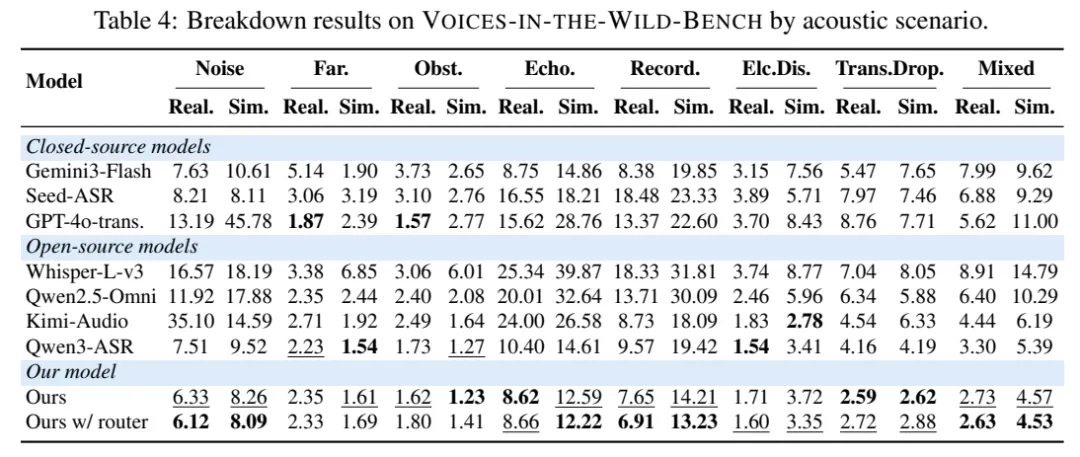
这个是 Mega-ASR 自己发布的评测集,1500 条真实录音 + 3500 条合成,覆盖 7 种声学现象。
混合干扰场景(Mixed)下:
• Mega-ASR: 2.73%(真实)/ 4.57%(合成) • Whisper Large-v3: 8.91% / 14.79% • Gemini-3-Flash: 7.99% / 9.62% • Qwen3-ASR: 3.30% / 5.39%
相对 Whisper Large-v3,真实场景降低了65.8%的相对 WER。
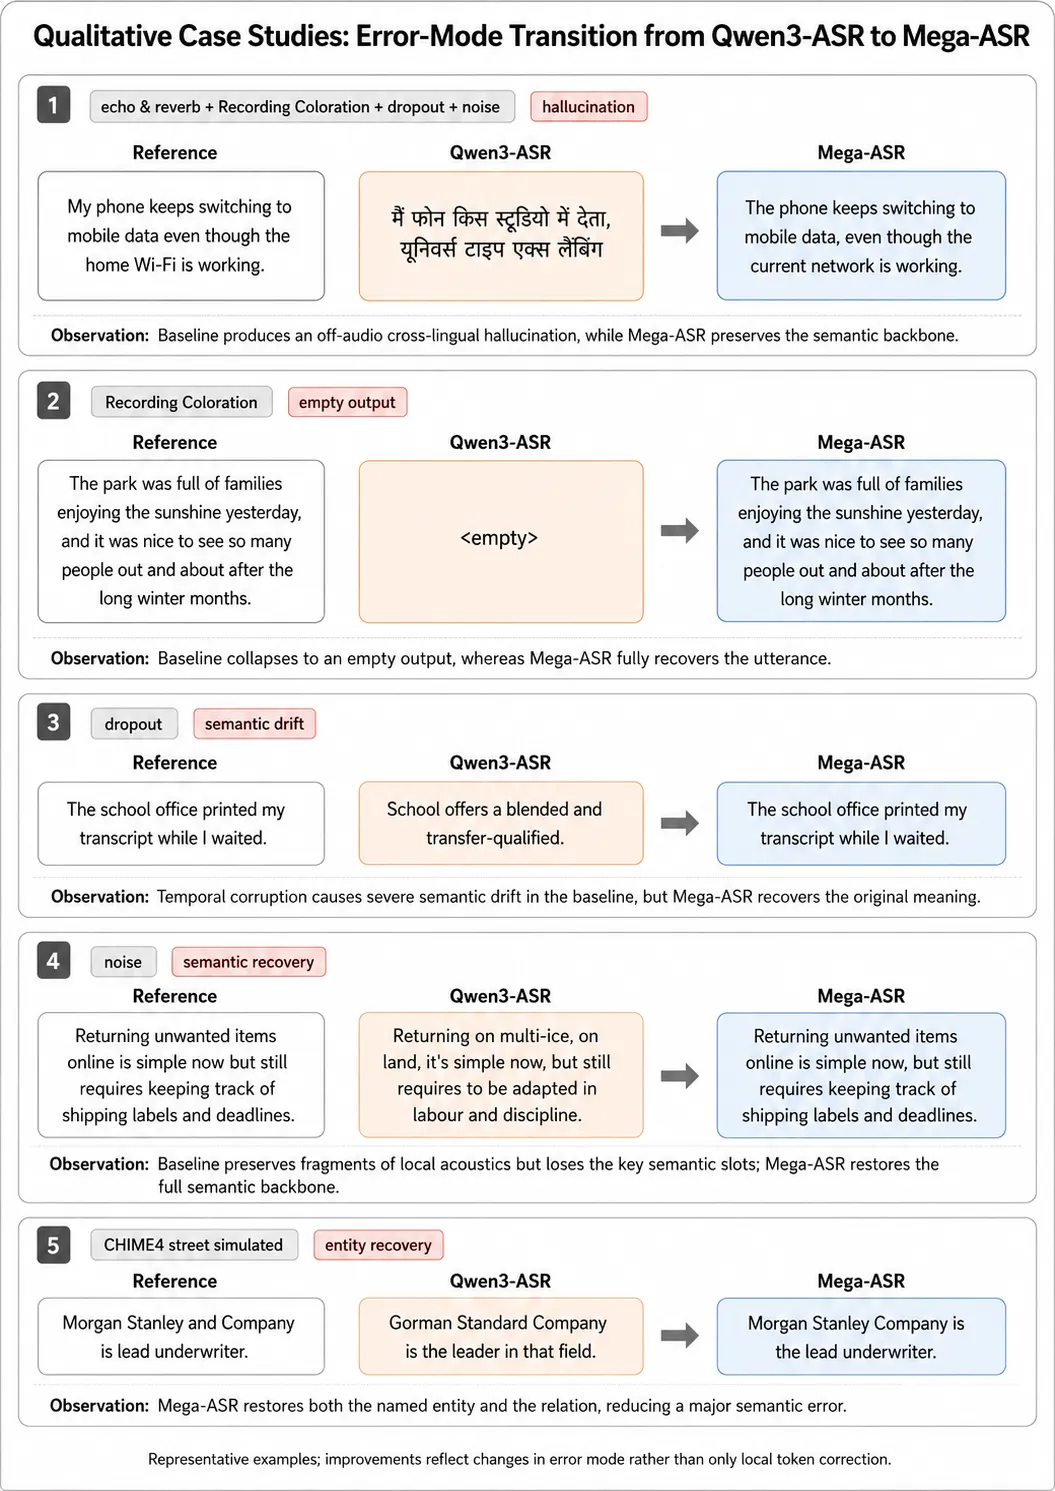
📷论文 Figure 9:从 Qwen3-ASR 到 Mega-ASR 的错误模式转变定性案例,涵盖复合声学失真、录音着色、丢帧、噪声和 CHiME-4 街道噪声五种场景。
论文 Table 5 的消融结果(在 Voices 和 NOIZEUS 上测):
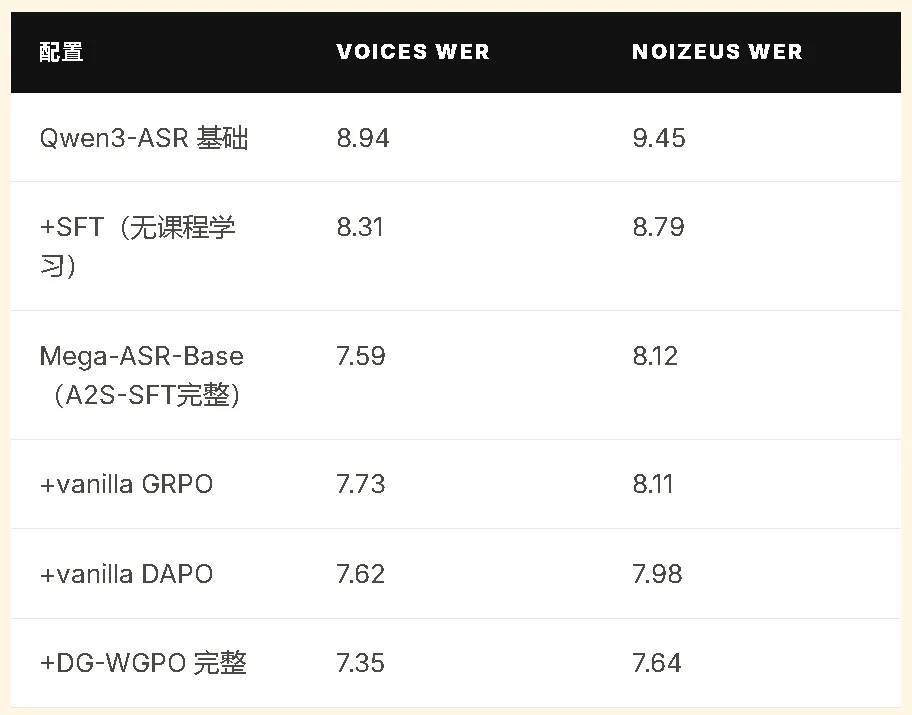
几个观察:
A2S-SFT 相比直接 SFT(无课程学习)有明显提升(7.59 vs 8.31 / 8.12 vs 8.79)——分阶段的课程学习是有效果的。
DG-WGPO 在 DAPO 基础上进一步降低,说明双粒度奖励确实带来了增益,不是凑数的。
在 DG-WGPO 各组件中,去掉"句子级重建奖励(Rstruc)"的损失最大——说明在高 WER 样本上,句子结构保留的信号比词级精度更关键。
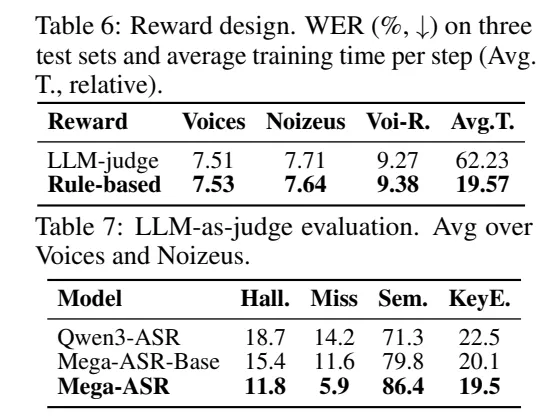
另外 Table 6 里有个工程上很实际的对比:
用 Gemini-2.5-flash-lite 做 LLM 打分奖励 vs 用规则奖励——两者 WER 差距在 0.1% 以内,但 LLM 打分每步训练耗时 62.23s,规则奖励只要 19.57s,差了3.2 倍。
所以 Mega-ASR 最终选了规则奖励。速度快、效果差不多,没必要用 LLM 评判。
论文 Figure 6 展示了三个案例,直接看数字很直观。
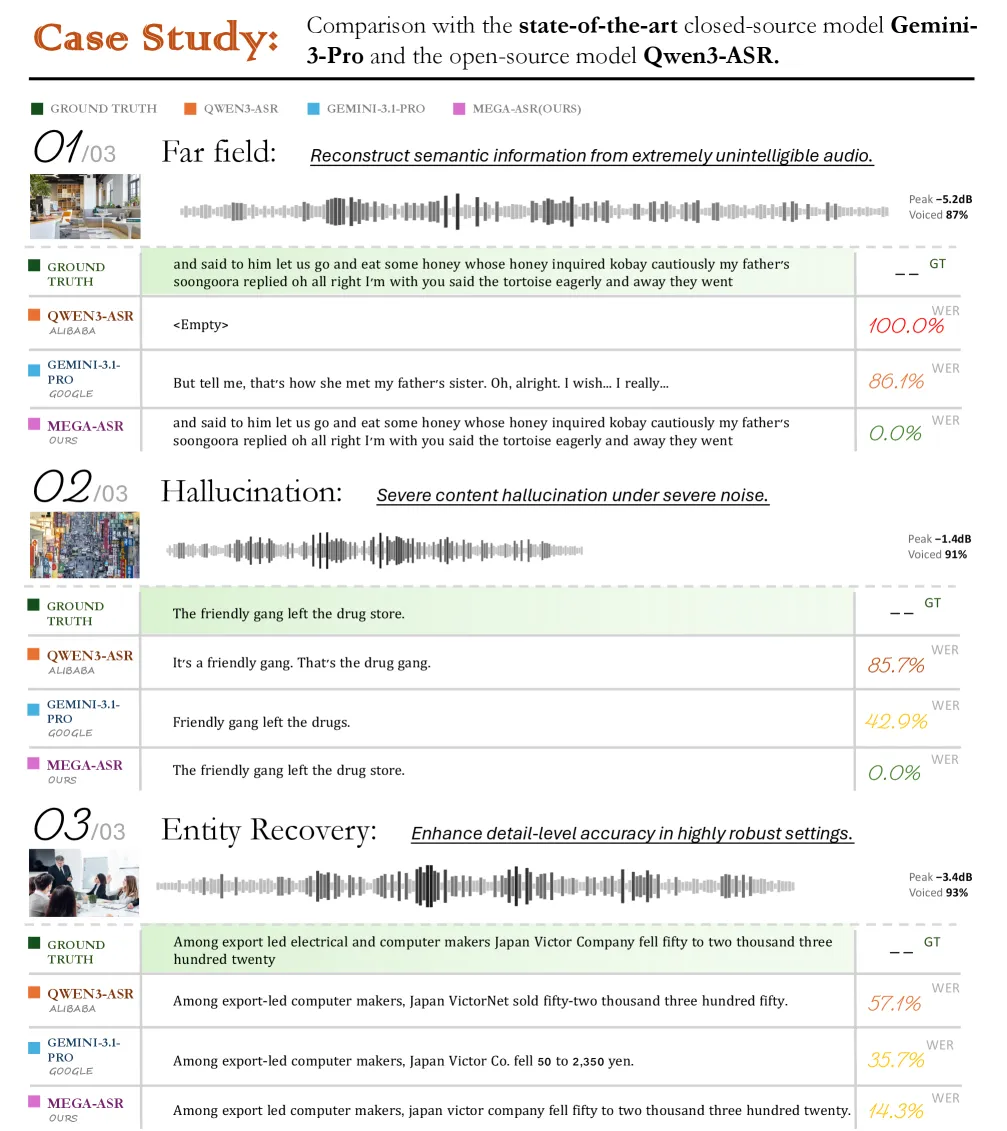
案例一:极端远场(Peak -5.2dB,只有 87% 的语音比例)
这段音频信噪比非常差,能说话的成分只有 87%,信号峰值已经是 -5.2dB 了。
• Qwen3-ASR:完全输出为空(WER 100%) • Gemini-3-Pro:输出了一段流畅但完全不相关的内容(WER 86.1%) • Mega-ASR:完整还原了原文(WER 0.0%)
案例二:严重噪声下的幻觉(Peak -1.4dB)
原文:"The friendly gang left the drug store."
• Qwen3-ASR:"It's a friendly gang. That's the drug gang."(WER 85.7%) • Gemini-3-Pro:"Friendly gang left the drugs."(WER 42.9%) • Mega-ASR:"The friendly gang left the drug store."(WER 0.0%)
案例三:实体恢复(Peak -3.4dB)
原文里有具体公司名和精确数字。
• Qwen3-ASR:把"Japan Victor Company"识别成了"Japan VictorNet",数字也错了(WER 57.1%) • Gemini-3-Pro:公司名识别不完整,货币单位搞错了(WER 35.7%) • Mega-ASR:公司名和数字都对了(WER 14.3%)
这几个 case 说明了一件事:ASR 的错误不只是把某个词听错了,在极端条件下是整段语义都崩了。Mega-ASR 改善的不只是词错误率,而是在尝试恢复语义主干。
论文 Table 7 也从语义层面做了评估:
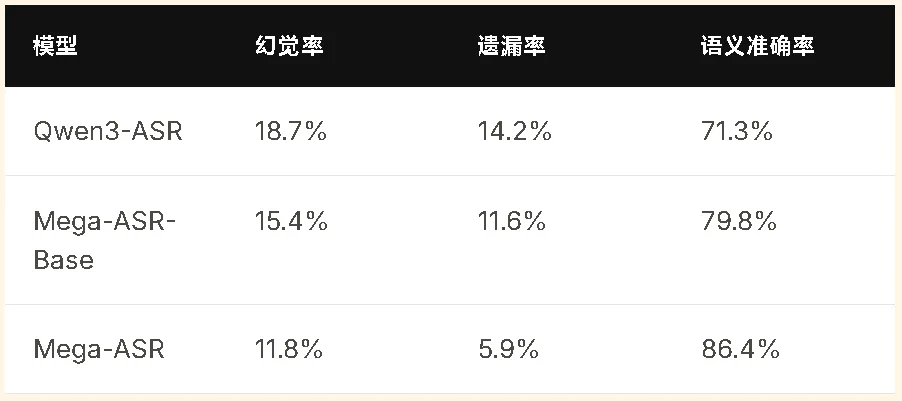
遗漏率从 14.2% 降到 5.9%,差了一大截。
模型获取
模型权重在 Hugging Face 上:https://huggingface.co/zhifeixie/Mega-ASR
数据集在:https://huggingface.co/datasets/zhifeixie/Voices-in-the-Wild-2M
代码
训练和评测代码在 GitHub:https://github.com/xzf-thu/Mega-ASR
目前 GitHub 上已经放出了 A2S-SFT 的训练代码,用torchrun启动,支持 LoRA 微调。
DG-WGPO(强化学习部分)的代码在 README 里注明"will be released in a future update",目前还没放出来。
评测使用
评测脚本也已经开放,输入是 JSONL 格式,字段只需要audio路径和answer(参考转录),输出会追加 WER/CER 结果。支持英文(WER)和中文(CER)。
硬件需求
Mega-ASR 基于 Qwen3-ASR-1.7B,模型本身是 1.7B 参数规模。
A2S-SFT 训练是在 2 张 GPU 上跑的(论文 Appendix E 里有说明),有效 batch size 为 128。
DG-WGPO 阶段用了 3 张 GPU。
推理的话,Qwen3-ASR 本身需要 6-8GB 显存,加上 LoRA 权重应该相近。
模型卡上 README 是空的,目前部署细节主要得看 GitHub 仓库和论文附录,想本地跑建议先读 Appendix D 和 E。
在介绍这个项目的同时,有几点也是值得注意的。
关于评测集
Voices-in-the-Wild-Bench 是 Mega-ASR 自己发布的评测集,训练数据(VOICES-IN-THE-WILD-2M)和评测集(Voices-in-the-Wild-Bench)的生成方式是一致的。在这个集合上 Mega-ASR 表现最好,部分原因可能是分布匹配上的优势。CHiME-4、VOiCES、NOIZEUS 这些第三方 benchmark 上的结果相对更有参考价值,而 Mega-ASR 在这些集合上的领先幅度更有说服力一些。
关于 DG-WGPO 代码
强化学习部分的代码目前还没开放,只有 SFT 部分。README 里写的是"will be released in a future update",但没给出具体时间。想完整复现 Mega-ASR 结果的,目前还做不到。数据集(VOICES-IN-THE-WILD-2M)倒是已经放到 HuggingFace 了,所以想做自己的实验还是有基础的。
关于 CHiME-4 上的表现
在 CHiME-4 的详细子集上(论文 Table 11),Mega-ASR 不是在每个子集上都比 Qwen3-ASR 好——某些 simulated 子集(比如 dt05_bus_simu:4.22 vs 3.85)反而略有退步。整体平均数是好的,但细节上有起伏,不是全面碾压。
关于干净场景的权衡
论文里提到,Mega-ASR 不带路由器时,在部分干净场景 benchmark 上确实有退步,带了路由器之后才基本持平。路由器是一个额外的工程组件,在实际部署中需要一起维护。不过路由器本身很轻量,这个代价可以接受。
关于基准参照
Mega-ASR 是在 Qwen3-ASR-1.7B 上微调来的,性能比较的基线也是 Qwen3-ASR。如果跟规模更大的模型比(比如更大参数的音频语言模型),结论可能不一样,论文里并没有拿更大的模型做对比。另外论文发布于 2026 年 5 月,后续这个领域肯定会有新的工作跟进,当前的数字会动。
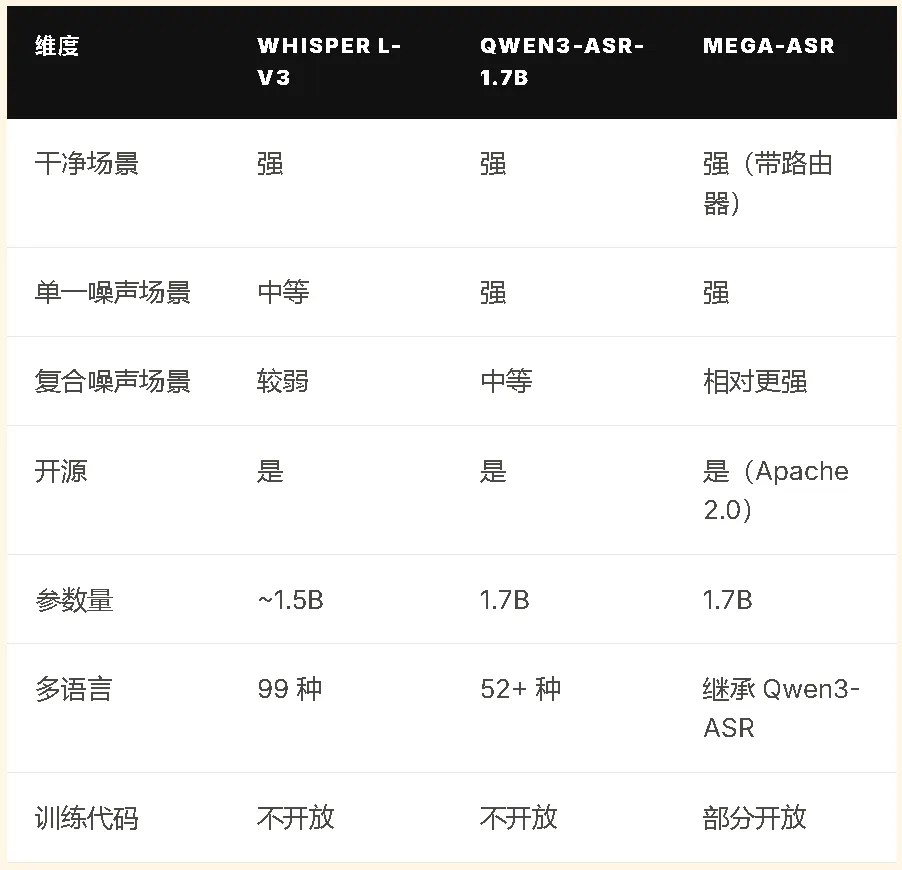
Mega-ASR 解决的是一个真实存在、但在 benchmark 里容易被忽略的问题:当声学条件足够复杂,错误就不再是词级别的,而是整段语义的崩塌。
它的核心贡献有三块:
一是 VOICES-IN-THE-WILD-2M 这个 2.4M 规模、54 种复合场景的数据集——这是一个独立有价值的开源资源,不管你用不用 Mega-ASR 的模型,这个数据集都值得关注。
二是 A2S-SFT 的分阶段训练策略——把声学适应和语义推理分开训练再联合对齐,在高 WER 场景下有明显效果。
三是 DG-WGPO 的双粒度奖励——针对 WER 超过 30% 之后奖励信号饱和的问题,提供了一个有一定创意的工程解法。
整体来看,这是一篇工程导向明显的工作,想法不复杂,但实现细节很扎实。在复合噪声场景下的改善是真实的,在干净场景下的能力保留也是完整的。
值得跟踪,尤其是 DG-WGPO 代码放出来之后。
论文:Mega-ASR: Towards In-the-wild² Speech Recognition via Scaling Up Real-world Acoustic Simulation,arXiv:2605.19833,2026 年 5 月 19 日发布。
