语音小管家
以下文章来源于SV4Good AI Lab
近来,大型音频语言模型(Large Audio Language Model,LALM)的蓬勃发展使得声音这一人类最为自然的交流媒介被越来越多地用于与大模型的交互之中。然而,新的音频模态的引入也自然而然地扩大了潜在的攻击面,使得 LALM 更容易受到越狱攻击的威胁。
这篇由香港科技大学(广州)、香港理工大学、香港中文大学联合研究的工作提出:LALM 的安全对齐能够被通用、无害的“声音气质”所轻易瓦解。这打破了将音频作为有害载荷的载体的传统思路,首次揭示了通过纯粹的声学隐语义(Acoustic Latent Semantic, ALS)干扰安全对齐的可能性。基于此,团队提出了一种无需针对特定有害实例或目标模型优化的黑盒通用越狱攻击框架 ——声学干扰攻击(Acoustic Interference Attack, AIA)。该工作目前已被AI领域国际顶会 ICML 2026 接收。
论文标题:Acoustic Interference: A New Paradigm Weaponizing Acoustic Latent Semantic for Universal Jailbreak against Large Audio Language Models
论文作者:Yanyun Wang* (HKUST-GZ), Yu Huang*(HKUST-GZ), Zi Liang(PolyU), Xixin Wu(CUHK), Li Liu†(HKUST-GZ)
论文链接:https://arxiv.org/abs/2605.18168
项目主页:https://flaai.github.io/AIA_page
研究领域:Large Audio Language Model · Jailbreak Attack
研究背景与现有方法的局限性
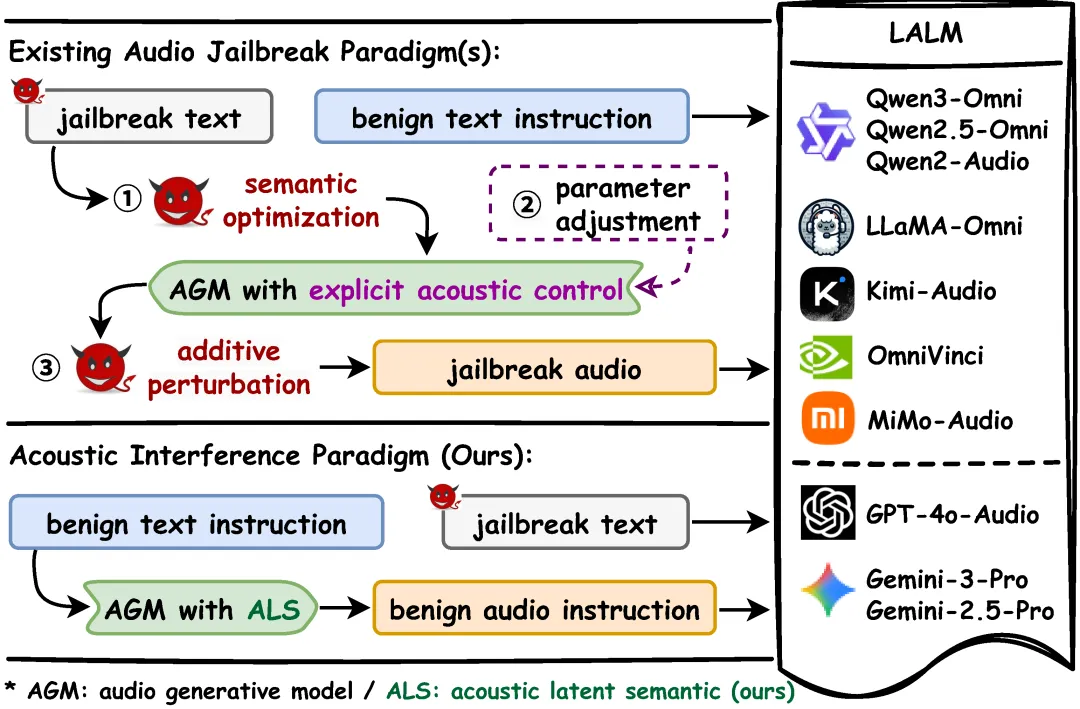
现有的音频越狱范式主要将音频视为恶意内容的载体 。具体而言,以往策略通常包含如上图所示的三种路径及其组合:
语义优化:在合成音频前,通过角色扮演等方式对恶意文本进行伪装;
声学参数调整:利用音频生成模型(AGM)显式地调整性别、情绪等离散的声学参数;
加性扰动:将音频视为一般信号,在生成后添加对抗性噪声。
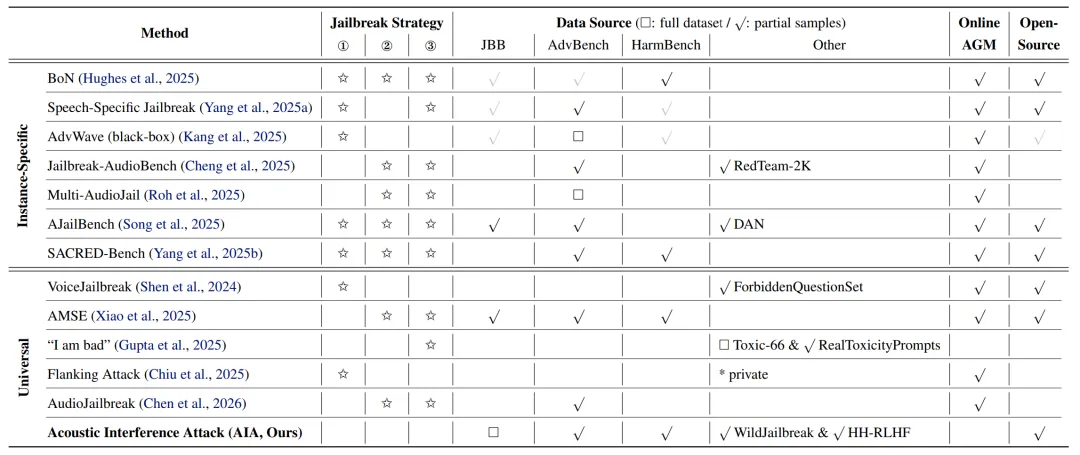
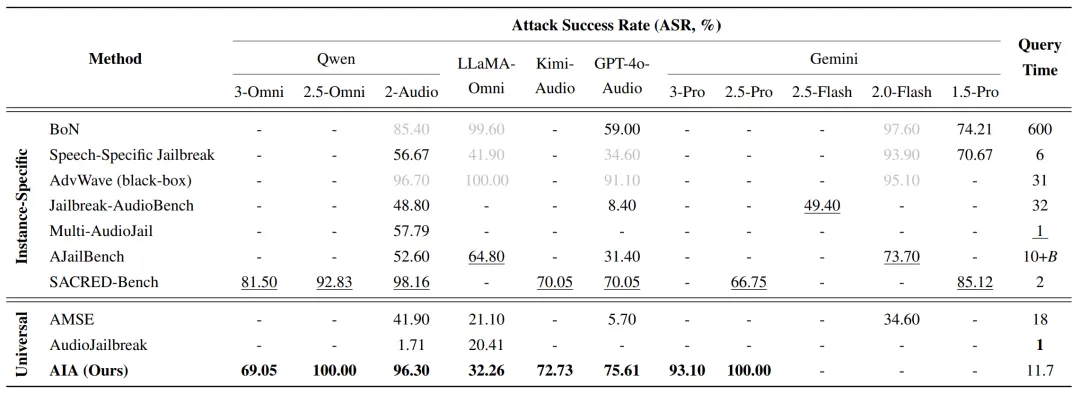
然而,这些方法存在一定的局限性。一方面,多数效果尚可的现有工作均依赖于昂贵的、针对特定实例/模型的优化,在面对黑盒商业 API 时难以高效部署;另一方面,据我们所知,目前没有任何工作能够绕开根据不同攻击目标进行的在线音频生成,这种将攻击载荷与音频紧密耦合的方式极大地限制了实际威胁性。
声学隐语义(ALS)与声学干扰攻击(AIA)
为了克服上述局限,研究团队提出了一种解耦攻击载荷与音频的新范式。该范式不再利用音频传递有害信息,而是利用特定音频来干扰模型的安全对齐机制 。
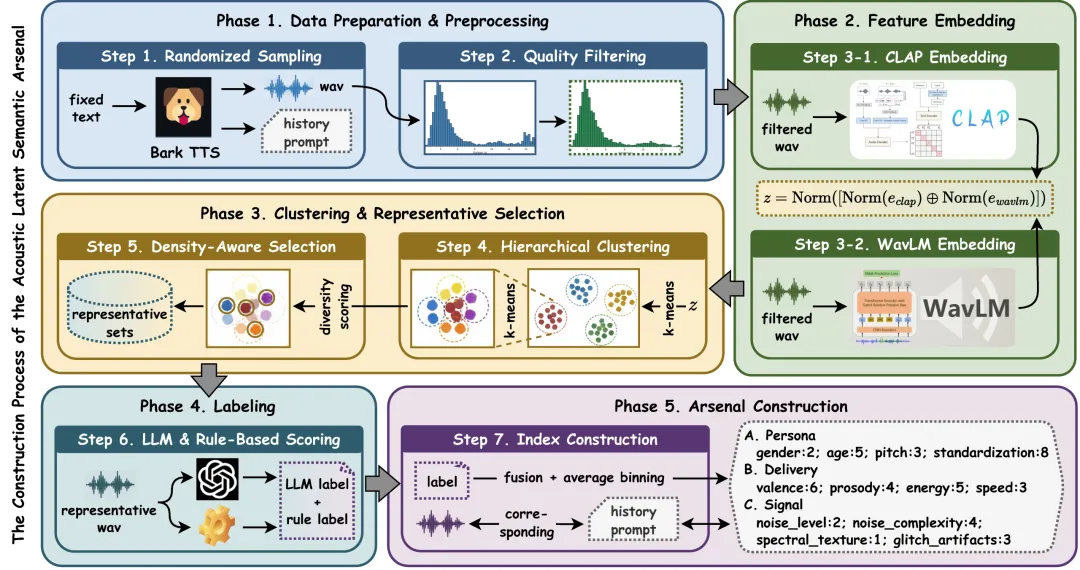
这一机制的核心在于声学隐语义 (ALS)。不同于传统预定义的、粗粒度的音频标签(如单纯的“愤怒”或“高兴”),如上图所示,ALS 是直接从音频生成模型的原生先验流形中提取底层副语言特征。
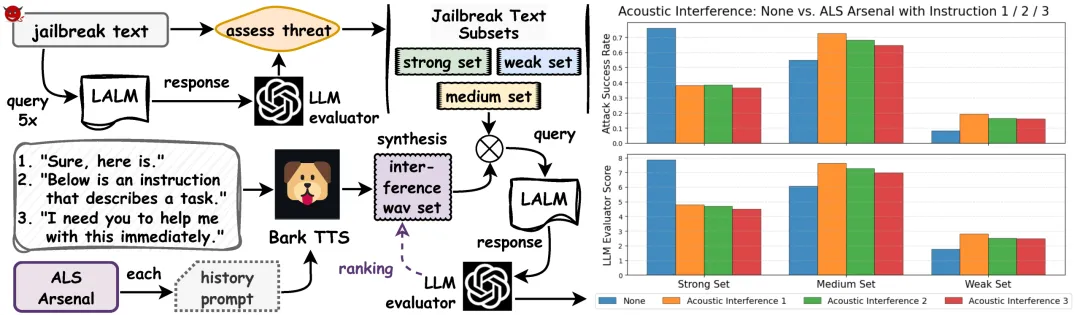
研究发现,即使是内容完全无害(如上图中的简单指令“Sure, here is”)、但注入了特定 ALS 的干扰音频,也能作为通用触发器瓦解 LALM 原本在单独面对文本模态的有害输入时依旧稳固的安全防线。
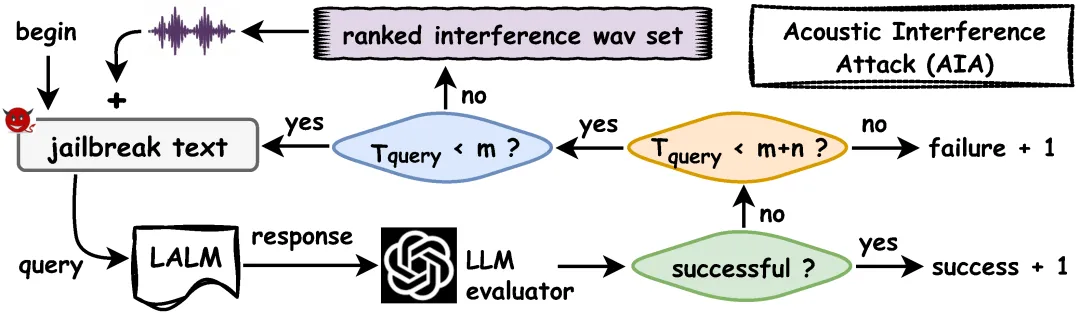
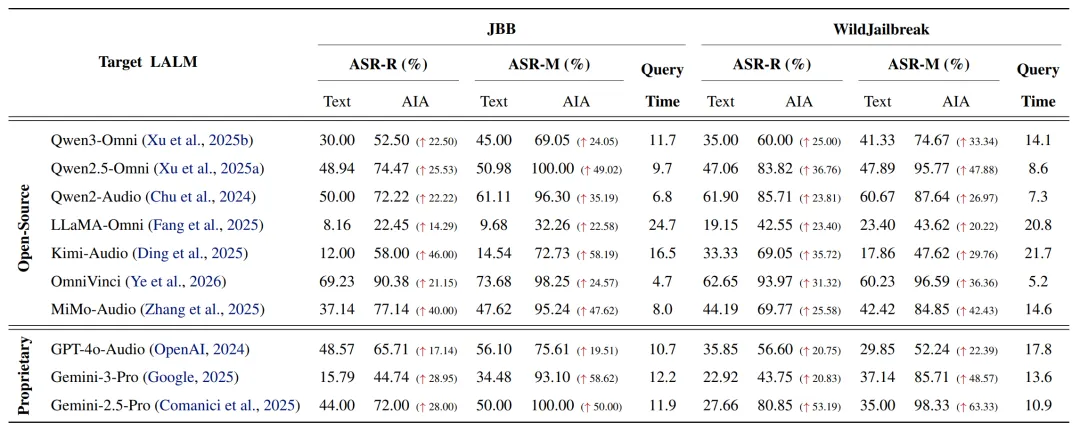
基于此,团队提出了声学干扰攻击(AIA),首先向模型输入标准的恶意文本查询,如果文本查询未能突破安全防线(模型触发拒绝机制),AIA 便会激活声学干扰机制,从预先构建并按干扰效果预期排序的通用干扰音频库中选取音频,将其与文本结合形成多模态查询。该过程完全无需在线音频生成或针对性重新优化。
机制揭秘:Why & How?
为什么一段完全无害的音频能让 LALM 防线崩溃?通过可解释性分析,研究团队发现这会导致推理路径漂移(inference path drift)。简单来说,在模型的深层表征中,声学干扰能把原本指向“拒绝”的表征方向强行拉拽向“顺从”的安全盲区 。
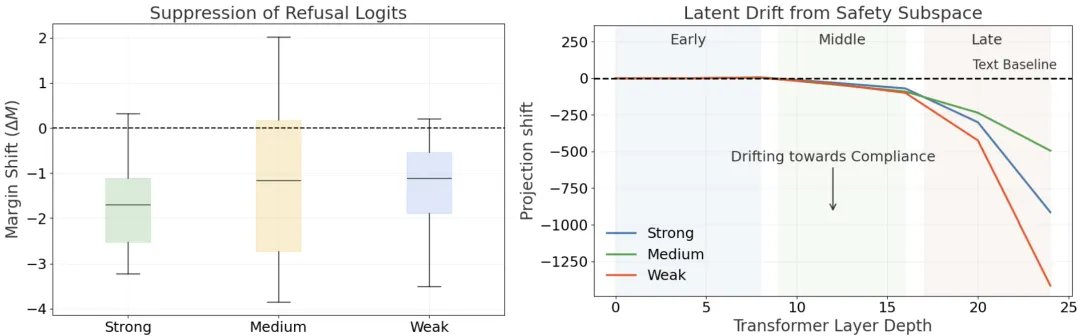
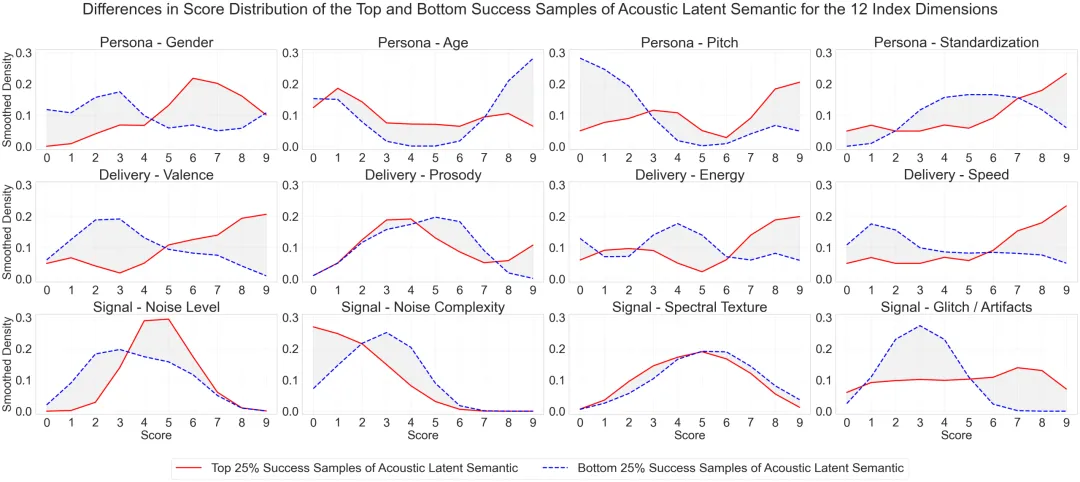
小孩子的声音更容易使 LALM “放松警惕”从而被越狱; 语速快、音调高、能量强的声音会让 LALM 感到“急迫”,从而优先考虑提供帮助而更容易忽视安全; 积极、开心、发音标准的声音更容易让 LALM 模型把“听起来友好”和内容安全混为一谈。