
 语音小管家
以下文章来源 微软亚洲研究院
微软亚洲研究院推出了一个面向文本生成音视频任务的多粒度、细粒度、任务驱动评测基准AVGen-近日,微软亚洲研究院推出了一个面向文本生成音视频任务的多粒度、细粒度、任务驱动评测基准AVGen-Bench。它关注的不只是“模型能不能生成”,更可以回答“模型到底强在哪里,又弱在哪里”。相关论文已被ICML 2026接收。
论文链接:https://arxiv.org/abs/2604.08540
GitHub链接:https://github.com/microsoft/AVGen-Bench
现有基准(benchmark)的主要局限,在于它们大多停留在对生成结果粗粒度质量的评估上。这类评测通常关注画面清晰度、音频自然度,或局部片段的可感知质量,然而在真实应用场景中,用户需求往往是涉及多维度、强约束、跨时间的综合生成任务。例如,广告生成要求模型同时控制视觉呈现、旁白内容、节奏编排与品牌语义;新闻生成要求模型协调语音信息、镜头逻辑与叙事结构;乐器教学要求动作展示与音高节奏严格对应;实验模拟则要求生成结果不仅表面合理,还必须符合现实规律与基本常识。
因此,真实应用所需要的并非仅是“好看”或“好听”的生成能力,而是面向复杂任务的综合建模能力,包括语义遵循、音视频协同、时序一致性以及现实一致性。相应地,benchmark 也需要从粗粒度质量评估,进一步扩展到细粒度能力评判。例如文本渲染是否准确、语音是否真实可信、角色特征是否跨时间保持一致,以及多模态内容是否在语义和时序上严格对齐。
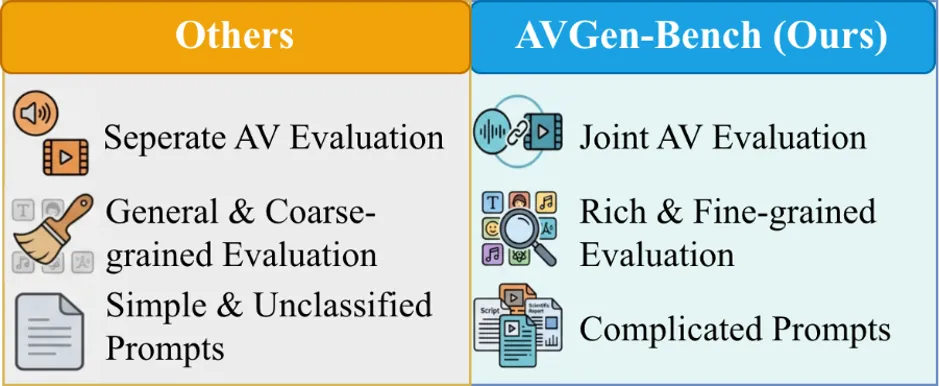
图1:AVGen-Bench 与现有 benchmark 的对比。AVGen-Bench更强调联合音视频评测、细粒度维度与高复杂度任务型提示词。
现有音视频生成评测,往往只回答一个问题:生成结果“看起来/听起来怎么样”。但真实应用更关心的是“模型到底有没有做对”。因此,AVGen-Bench不同于只追求单一总分的评测方式,从更贴近真实场景的角度,系统拆解模型能力:既评估视觉与音频本身的生成效果,也评估关注音画同步、口型匹配等基础跨模态一致性,更重点关注模型的细粒度语义可控性,包括文本渲染是否准确、人脸是否前后一致、音乐音高是否正确、语音是否清晰连贯,以及生成内容在低层和高层物理层面是否合理、整体语义是否一致。
整体而言,AVGen-Bench 提供了 10 个核心评测维度,希望推动社区从“一个总分衡量一切”走向“面向能力诊断的系统评测”。
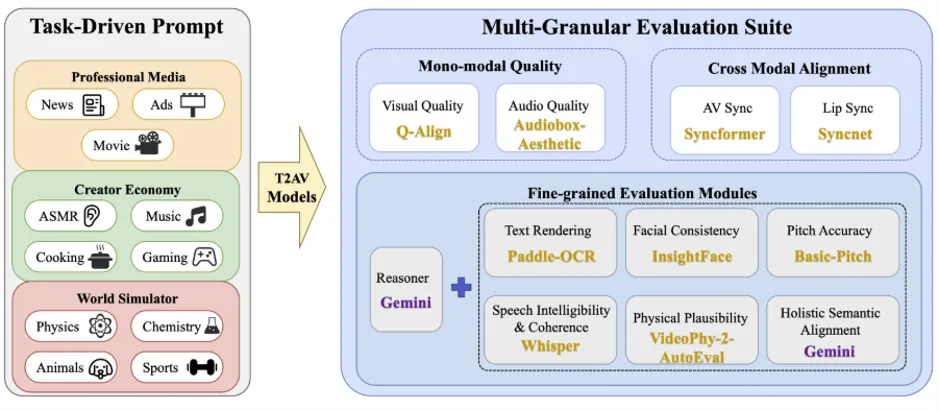
图2:AVGen-Bench 框架。左侧是任务驱动 prompt 体系,右侧是多粒度评测模块。
在方法设计上,AVGen-Bench 有两个核心出发点:Prompt (提示词)要来自真实任务,评测要能够定位具体能力缺陷。
首先,在 prompt 构建上,研究员们并没有采用“为了适配已有指标而反向设计题目”的方式,而是从真实使用场景出发,先定义用户会提出什么样的任务,再构建对应的测试样本。研究员们将整个 prompt 体系组织为三大任务域:专业媒体制作(professional media)、创作者内容生产(creator economy) 和世界模拟(world simulation)。其中,专业媒体制作覆盖广告、电影预告片等场景,强调多镜头叙事、品牌表达、节奏控制与文案呈现;创作者内容生产覆盖 ASMR、烹饪教程、游戏实况、乐器教学等场景,强调动作、语音、音乐与视觉内容之间的精细配合;世界模拟则覆盖物理、化学、体育、动物等任务,重点考察模型是否具备对现实规律、因果关系与常识知识的基本理解。
为了保证 prompt 的复杂度和多样性,研究员们采用了 “大模型生成 + 人工严格筛选” 的流程:先利用 GPT 生成候选任务,再由人工从复杂性、清晰度、真实性和可评测性几个维度进行审核与修订。最终得到的 prompt 不再只是简单的“一个主体 + 一个动作”,而是更接近真实用户需求的复合型指令,平均 token 长度显著高于现有 benchmark,且包含更多跨模态约束、多事件过程和多镜头结构。
尤其重要的是,AVGen-Bench有意保留了许多现实任务中的“隐含要求”,例如实验结果是否符合物理规律、背景文字是否自然合理、新闻播报中的语音与镜头是否相互支撑。这些往往正是生成模型最容易出错、却也是传统 benchmark 最少覆盖的部分。
在评测方法上,AVGen-Bench 采用了一套多粒度、混合式(hybrid)评测框架。研究员们的核心判断是:单一总分无法真正反映 T2AV 模型的能力边界,因为一个模型可能画面很好、声音也不错,但文本渲染一塌糊涂;也可能音画同步不错,却无法执行复杂的语义控制。
因此,AVGen-Bench将评测拆解为三个层次:
第一层是基础单模态质量,分别评估视频画面的感知质量和音频本身的听感质量,回答“生成结果是否好看、好听”。
第二层是基础跨模态一致性,关注音画是否同步、说话时口型是否匹配,回答“声音和画面是否真的属于同一个事件”。
第三层则是最关键的细粒度语义可控性,用于判断模型是否真正完成了用户指定任务。
在具体实现方面,AVGen-Bench 并不依赖某一个“万能模型”去完成全部评测,而是采用 specialist model(专家模型) + MLLM 协同的思路:用轻量但专业的工具负责底层、可验证的信号提取,再用多模态大模型完成高层语义判断与综合审查。例如,在文本渲染评测中,系统先通过 OCR 从视频中提取文字,再由多模态模型判断这些文字是否与 prompt 中要求一致、是否在场景语境下自然合理。这样的设计能够兼顾两类需求:一方面避免纯嵌入(embedding)相似度指标“看起来相关但抓不住错误”的问题,另一方面也可以避免完全依赖人工标注带来的高成本与低扩展性。
从这个意义来说,AVGen-Bench 想做的并不是再增加一个新的“排行榜”,而是尝试提出一种更具诊断性的评测方法论。其核心目标是将那些模型经常出错、但长期难以系统衡量的能力缺口——例如,文本渲染常常是生成模型的薄弱环节,但传统 benchmark 很少对其进行专门评估——转化为可量化、可比较的评测指标,从而帮助研究者在看到模型“整体表现如何”的同时,更进一步定位它究竟差在哪里、为什么会失败、还有哪些能力尚未真正建立起来。
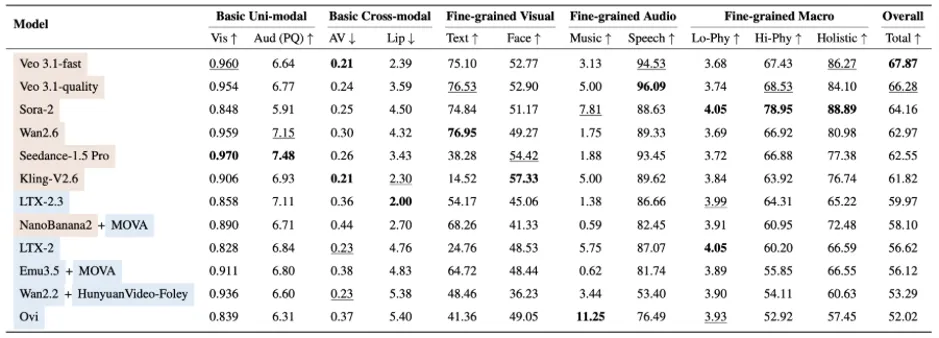
图3:现有T2AV模型在AVGen-Bench上的表现。
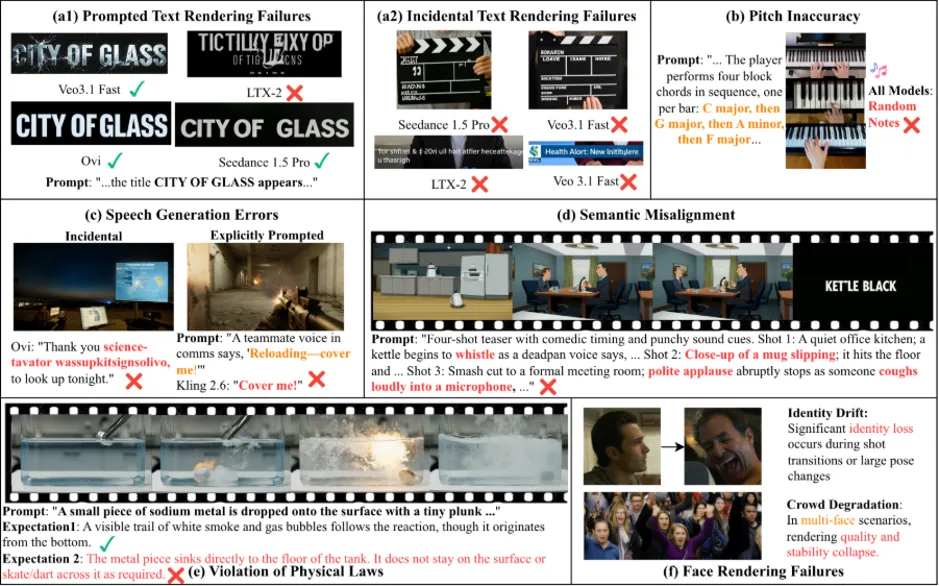
图4:AVGen-Bench上的表现AVGen-Bench 所覆盖的典型细粒度失败案例。图中展示了当前文本生成音视频模型在多个关键维度上的常见问题,包括显式文本渲染错误、场景中偶发文本乱码、音乐音高控制失败、语音生成错误、复杂多镜头任务中的整体语义失配、违背现实规律的物理现象,以及角色一致性不足等。这些问题通常难以通过传统粗粒度质量指标充分反映,但却会显著影响模型在真实应用场景中的可用性与可靠性。
随着文本生成音视频模型持续进步,评测体系本身也需要同步升级。我们不仅需要知道模型是否能生成“好看、好听”的内容,更需要知道它是否真正理解任务、执行约束,并在复杂场景下保持正确、协调与可信。
AVGen-Bench 希望为这一方向提供一个更系统、更细致的评测起点,也希望推动社区从“生成效果展示”进一步走向“能力边界诊断”。如果你对文本生成音视频的评测问题感兴趣,欢迎关注 AVGen-Bench 项目,与我们一起探索下一代多模态生成系统真正需要具备的能力。
