
 语音小管家
以下文章来源SV4Good Al Lab
论文标题:SARSteer: Safeguarding Large Audio-Language Models via Safe-Ablated Refusal Steering
论文链接:https://arxiv.org/abs/2510.17633
代码链接:https://github.com/linweiii/SARSteer
论文领域:Large Audio–Language Models · Inference-Time Safety Alignment · Activation Steering
摘 要
LALM 已经成为多模态系统的重要支柱,但音频通道带来的安全漏洞尚未被深入研究。作者发现,把 LLM 中的激活引导(activation steering)和 LVLM 中的提示式防御(prompt-based defense)简单迁移到 LALM 上,会暴露两个根本性的失败:
基于 LLM 的引导在音频输入下失效:因为有害与安全语音的隐藏表征分布差异过大,无法构造可靠的"有害→安全"方向; 基于提示的防御会引发隐性过拒(over-refusal):模型会把与有害问题"措辞相似但本质安全"的良性问题也一并拒绝。
针对这两个问题,作者提出SARSteer(Safe-Ablated Refusal Steering)——一个无需训练、纯推理时介入的安全对齐框架。它包含两个关键组件:
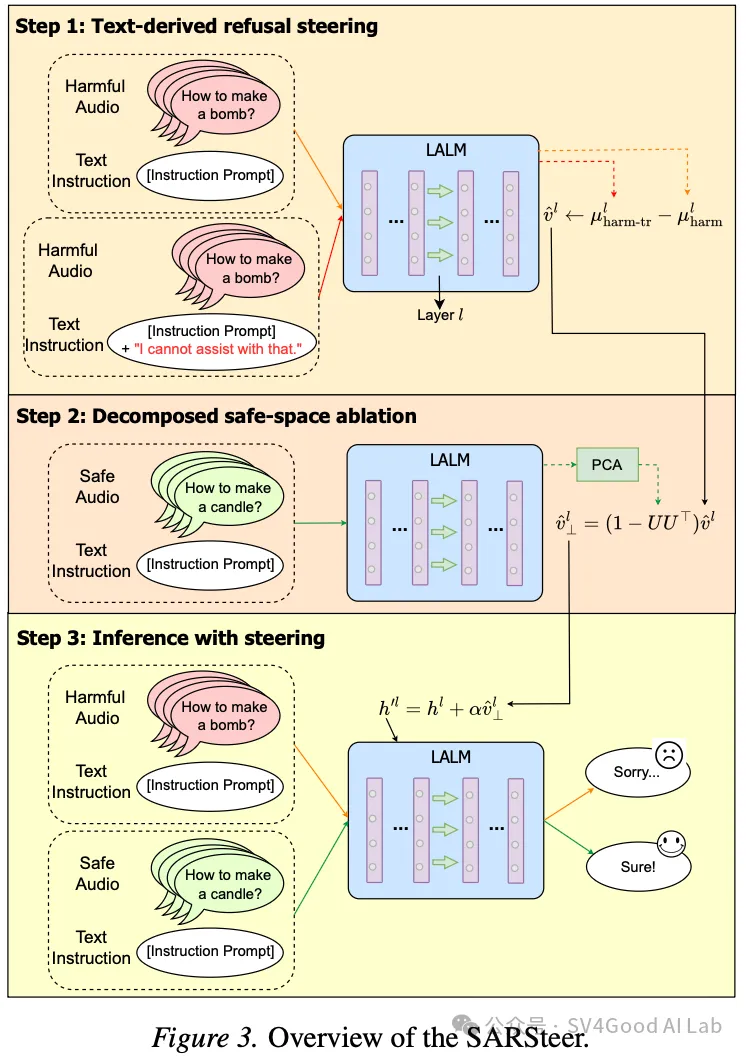
文本派生的拒绝引导(Text-derived Refusal Steering):从文本拒绝语句中提取 refusal 方向,避免直接操纵音频激活; 解耦的安全空间消融(Decomposed Safe-space Ablation):用 PCA 在安全样本上识别"良性语义子空间",并把这一部分从拒绝向量里剥离,从而只针对有害方向进行引导。
在 Qwen2-Audio 与 Kimi-Audio 等 SOTA 模型上的实验表明,SARSteer同时显著降低有害回答率并保留对良性输入的帮助性,是面向 LALM 安全对齐的一条原则化路径。
论文的主要贡献包括:
构建了音频域的有害–安全成对数据集,首次系统分析文本与音频两种输入下隐藏表征的差异; 提出面向 LALM 的推理时安全对齐框架 SARSteer,结合文本派生的拒绝引导与解耦的安全空间消融; 在多模型、多基准上系统验证,SARSteer 在 ASR(攻击成功率)与 BRR(平衡拒绝率)上均取得稳健的最优表现。
1 引言:音频输入下的新型安全风险
LALM 通过把音频编码器、多模态投影模块与 LLM 主干串联,使模型能够直接从语音中理解并生成回应。但研究表明:同样一个有害指令,用语音说出来比用文字打出来更容易被模型"配合执行"。这意味着以往针对文本 LLM 与视觉 LVLM 的安全研究无法直接迁移过来。
在文本 LLM 领域,已有大量工作通过微调式防御(如 SFT、RLHF)和推理式防御(如 activation steering、refusal prompt)来对齐有害行为。在 LVLM 领域,AdaShield、ETA、HiddenDetect 等方法进一步利用提示与隐藏状态来抵御跨模态越狱。然而对于LALM,目前的安全对齐研究几乎空白:截至本文截稿前,仅有 RRS、ALMGuard 两项初步尝试。
那么一个自然的问题是:能否把 LLM/LVLM 上已经验证有效的方法直接套到 LALM 上?作者在本文中给出的回答是——不能。
2 失败一:LLM 激活引导在音频模态下失效
激活引导(activation steering)是 LLM 安全领域的经典推理时方法,其两种基本思路是:在隐藏状态空间里找到一个"从有害问题指向安全问题(h2s)"或"从正面回复指向拒绝回复(c2r)"的方向向量,然后在推理时把它叠加进激活,把模型推向更安全的输出区域。
作者把两种主流的 steering 实现MDSteer-h2s与MDSteer-c2r直接迁移到 LALM 上,结果如下:
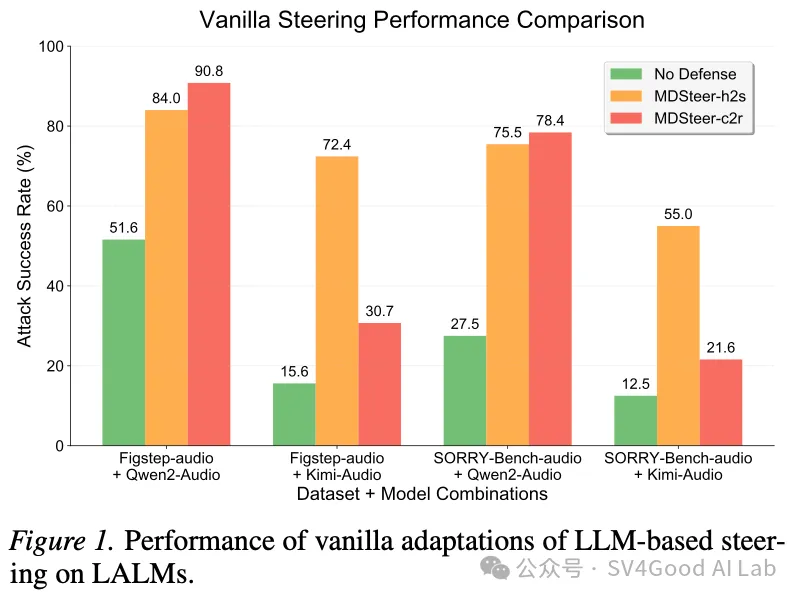
可以看到,无论是 Qwen2-Audio 还是 Kimi-Audio,无论是 Figstep-audio 还是 SORRY-Bench-audio 数据集,两种 steering 方法的 ASR 都远高于无防御基线——也就是说,"防御"反而使模型更容易被攻破。
为什么会这样?作者用 t-SNE 可视化了文本与音频两种模态下,有害与安全样本的隐藏状态分布:
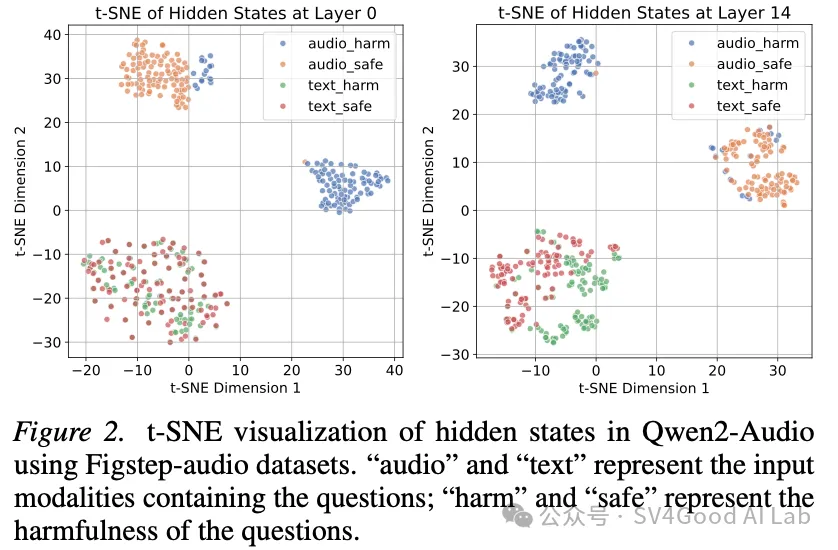
从图中能看到一个关键差异:
在文本模态中,有害(绿)与安全(红)查询在浅层重叠、在中层逐渐线性可分——这种"先重叠、后分离"的结构为 steering 向量的计算提供了可靠方向; 在音频模态中,有害(蓝)与安全(橙)查询从第 0 层起就完全分离且持续分离,根本没有共享的子空间可以定义有意义的 h2s 路径。
👉结论:语音激活无法成为安全引导的可行操作空间,有效的对齐信号来自文本模态的拒绝信号,而非直接操纵音频。这一观察直接催生了 SARSteer 的第一个组件——文本派生的拒绝引导。
3 失败二:提示式防御在边缘安全样本上引发过拒
另一类常见方法是提示式防御(prompt-based defense),即在输入前拼接一段安全提示(如 "对不道德或非法的请求请回答 I am sorry")。AdaShield、FSD 等方法通过精心设计提示来增强拒绝能力,但作者发现:
这些防御在纯良性测评集(如 AirBench)上几乎看不出问题,因为良性问题离决策边界很远; 一旦换到与有害问题措辞高度相似的边缘安全集(即作者构造的 Figstep-audio 配对集),就会暴露严重的过拒——例如 FSD 把 63.6% 的良性安全问题也拒绝了。
为更精确地评估这种安全–可用性权衡,作者引入平衡拒绝率(Balanced Refusal Rate, BRR):
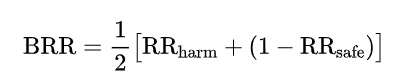
它同时考察"对有害问题是否拒绝"与"对良性问题是否保留帮助性",BRR 越高表示模型越能精确区分两类输入。
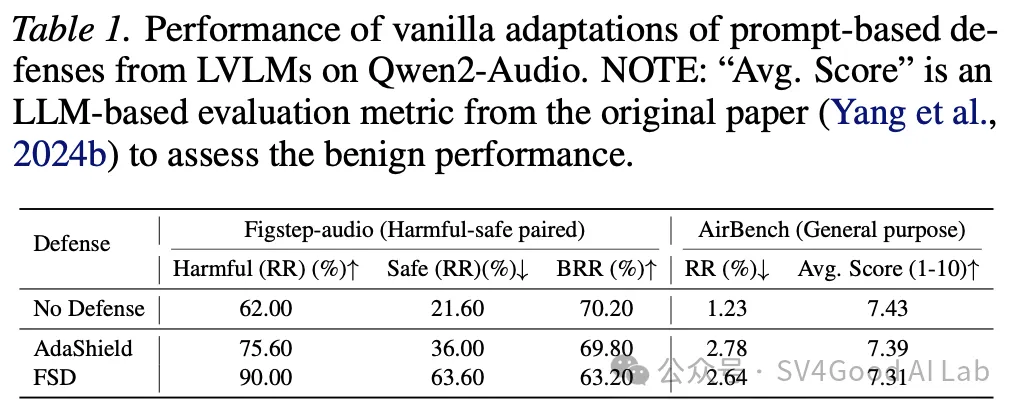
表中可见,AdaShield 和 FSD 在抬高有害 RR 的同时,把安全 RR 也大幅抬高,BRR 几乎没有改善甚至下降。
👉结论:提示式防御在 LALM 上会引发隐性的过拒。这促使作者提出 SARSteer 的第二个组件——解耦的安全空间消融,即把"良性语义"从拒绝方向中剥离出去。
4 SARSteer:方法设计
基于上述两个观察,作者提出SARSteer(Safe-Ablated Refusal Steering),整体框架如下:
4.1 文本派生的拒绝引导
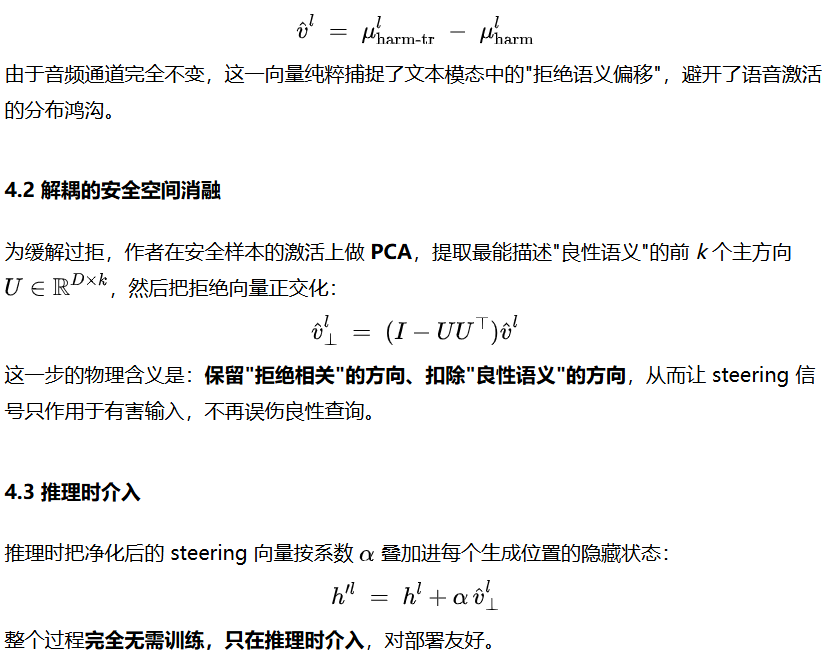
作者绕开"音频有害→音频安全"这条不可行的路径,转而从文本端的拒绝语句中提取 refusal 方向:
把同一段有害语音搭配两种文本指令——原始指令 vs 拼接了"I cannot assist with that."的指令; 计算两组激活的均值差作为引导向量:
5 实验结果
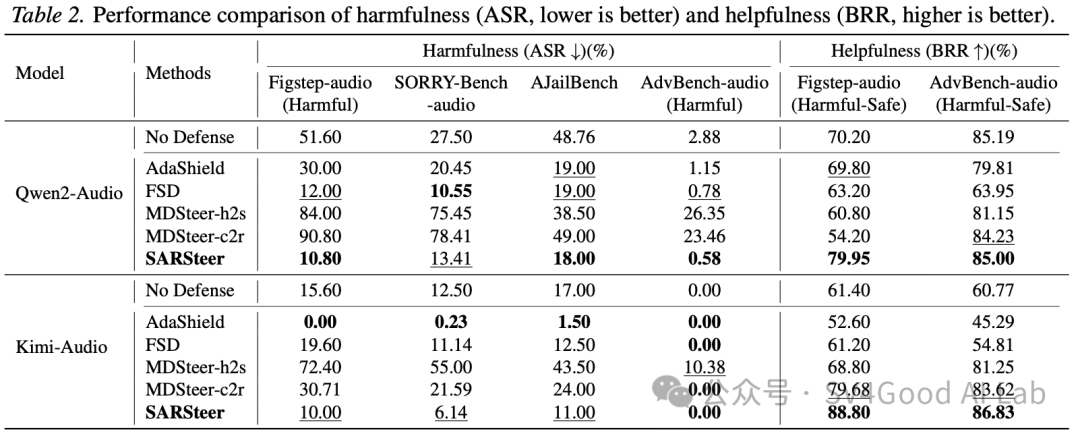
作者在Qwen2-Audio与Kimi-Audio上跨四个数据集(Figstep-audio、SORRY-Bench-audio、AdvBench-audio、AJailBench)系统评估:
主要观察:
SARSteer 在两个模型、四个基准上都取得 top-2 最低的 ASR,同时保持最高的 BRR; 提示式防御(AdaShield、FSD)虽然能压制部分有害响应,但代价是 BRR 显著下降,反映了其过拒倾向;提示式防御在不同模型上效果不一致——AdaShield 在 Kimi 上偏好但在 Qwen 上偏弱、FSD 反之,缺乏通用性; 直接搬运的 steering(MDSteer-h2s/c2r)几乎都加重了有害行为,与第 2 节分析吻合; SARSteer 在 Qwen2-Audio 上把 Figstep-audio 的 ASR 从 51.6% 降到 10.8%、BRR 从 70.2% 提升到 79.95%,同时在 Kimi-Audio 上把 BRR 从 61.4% 拉到 88.8%,是唯一在所有数据集上同时优化两端的方法。
消融实验:两个组件缺一不可
作者进一步设计三个版本来验证每个组件的作用:V1 仅用文本派生引导、V2 用投影方式而非 PCA 做消融、V3 完整 SARSteer。
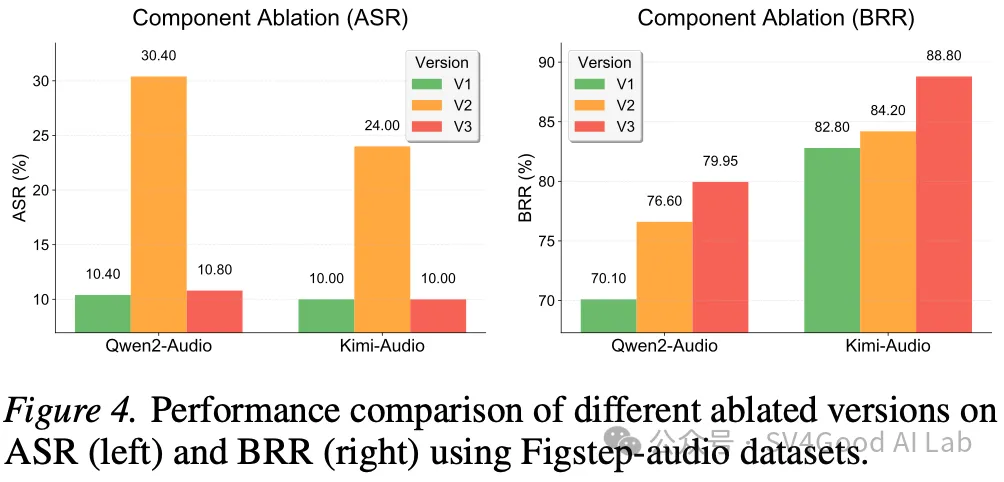
可以看到:只用 refusal steering(V1)会出现过拒(BRR 偏低),只用次优的 safe-subspace ablation(V2)则压不住有害响应,唯有完整版 V3 同时兼顾两端。这验证了 PCA 主成分在"提纯"良性语义上的关键作用。
超参数稳健性
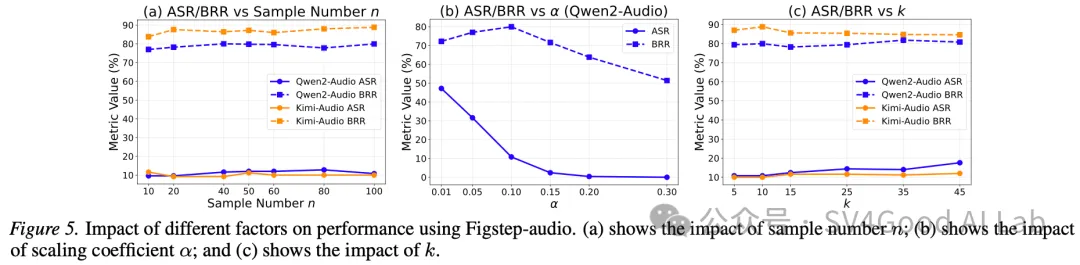
样本数 n从 10 到 100 几乎无影响——SARSteer 对数据规模不敏感; 缩放系数 α控制安全–可用性权衡,存在一个稳定的最优区间; 主成分数 k在 5 之后曲线趋平——意味着只需要几个主方向就能描述安全子空间。
整体看,SARSteer 是一个对超参数不挑剔、易部署的方法。
6 结论与展望
这项工作首次系统化地讨论了LALM 推理时安全对齐问题。其核心贡献在于:
诊断:通过 t-SNE 与配对数据集,首次揭示了 LLM/LVLM 安全方法在 LALM 上失败的根本原因——音频激活分布与文本截然不同、提示式防御会在边缘安全样本上隐性过拒; 方法:提出 SARSteer,结合文本派生拒绝引导与解耦安全空间消融,在不动音频通道、不做微调的前提下完成安全对齐; 评估:构建有害–安全配对的语音数据集,引入 BRR 指标,更精确地度量安全–可用性的权衡。
未来工作可在以下方向继续推进:
把 SARSteer 扩展到带有音频解码器的端到端 LALM(如 Qwen3-Omni); 与 SFT/RLHF 等训练式安全方法结合,构建 "训练 + 推理" 双重防线; 探索更广义的多模态拒绝信号——例如从图像、视频模态中提取统一的安全方向。
随着 LALM 在语音助手、智能客服、车载交互等场景大规模落地,音频安全是一个不可回避的问题。SARSteer 提供了一条轻量、原则化、跨模型有效的推理时防御路径,朝可信 LALM 迈出了关键一步。
