
 语音小管家
标题:《TTS-PRISM: A Perceptual Reasoning and Interpretable Speech Model for
Fine-Grained Diagnosis》
链接:https://arxiv.org/pdf/2604.22225
作者单位:清华大学、小米 MiLM Plus、东京大学
发表日期:2026 年 4 月 24 日
开源地址:https://github.com/xiaomi-research/tts-prism
值得参考的点
12 维分层评价体系:将传统的单一 MOS 分数拆解为 12 个互补维度,分为基础能力层(8 维,1-5 分)和高级表现力层(4 维,0-2 分加分),每个分值都有明确的声学容忍度锚定,消除主观模糊性。 对抗性负样本构造:针对长尾缺陷样本设计了包含韵律扰动、发音退化、一致性破坏等多种对抗性扰动的数据合成管线,消解了现有数据集普遍存在的正样本偏置问题。 Schema-Driven 指令微调:将评分标准直接嵌入指令模板,强制模型先生成基于标准的推理理由再给出分数,以此作为逻辑正则化手段抑制幻觉,单次推理即可完成 12 维诊断。 系统画像与诊断标签:将 12 维评分聚合为直觉性的诊断标签(如 "Stable but Flat" "Highly Expressive" ),为不同 TTS 架构提供了超越标量排名的行为特征描述。
背 景
随着大规模生成式 TTS 系统逼近人类水平,传统 MOS 评价暴露出 "黑箱" 困境:单一标量无法区分发音、韵律、情感等不同维度的能力差异,更无法定位导致感知崩塌的具体声学缺陷。已有的改进方向可分为两类:一是全局标量与偏好驱动的方法,虽能捕捉整体自然度,但句级聚合稀释了对局部声学缺陷的敏感度;二是多维度评分加文本解释的方法,虽然提升了可解释性,但评价维度多偏向高层感知(如艺术表现),忽略了细粒度声学细节和语言特有的语音学问题(如中文声调连读变调、多音字消歧),且缺乏显式评分标准,导致生成的理由流于模板化。
TTS-PRISM 正是为了填补这一空白而提出:建立一个面向中文的、具有明确量化标准的细粒度多维诊断框架。
核心方法
12 维分层评价体系
TTS-PRISM 构建了一个跨 5 个核心域、12 个子维度的层次化分类体系。
基础能力层(Basic Capability Layer,1-5 分)包含 4 个域共 8 个子维度,评估合成语音的正确性与稳定性:
音频清晰度(Audio Clarity):评估物理信号质量,识别背景噪声、电子失真等。例如 4 分定义为存在均匀分布的平稳底噪(如轻微高斯白噪声),2 分则对应存在频繁爆音和金属伪影的破坏性信号失真。 发音准确度(Pronunciation Accuracy):超越 ASR 指标,聚焦于中文特有的细粒度异常,包括不完整发音、鼻边音混淆(n/l)、声调连读变调错误、多音字消歧失败等。 韵律准确度(Prosody Accuracy):下辖语调(Intonation)、停顿(Pauses)和语速(Speech Rate)三个子维度。 一致性(Consistency):监测单条语音内的说话人身份、风格和情感类别一致性,下辖 Speaker Consistency、Style Consistency 和 Emotion Consistency 三个子维度。
高级表现力层(Advanced Expressiveness Layer,0-2 分加分)包含 4 个子维度,捕捉高性能模型的类人表现力特征:
重音(Stress):评估通过音高或响度实现的关键词强调。2 分要求显著的能量集中或音高偏移。 拖音(Lengthening):检测短语边界或强调位置是否出现自然的音节延长。 副语言(Paralinguistics):检测笑声、叹息、呼吸、咳嗽等非言语线索。 情感表达(Emotion Expression):评估语音对文本内含情感的表现完整度和强度。
每个维度的每个分值等级都锚定到了明确的容忍度阈值,例如定义了 4 分允许的具体伪影类型,将主观评估映射为可操作的量化标准。
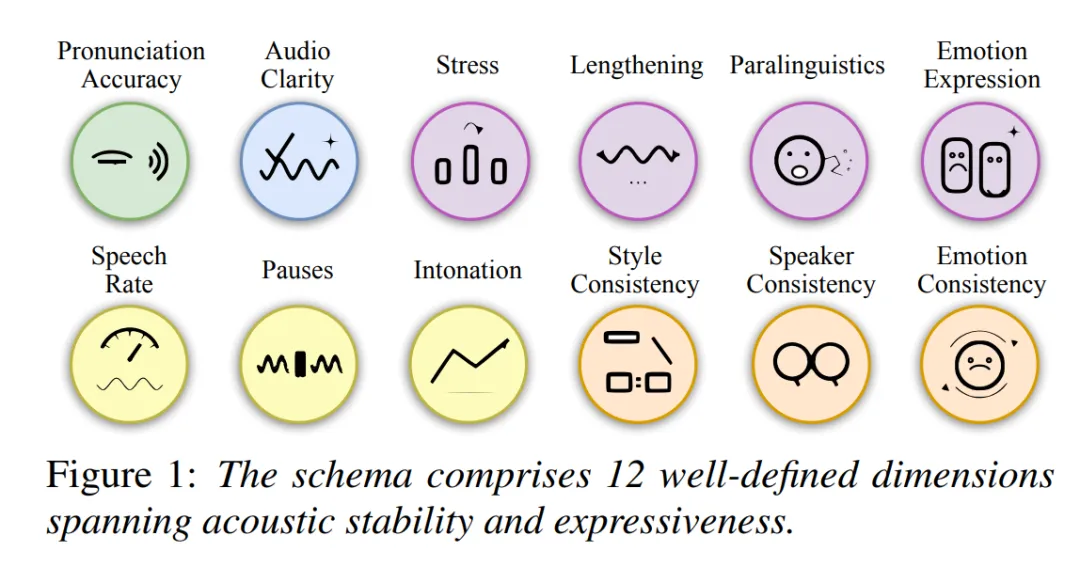
题注内容:12 维评价体系总览,涵盖声学稳定性到高级表现力的完整维度
靶向数据构造
现有语音质量评估数据集大多以英文为主,且存在正样本偏置,模糊了细粒度决策边界。TTS-PRISM 因此构建了覆盖全质量尺度的合成管线。
正样本侧:以领先的 TTS 系统和高保真人声录音建立参考锚点。NVSpeech 和 FireRedTTS-2 定义了副语言和情感表达的上限;对于当前生成模型仍较困难的重音和拖音维度,则使用内部专业录音作为金标准锚点。
负样本侧:引入韵律与节奏扰动、发音与音频质量退化、一致性破坏等多类对抗性扰动。同时整合了 Intelligibility Preference Speech Dataset 的扰动子集,增强对中文同音字和亚音素级错误的敏感度。
标注流程:使用 Gemini-2.5-Pro 将评估分解为 12 个独立的维度级任务,避免长上下文指令漂移和幻觉。对重音和拖音维度进行了人工指导的理由修正。针对中文声调连读变调和多音字问题,构建了11k条专家标注的 "发音金标准子集" 注入语言学知识。最终产出20 万条对齐样本。
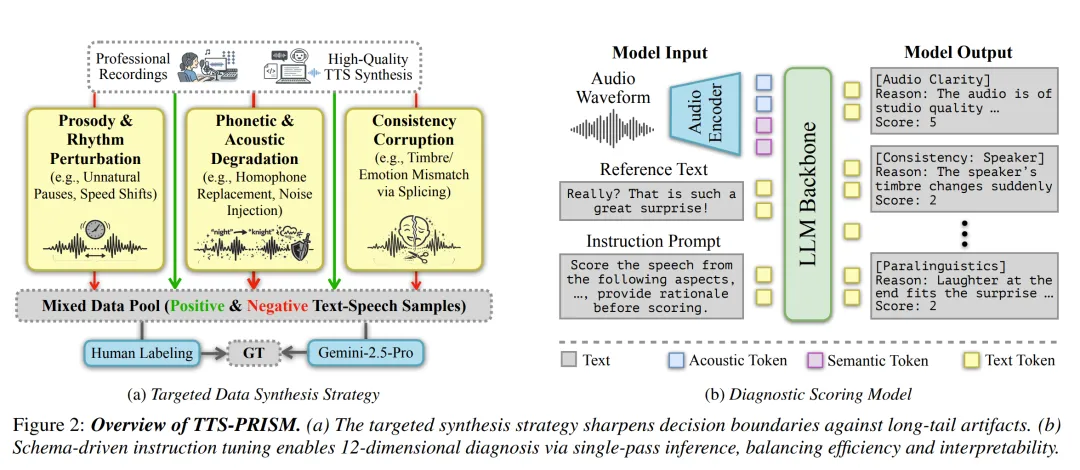
题注内容:TTS-PRISM 整体框架,(a) 靶向数据合成策略,(b) 诊断评分模型的 Schema-Driven 指令微调
诊断评分模型
TTS-PRISM 选择 MiMo-Audio 作为骨干模型,利用其1 亿小时无监督预训练获得的鲁棒声学表征。在此基础上实施 Schema-Driven 指令微调策略。
最终模型通过单次推理即可完成全部 12 个维度的诊断,而基线方法需要进行 12 次独立推理。
数据情况
训练数据集包含20 万条中文样本,涵盖多种来源:
TTS 合成来源:CosyVoice2 占43.2%,IndexTTS2 占13.5%,F5-TTS 占9.1%,MaskGCT 占9.0%,VoxCPM 占9.0%,FireRedTTS-2 占9.0%,MiMo-Audio 占7.2%。 文本域分布:对话文本(Chat)占37.5%,文学(Literature)占20.0%,小说(Fiction)占12.8%,其他(Other)占11.8%,表现力文本(Expressive)占10.9%,新闻(News)占7.0%。 特殊子集:11k 条专家标注的发音金标准子集,专门针对中文声调连读变调和多音字。
评估使用分层抽样的1,600条中文金标准测试集,严格与训练数据不重叠,其中20%为分布外(OOD)样本(未见过的 TTS 系统和真人录音),所有标签经专家共识标注验证。
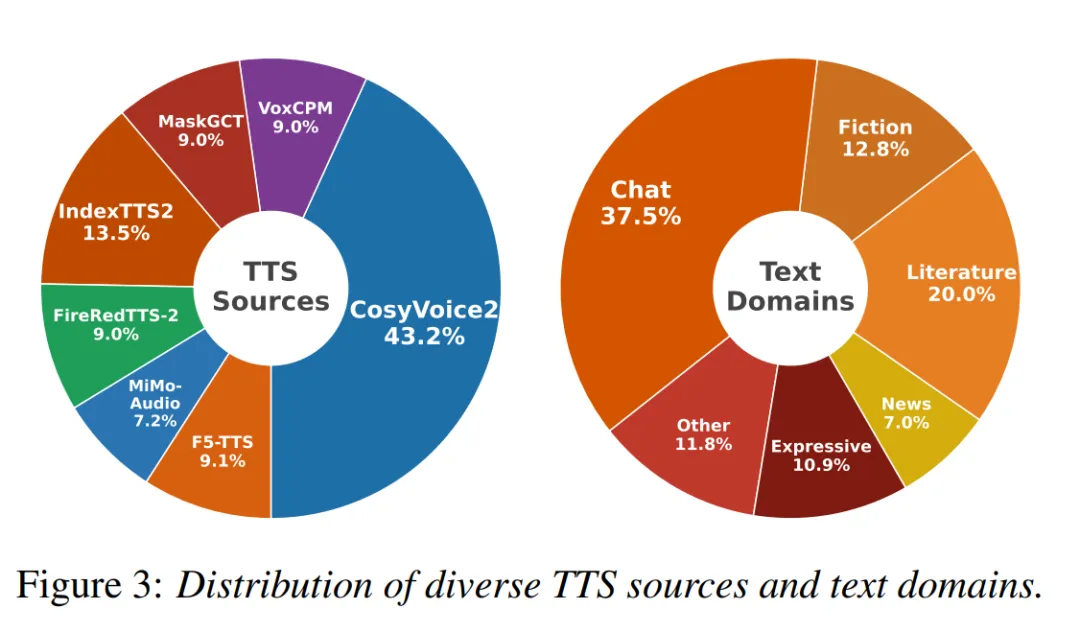
题注内容:训练数据中 TTS 来源和文本域的分布情况
实验与结果
实验设置
训练采用对 MiMo-Audio(7B参数)的全参数监督微调,优化器为 AdamW,batch size 为 1,固定学习率 1e-6。
基线模型包括三个定义了音频推理前沿的系统:Step-Audio-R1(33B,推理增强范式)、Qwen3-Omni(30B,通用多模态 MoE 架构)以及闭源的 Gemini-2.5-Pro。为最大化基线性能,对基线采用了维度级独立推理策略(12 次推理),而 TTS-PRISM 仅需单次推理。
评价指标包括线性相关系数(LCC)、Spearman 秩相关系数(SRCC)和均方误差(MSE),以及用于验证可解释推理机制的理由支持一致性(RSC)。
精细化准确度
在 1,600 条金标准测试集上,TTS-PRISM(7B)在多数维度上取得了最优的人类对齐表现。在 Audio Clarity 维度,LCC 达到0.815,SRCC 达到0.826;在 Emotion Expression 维度,LCC 达到0.841,SRCC 达到0.838;在 Style Consistency 维度,LCC 达到0.789,SRCC 达到0.785。
Pronunciation Accuracy 是 TTS-PRISM 唯一落后于 Gemini-2.5-Pro 的维度(LCC0.511vs.0.613)。论文分析认为,ASR 预训练的音频模型优化的是容错的多对一映射,与 TTS-PRISM 严格的缺陷鉴别目标存在根本性冲突,这种预训练偏置难以通过微调消除。
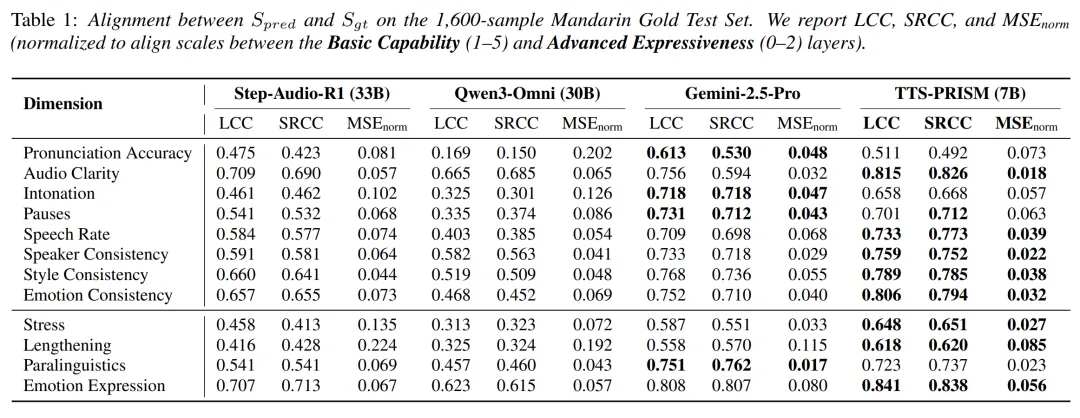
题注内容:四个模型在 1,600 条金标准测试集 12 个维度上的人类对齐表现对比
推理质量
所有模型的 RSC 均超过 0.88,但基线模型展现出 "高 RSC 低对齐" 的矛盾现象:Qwen3-Omni 的 RSC 为 0.88,Step-Audio-R1 为 0.91,表明其推理过程与声学现实脱节。TTS-PRISM 的 RSC 达到0.98,同时保持高对齐度,证实了 Schema-Driven 微调策略的有效性。
OOD 泛化能力
在 20% 的分布外子集上,TTS-PRISM 在基础能力层的平均 LCC 为0.690(ID 为 0.729),高级表现力层的平均 LCC 为0.675(ID 为 0.716),性能下降幅度有限,表明模型对未见过的伪影具有较好的泛化能力。
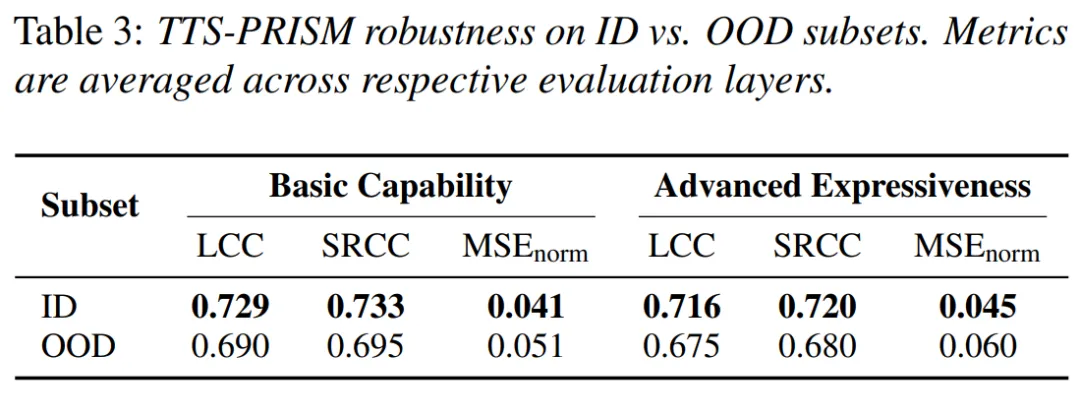
题注内容:TTS-PRISM 在分布内(ID)与分布外(OOD)子集上的鲁棒性对比
消融实验
消融实验揭示了三个核心组件的贡献:
移除负样本:LCC 从 0.717 暴跌至0.150,甚至低于未经微调的原始骨干基线(0.320),表明缺乏靶向硬负样本会诱发保守预测偏置。 移除指令微调:LCC 为0.320,说明细粒度诊断并非 ASR 预训练骨干的固有能力,而是通过 Schema-Driven 专家对齐激活的潜在能力。 移除 CoT 推理:LCC 降至0.662,证实显式推理过程作为逻辑正则化器的有效性。
值得注意的是,移除负样本的消融实验采用了 "计算量匹配" 策略(通过增加训练 epoch 对齐总 token 消耗量),严格排除了欠拟合偏置。
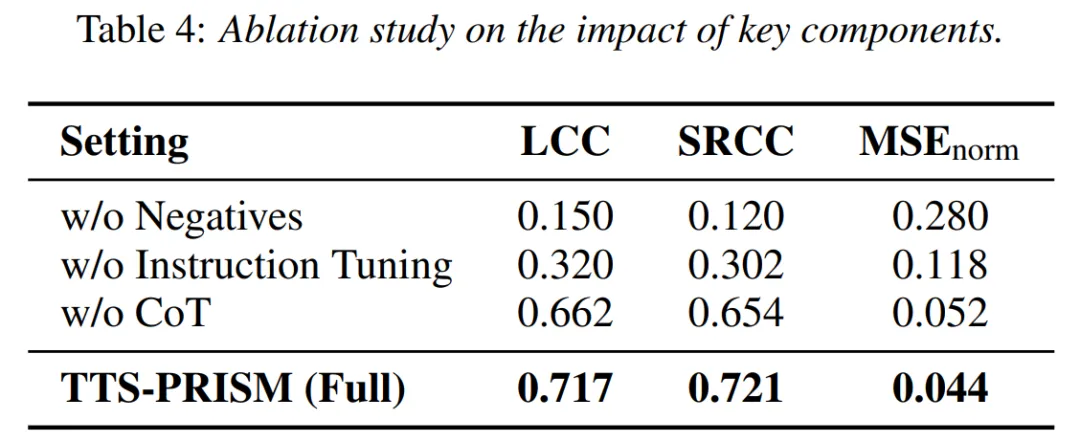
题注内容:消融实验结果,评估负样本、指令微调和 CoT 推理三个核心组件的贡献
TTS 系统诊断画像
论文对 6 个领先的 TTS 系统进行了诊断画像,每个系统评估 500 条多样化语音。基础能力层采用盲测(默认配置下纯文本输入),高级表现力层则充分激活各模型的特有控制(如音频 prompt 或风格标签),取最高平均分以消除配置偏置。
基础能力层呈现显著的天花板效应:所有系统的句内一致性均超过 4.9。在此层内,Qwen3-TTS 在发音准确度上最高(4.860),CosyVoice 3 在音频清晰度(4.803)和停顿(4.829)上建立了优势。
高级表现力层揭示了不同架构的建模优先级差异:
IndexTTS 2 获得 "Highly Expressive" 标签,在情感表达(1.043)和拖音(1.033)上居首。 CosyVoice 3 获得 "Paralinguistic-Enhanced" 标签,副语言得分达0.735,重音得分达1.390。 MaskGCT 获得 "Prosody-Limited" 标签,拖音仅0.067,反映了其时长控制设计的保守倾向。 F5-TTS 获得 "Stable but Flat" 标签,副语言仅0.114,尽管基础一致性出色。 Qwen3-TTS 获得 "Pronunciation-Accurate" 标签。 FireRedTTS-2 获得 "Balanced" 标签。
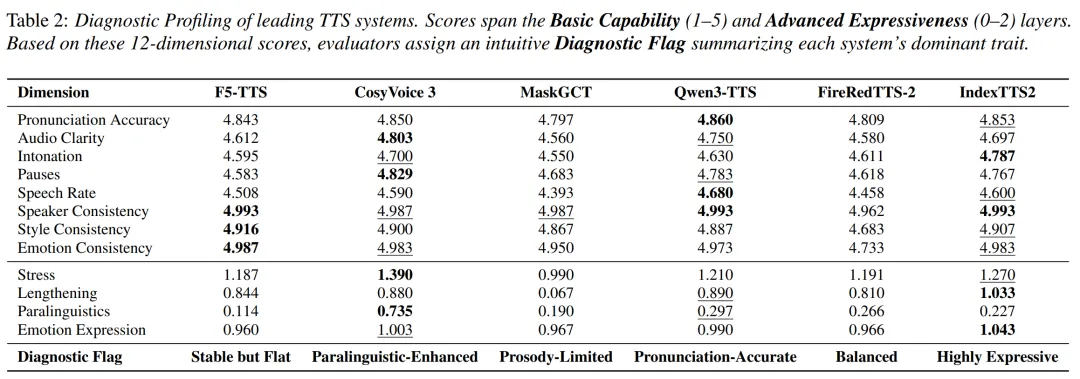
题注内容:六个 TTS 系统的 12 维诊断画像及诊断标签
文章小结
TTS-PRISM 提出了面向中文的细粒度语音合成诊断框架,核心贡献在于:建立了具有明确量化标准的 12 维评价体系,构造了包含 20 万条样本的靶向诊断数据集,以及通过 Schema-Driven 指令微调实现了可解释的端到端诊断模型。实验表明 7B 参数的 TTS-PRISM 在多数维度上超越了 30B 以上的通用模型。发音准确度维度的局限性揭示了 ASR 预训练骨干固有的智能容错偏置,论文计划在后续工作中通过强化学习进行校准。整套框架(评分标准、代码和模型权重)已开源。
