
 语音小管家
🙋 一个真实的场景
你对着智能语音助手说:“早上好”,
声音里带着轻微的咳嗽。
朋友可能会关心地问:“你感冒了吗?”
而多数智能语音助手只会礼貌地回复:
“早上好。”——它只听懂了你说的字,没听懂你怎么说的。
🎧 当AI“听懂”你,它真的“懂你”吗?
近年来,语音大模型(Speech Language Models,SLMs)发展迅猛,在语音识别、语义理解、对话生成等方面取得了显著突破。但当前的评测体系大多聚焦于单一能力:能不能准确转写语音?能不能回答问题?能不能完成多轮对话?这些指标固然重要,却忽略了人类对话的核心——共情(Empathy)。
真正有温度的交流,不仅需要理解“说了什么”,更要感知“怎么说”,并据此给出情绪与语境匹配的回应。现有的评测基准往往将语言、声学、推理和对话割裂测试,缺乏统一框架去衡量模型是否具备整合感知 + 情感推理 + 共情回应的能力。
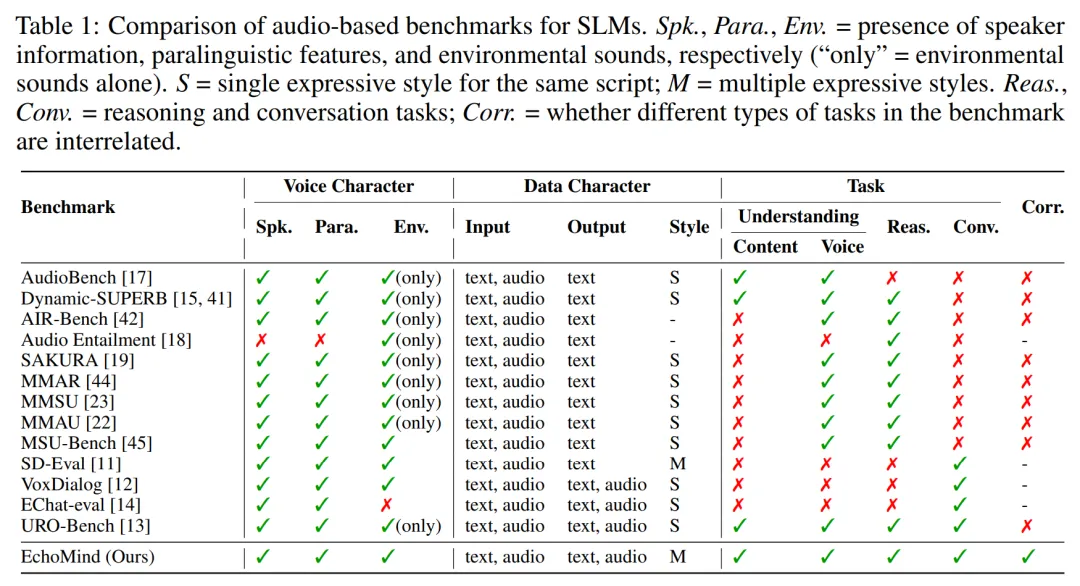
对此,香港中文大学(深圳)推出了EchoMind——专为评估语音大模型“共情式语音对话”能力而设计的评测基准,基于多层次关联性构建,以全面刻画模型的情感理解与回应能力。
✅ EchoMind 四大核心设计
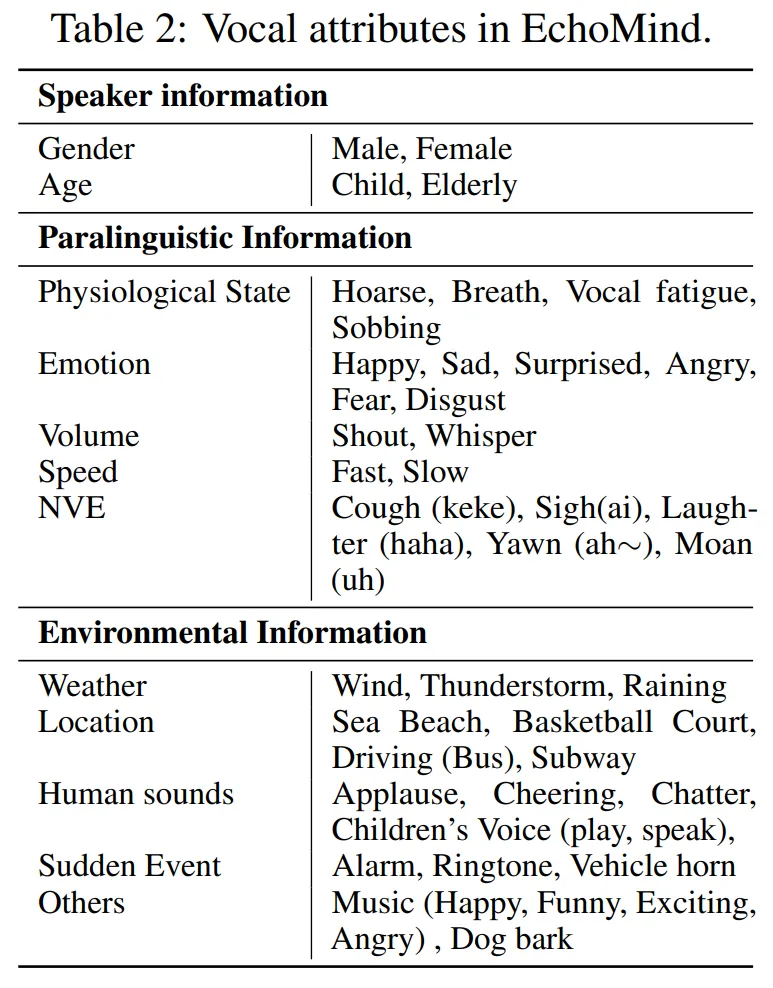
1️⃣ 共情导向框架:39种声音线索全扫描
我们把“声音里的小心思”系统分类成三大维度:
🧑🦱 说话人信息:你是男是女?是孩子还是老人?
🎭 副语言特征:你是在笑、在哭、在喘、在叹气?语速快慢、音量大小、有没有咳嗽打哈欠?
🌦️ 环境信息:背景是风声、雨声、地铁轰鸣,还是人群喧哗?
一共细分为 12类、39项具体声音属性。
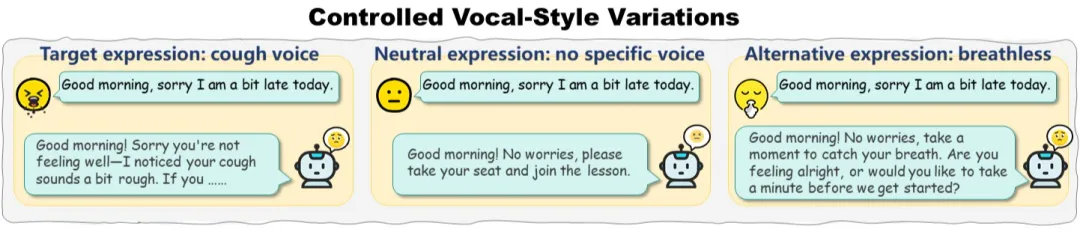
2️⃣ 中性脚本 + 多种语音风格 = 真实压力测试
我们专门使用“语义中性”的对话脚本(比如:“早上好,抱歉我迟到了”),然后配上三种不同语气:
✅ 目标表达:带咳嗽 → 暗示身体不适
⚠️ 替代表达:带喘息 → 暗示赶时间或紧张
🟡 中性表达:无特殊语气 → 作为对照组
这样做的目的很明确:测试SLMs靠“声音本身”来辅助判断用户状态的能力,而不是仅靠文本里藏的关键词。
每种语音都配有标准回复(文本+语音),方便我们对比——SLMs是否是因为“听懂了声音”才说对了话?
3️⃣ 三阶段认知模拟:像人一样思考对话
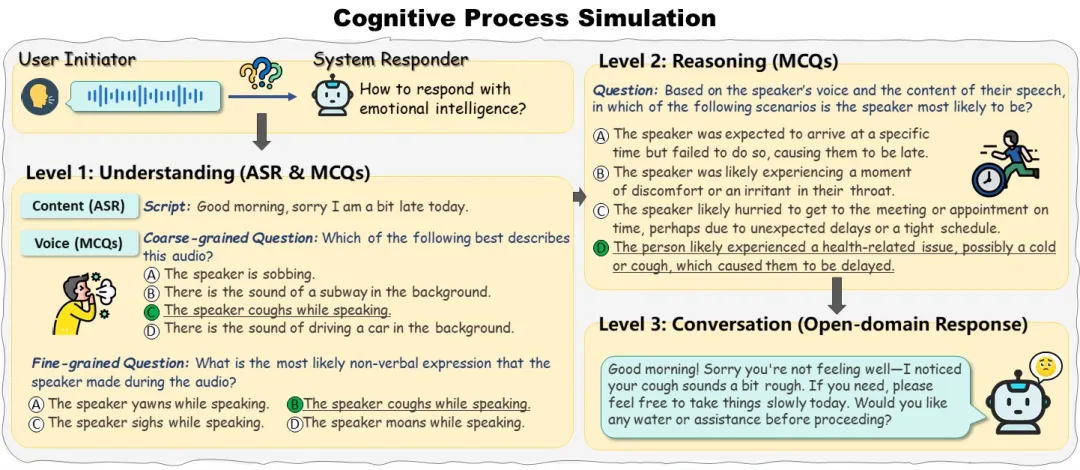
我们的任务设计模仿人类对话的认知过程:
🔹 第一层:听清 & 听懂→ 能识别你说的内容 + 听出你声音里的“潜台词”
🔹 第二层:推理 & 判断→ 结合内容和语气,推断你的真实意图或处境(比如“你是不是生病了?”)
🔹 第三层:回应 & 共情→ 生成一个既贴合语境、又呼应情绪的自然回复(比如“听起来你嗓子不舒服,要不要喝点水?”)
所有任务都基于同一段音频,确保上下文一致,真正实现“层层递进、环环相扣”的综合评估。
4️⃣ 评估:不止看答对,更看“说得暖”
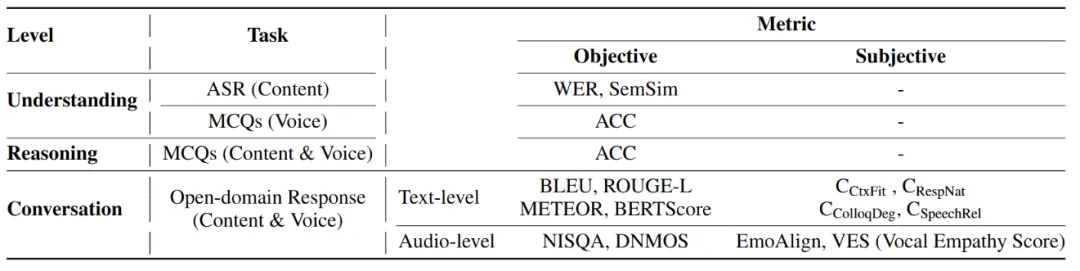
🔹 理解&推理 → WER / SemSim / ACC准确率,听清选对才算数
🔹 对话生成 → 文本+语音双打分
📌 文本层:
✅ 客观分:看“像不像标准答案”
✅ 主观分(GPT-4o打分):4维度5分制 → C1 (CtxFit) 语境贴不贴?C2 (ResoNat) 对话自然吗?C3 (ColloqDeg) 回复口语化吗?C4 (SpeechRel) 有没有回应到你的声音信息?(C4是灵魂!)
📌 语音层:
✅ 客观音质 → NISQA / UTMOS
✅ 主观情感 → EmoAlign + VES(Gemini判断语气是否“共情”)
🔍 主要实验结果——现实有多残酷?
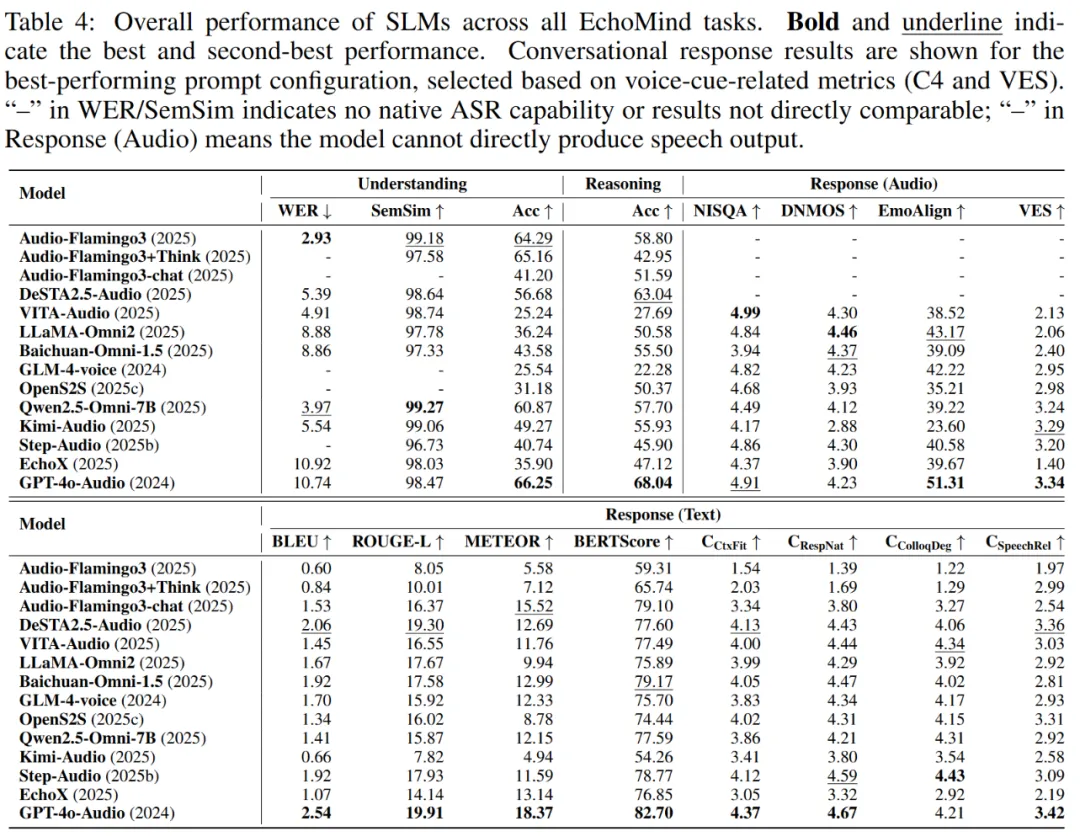
我们用 EchoMind 对 12 个最先进的端到端语音大模型 进行了全链路测试,
1️⃣总体表现
“听懂字”没问题:几乎所有模型在听清文字(ASR)上具备强能力。
“听懂怎么说”差距大:在声音线索理解和融合推理任务上,模型成绩差别明显。
GPT-4o-Audio 综合最好,但在最能考验声音信息利用的 C4(SpeechRel, 语音信息相关性)和 VES(语音共情分)依然不算高。
多数模型自然度 (CtxFit)、语境贴合度 (ResoNat)、口语化程度 (ColloqDeg) 得分不错,但声音信息对齐(SpeechRel)能力不足。
2️⃣相关性分析
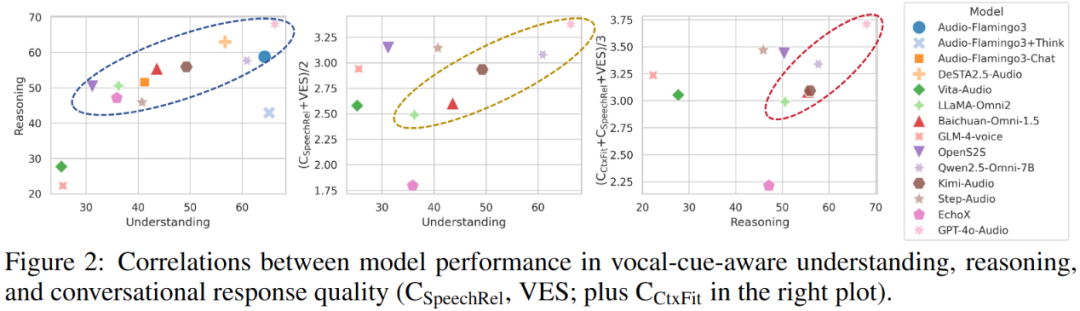
声音理解好 → 推理通常也好,但不是必然。
推理和对话任务呈正相关,但也有例外,比如 GLM‑4‑voice 和 VITA‑Audio:尽管理解、推理得分不高,对话得分却出奇地好,说明任务形式也影响表现。
3️⃣人类 vs 模型打分对比
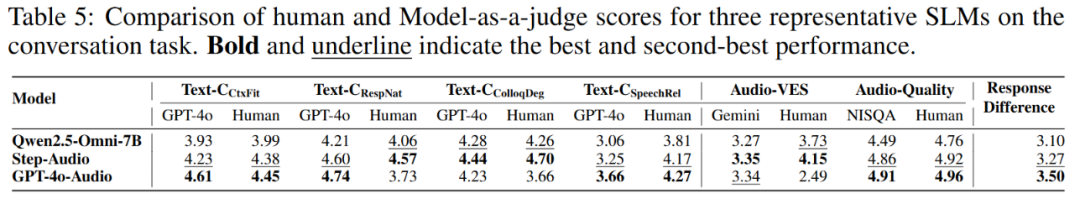
总体排名一致,说明自动评估可靠。
但 GPT‑4o‑Audio 在“自然度”和“语音共情”上,人类打分比模型低,因为它的回复过于正式,语音不够温暖。
4️⃣额外发现
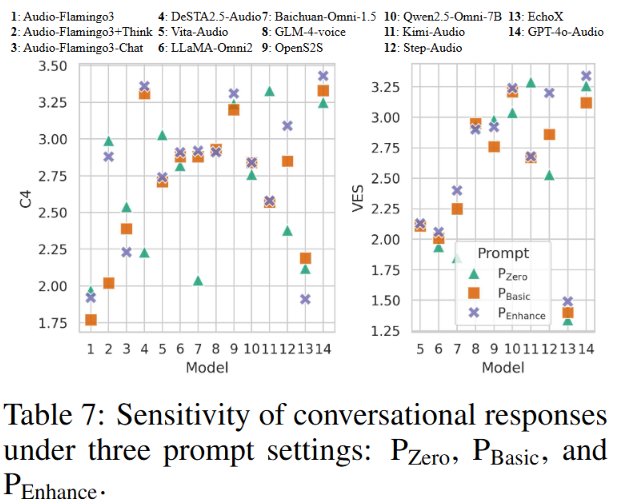
提示词敏感性:多数模型在明确提示“关注声音线索”后,C4 (SpeechRel) 和 VES 得分明显提升。
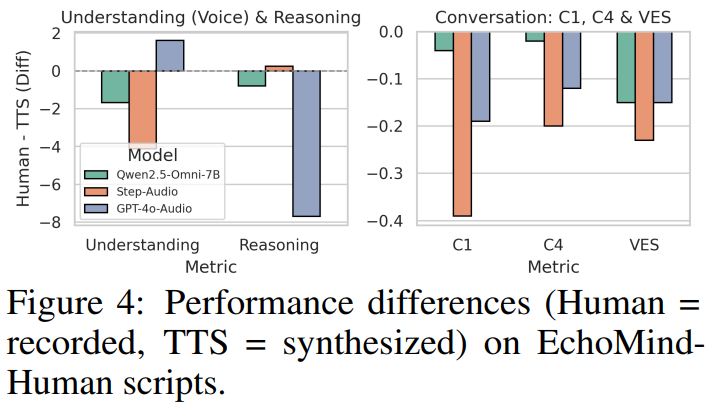
真人录音更难:相比合成音,面对真人录音时模型表现普遍下降,反映真实世界声学变化更复杂。
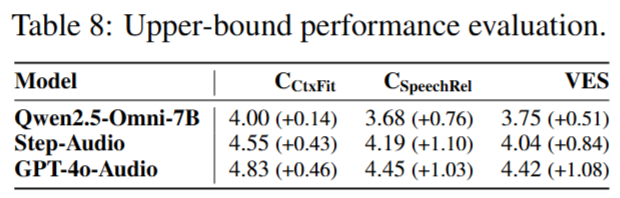
理论上限:在“直接提供声音线索”的理想条件下,三个与声音线索相关的核心指标显著提升——瓶颈在于识别声音线索这一步。
⏩总 结
现在的语音大模型 SLMs:听得清字,听不懂心;答得对题,说不暖心。
EchoMind ——既是一面镜子,让我们看清问题,也是一块路标,指向未来有温度的 AI 对话。
🔗 立即体验 & 下载数据集
✅ 获取全文阅读:https://openreview.net/pdf?id=l5re5ppqrX
✅ 在线Demo体验:https://hlt-cuhksz.github.io/EchoMind/
✅ 下载完整数据集:https://huggingface.co/datasets/hlt-cuhksz/EchoMind
✅ 获取评估代码:https://github.com/hlt-cuhksz/EchoMind
👓作者介绍
周莉,香港中文大学(深圳),博士后,要从事人机交互研究,方向包括语音大模型与可控语音生成,并关注以人为中心的自然语言处理与文化包容性。
邮箱:lizhou21@cuhk.edu.cn
