在会议和电话等真实的多说话人对话场景中,全面的对话理解不仅需要准确的语音识别(ASR),还要求模型能够联合处理说话人属性、细粒度的时间戳定位以及文本转写。然而,语音重叠、频繁的附和(backchannels)以及快速的语权交替等复杂声学现象,极大增加了该任务的难度。传统的级联系统容易产生阶段间的错误传播,且难以有效协调重叠语音;而主流的端到端方法由于依赖单遍序列推理,缺乏应对多人同时发言和打断等复杂现象的灵活机制。近年来,尽管语音大语言模型(Speech LLMs)表现优异,但在向多说话人环境扩展时,仍面临任务特征建模不全、推理策略单一,以及受限于固定上下文窗口难以处理长录音等瓶颈。
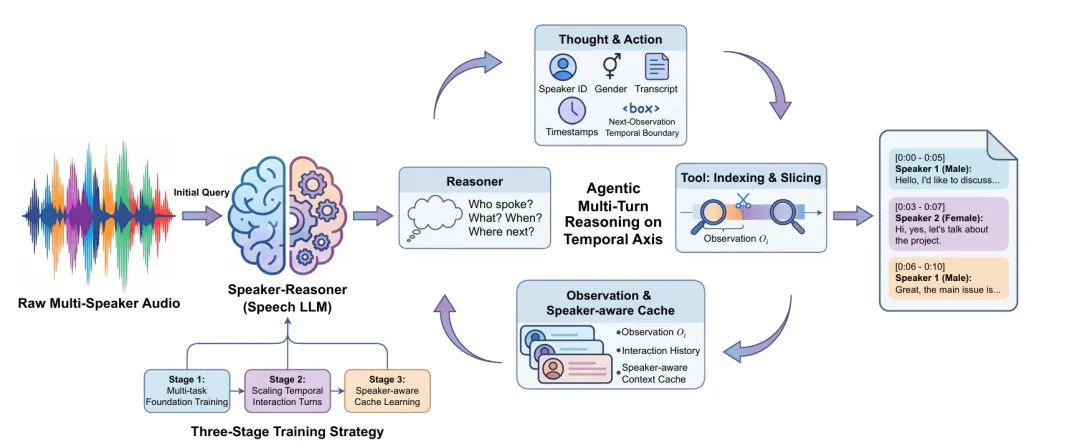
为解决上述问题,西北工业大学音频语音与语言处理实验室(ASLP@NPU)联合南京大学及上海玲光乍现科技,提出了Speaker-Reasoner—— 一种以时间轴智能体多轮推理为核心的端到端语音大模型。简而言之,把“who said what at when”的语音理解过程当成一个“多轮推理过程”,而不是一次性解码。该模型将传统的单次输出范式重构为“全局到局部”的渐进式交互流程:模型首先分析完整音频以获取全局说话人分布摘要,随后自主预测时序边界、提取局部切片进行细粒度解码,并结合历史状态决定交互的延续或终止。针对长音频处理难题,研究团队创新性地引入了说话人感知上下文缓存(Speaker-aware Context Cache)机制,为超出窗口的录音提供历史参考,有效维持了跨切片的身份一致性。依托 4194 小时的多领域双语语料与三阶段渐进式训练策略,Speaker-Reasoner 在处理严重语音重叠与快速语权交替时表现卓越。实验表明,其在 AliMeeting [5]、AISHELL-4 [4] 及 AMI [6] 等主流公开基准和复杂内部测试集上,均取得了优异的联合建模性能,全面超越了包括 Gemini-2.5-Pro 在内的诸多基线模型。相关技术报告 “Speaker-Reasoner: Scaling Interaction Turns and Reasoning Patterns for Timestamped Speaker-Attributed ASR” 已公开发布,开源了相关代码(GitHub)、模型权重(Hugging Face),并提供了 Demo 体验页面。诚邀各位开发者与研究人员关注、试用,共同探索复杂多说话人场景下语音理解技术的新边界!
论文题目:Speaker-Reasoner: Scaling Interaction Turns and Reasoning Patterns for Timestamped Speaker-Attributed ASR
作者列表:林振楠、王帅、孙照凯、谢鹏源、谢川、刘杰、张强、谢磊†在会议和电话等真实的多说话人对话场景中,全面的对话理解不仅需要语音识别,还要求模型能够联合处理说话人属性、细粒度的时间戳定位以及文本转写。然而,语音重叠、附和(backchannels)以及快速的语权交替等复杂声学现象,增加了该任务的难度,往往导致说话人识别与转写精度下降。传统方案多采用级联框架,将独立训练的说话人日志(SD)与自动语音识别(ASR)模块拼接,这容易导致阶段间的错误传播。尤其在处理重叠语音时,独立模块的输出难以协调,且系统缺乏联合优化的空间。为克服上述局限,基于序列化输出训练(SOT)[3] 的端到端方法逐渐成为主流。但现有 SOT 模型依赖单遍序列到序列推理,缺乏应对同时发言和打断等复杂现象的机制。近年来,语音大语言模型(Speech LLMs)在多项语音任务中表现出色,但其设计多针对单说话人场景。现有模型向多说话人环境扩展时普遍面临三大瓶颈:首先,任务覆盖不全面,鲜少涉及涵盖说话人身份、时间戳与转写的全特征联合建模,性别等关键属性也常被忽视;其次,推理策略单一,仅依赖 SOT 解码难以有效应对语音重叠与快速切换;最后,固有的上下文窗口限制了长音频的处理能力,难以胜任实际应用中的长程录音转写。受近期通过扩展交互轮次和推理模式解决复杂问题取得突破的启发,我们认为多说话人 SA-ASR 任务在时间轴上更适合渐进式推理过程:模型需先将整体音频结构作为全局上下文加以理解,再逐步定位说话人边界,最后执行细粒度的音频段分析。这种由全局到局部的处理范式与多轮交互机制高度契合。基于此,我们提出了 Speaker-Reasoner,一种以时间轴智能体多轮推理为核心的端到端语音大模型。与传统的单轮推理不同,Speaker-Reasoner 采用基于工具的迭代交互机制。模型首先分析完整音频以获取全局说话人分布,随后自主预测时序边界、提取并分析局部片段,最终结合历史状态决策是否继续或终止交互。本文的主要贡献在于确立了 Speaker-Reasoner 基于时序全局到局部推理的系统框架,并针对长音频处理引入了说话人感知上下文缓存(Speaker-aware Context Cache)机制。该机制可为超出上下文窗口的长程录音提供历史声学参考,从而在跨切片处理时维持高度的说话人身份一致性。为实现上述潜能,我们设计了三阶段渐进式训练策略,依次培养模型的多任务语音理解、时序交互以及缓存使用能力。在扩展工作中,我们将训练数据规模提升至 4194 小时的多领域双语(中英)语料,使模型能够支持更具挑战性的双语复杂多说话人场景。综合评估表明,无论是在内部视频数据集,还是在 AliMeeting [5] 与 AISHELL-4 [4] 等主流公开基准上,Speaker-Reasoner 均取得了优异的性能。在处理严重的语音重叠与快速语权交替时,其表现优于包括闭源大模型 Gemini-2.5-Pro 在内的多个基线模型。Speaker-Reasoner 旨在突破传统单遍解码器在处理重叠语音和固定上下文窗口限制方面的瓶颈。为此,模型将传统的端到端一次性输出范式,重构为动态迭代的全局到局部推理流程。该方案包含三个协同运作的核心机制:全局音频结构的宏观摘要、沿时间轴递进的切片级观测交互,以及跨音频块的说话人一致性维护。Speaker-Reasoner 总体架构与推理流程
在模型架构方面,Speaker-Reasoner 遵循指令微调的语音大语言模型范式,核心组件均初始化自采用混合专家(MoE)架构的 Qwen3-Omni [2]。系统由声学编码器、模态投影器与自回归解码器三部分组成。模型首先利用音频 Transformer(AuT)编码器处理输入的原始音频,通过内置的 Conv2D 模块进行高倍率下采样,提取帧率约为 12.5 Hz 的紧凑声学特征。随后,轻量级的双层感知机(MLP)将声学特征对齐至大语言模型的嵌入空间。最终,MoE 解码器接收拼接了指令文本与历史生成的联合特征,进行自回归推理。该方案的核心设计在于迭代式时序交互机制。模型不再一次性处理全部音频,而是沿时间轴以增量方式进行多轮交互。在每一轮处理中,模型接收当前的局部音频切片(即观测区间)、交互历史以及缓存信息。其目标是输出当前区间内所有发言者的身份、性别、时间戳与转写文本,并自主预测下一步需要处理的音频时间边界。为处理会议中常见的附和与多人同时发言现象,训练期间引入了重叠容忍机制:当相邻语音段的时间重叠比例超过预设阈值(如 0.8)时,系统会将其合并至同一观测区间进行联合建模。在推理阶段,模型通过输出离散的边界标记实现自主的时间推演。首轮交互要求模型输出包含说话人总数及性别分布的全局摘要;后续轮次则深入局部逐片解码;当模型输出闭合标签(如 )时交互终止,最终生成按时间严格排序的结构化转写内容。说话人感知缓存 (SAC) 更新机制
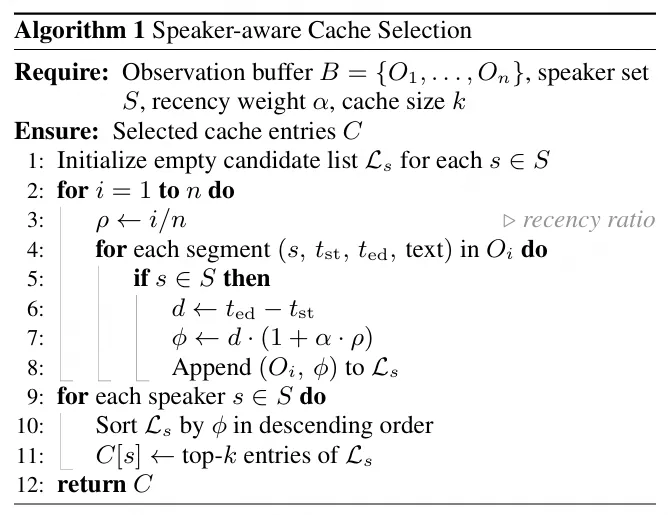
为应对长程录音超出单次处理窗口的问题,方案引入了说话人感知上下文缓存机制。在分块处理长音频时,说话人身份极易发生漂移。该机制通过维护包含“说话人标签、音频切片及对应文本”的历史特征库,为模型提供稳定连续的身份参考。推理时,系统实时维护观察缓冲池,并针对每位出现的说话人,根据历史片段的持续时长与距离当前时刻的新近度进行联合打分。得分最高的历史片段会被提取并前置于当前的提示上下文中。这种设计不仅保障了说话人再次发声时的身份一致性,也提升了系统区分新说话人的敏感度。为使模型平稳掌握上述复杂的交互与缓存调配能力,方案采用了三阶段渐进式训练策略:- 多任务基础训练阶段:模型通过教师强制(Teacher Forcing)机制进行序列自回归学习,重点掌握包含标签、性别、时间戳和文本的全结构化输出,建立由全局摘要引导局部生成的认知。
- 时序交互学习阶段:训练重心转移至切片级的递进式处理。模型学会在特定时序区间内进行精准截断与下一步动作规划。
- 缓存学习阶段:通过在训练数据中随机采样并植入历史非重叠区域的缓存条目,模拟长音频推理时的跨切片场景,迫使模型在具有标签连续性约束下生成内容,赋予了模型在长对话中保持卓越连贯性的能力。
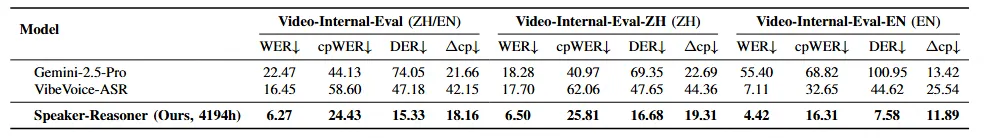
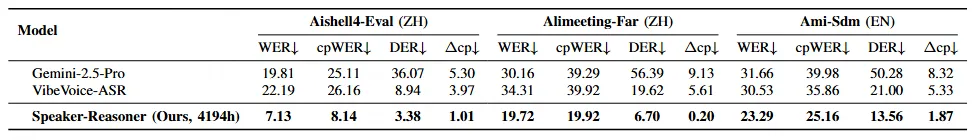
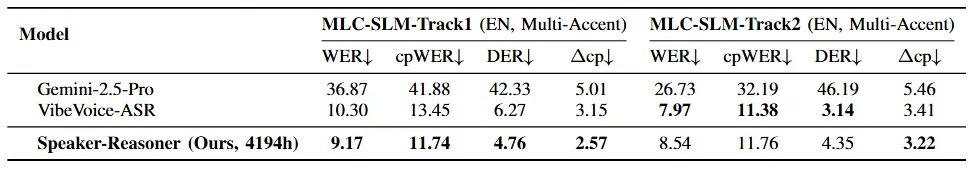
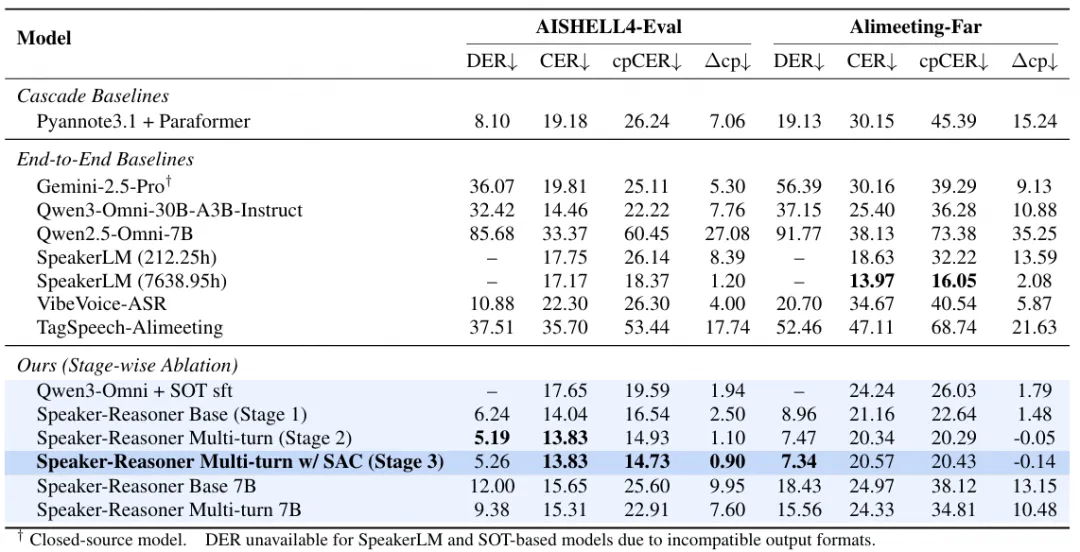
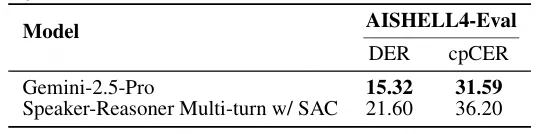
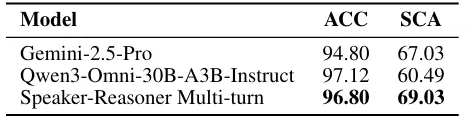
在实验验证环节,我们构建了多维度的评估体系,以全面检验模型在复杂多说话人场景下的日记化、转写及属性识别能力。评估指标包括日记化错误率(DER)和字错误率(WER),并引入了拼接最小排列字错误率(cpWER)及其与标准错误率的差值(Δcp)。这有助于剥离说话人分配错误导致的影响,量化系统的联合建模性能。表4 中文测试集基线对比与消融实验结果 (论文结果)在初期实验中,模型基于 30B 参数的 Qwen3-Omni 进行初始化,并在主流中文会议语料 AliMeeting [5] 与 AISHELL-4 [4] 上进行了验证。为进一步探究架构的扩展潜力,后续工作将训练数据大幅扩充至 4194 小时的双语(中英)多领域语料,使 Speaker-Reasoner 能够应对更为复杂的声学挑战。多领域评估结果表明,模型在复杂视频场景及多个公共会议基准上均展现出领先的性能。以内部多语种视频评估集(Video-Internal-Eval)为例,Speaker-Reasoner 取得了 15.33% 的 DER 与 24.43% 的 cpWER,相较于 Gemini-2.5-Pro(DER 74.05%)以及基线模型 VibeVoice-ASR [1](DER 47.18%),实现了显著的性能跃升。在主流公开数据集 AISHELL-4 和 AliMeeting-Far 上,该模型同样达到了领先水平。此外,在英文会议语料 AMI-SDM [6] 上也稳居最优梯队。针对训练策略的消融实验证实了时序交互机制的必要性:从单任务基础微调(Stage 1)过渡到切片级多轮交互(Stage 2)后,各项错误率指标均显著下降。这表明智能体推理能够有效捕捉时序依赖,从容应对发言者的快速轮换。进一步引入说话人感知上下文缓存(Stage 3)后,模型在长音频 AISHELL-4 评估中有效保持了跨音频块的身份一致性。此外,在全局说话人属性预测方面,全局摘要设计展现出显著优势。在 AISHELL-4 评估集上,该模型的性别预测准确率达 96.80%,说话人总数预估准确率(SCA)达 69.03%,不仅优于零样本状态下的 Qwen3-Omni,还在复杂音频的全局成分分析上超越了 Gemini-2.5-Pro。综合各项实验结果,Speaker-Reasoner 验证了其在全特征时间戳说话人归属语音识别(SA-ASR)任务中的优越性能,证明了在语音大模型中扩展交互轮次与推理模式的巨大潜力。“Speaker-Reasoner 将多说话人语音理解重构为一个 Agentic 多轮时序推理过程”[1] Z. Peng, J. Yu, Y. Chang, et al., "VIBEVOICE-ASR technical report," CoRR, vol. abs/2601.18184, 2026.[2] J. Xu, Z. Guo, H. Hu, et al., "Qwen3-omni technical report," CoRR, vol. abs/2509.17765, 2025.[3] N. Kanda, Y. Gaur, X. Wang, Z. Meng, and T. Yoshioka, "Serialized output training for end-to-end overlapped speech recognition," in Proc. Interspeech, 2020, pp. 2797–2801.[4] Y. Fu, L. Cheng, S. Lv, et al., "AISHELL-4: An open source dataset for speech enhancement, separation, recognition and speaker diarization in conference scenario," in Proc. Interspeech, 2021, pp. 3665–3669.[5] Y. Liang, M. Shi, F. Yu, et al., "The second multi-channel multi-party meeting transcription challenge (M2MeT 2.0): A benchmark for speaker-attributed ASR," in Proc. ASRU, IEEE, 2023, pp. 1–8.[6] J. Carletta, S. Ashby, S. Bourban, et al., "The AMI Meeting Corpus: A Pre-announcement," in Machine Learning for Multimodal Interaction (MLMI), LNCS, Springer, 2005, pp. 28–39.[7] B. Mu, P. Guo, Z. Sun, et al., "Summary on The Multilingual Conversational Speech Language Model Challenge: Datasets, Tasks, Baselines, and Methods," in Proc. ICASSP, IEEE, 2026, pp. 19442–19446.
 语音小管家