
 语音小管家
今天,阶跃正式发布新一代自动语音识别模型StepAudio 2.5 ASR!
这款模型的核心突破在于速度与精度的兼得。我们率先将大语言模型(LLM)的推理加速技术引入语音识别领域,基于 ASR+MTP-5 深度融合架构,实测推理速度提升400%、时延降低60%,推理峰值达500 tokens/s,推理成本直降80%。
5 分钟左右的音视频,“一眨眼”即可转写完成。
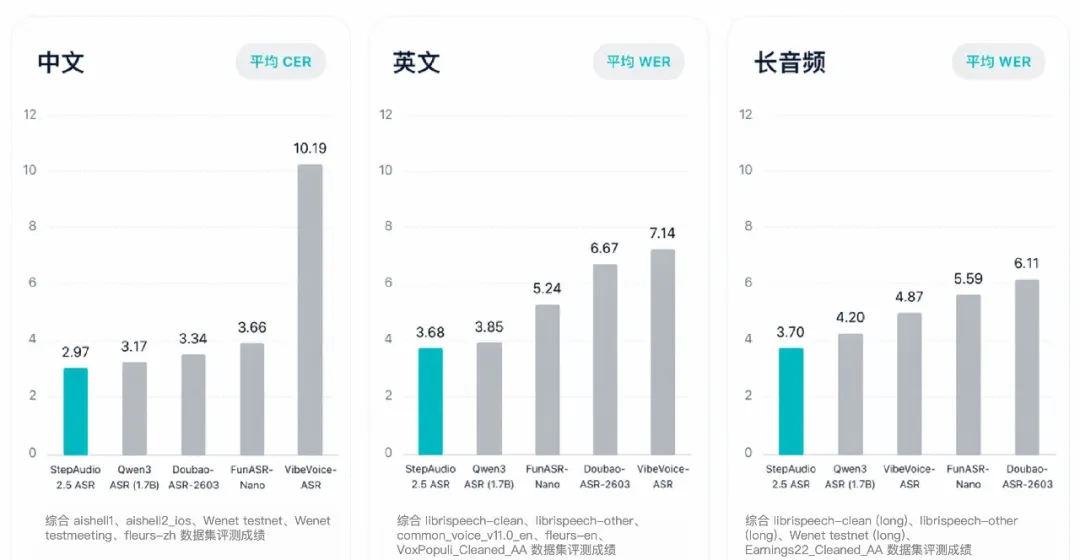
精度方面,StepAudio 2.5 ASR 在多项主流评测基准上超越同类模型,达到业内SOTA水平。
同时,模型通过复用 LLM 原生的 32K 上下文窗口,单次可完整转写长达 30 分钟的音频,彻底告别传统“切片转写”方案导致的上下文断裂问题。
目前 StepAudio 2.5 ASR 已全量上线「阶跃星辰开放平台」和 Step Plan,欢迎大家前往体验!
阶跃星辰开放平台:https://platform.stepfun.com/docs/zh/guides/models/stepaudio-2.5-asr
Step Plan:https://platform.stepfun.com/docs/zh/step-plan/integrations/audio-api
极速转写,SOTA 精度
StepAudio 2.5 ASR 在覆盖新闻播报、会议访谈及强噪声环境的 5 个权威中文开源测试集上,综合字错误率对比竞品取得显著领先优势。
在 LibriSpeech clean/other 等 5 个权威英文开源测试集中,综合词错误率同样低于同类模型,以更低算力实现更高转写上限。在长音频专项测试中,即使面对 30 分钟的满载输入,模型综合转写精度依然保持 SOTA 水准,没有出现常见的“越说到后面精度越低”的衰减问题。
如何又快又好?
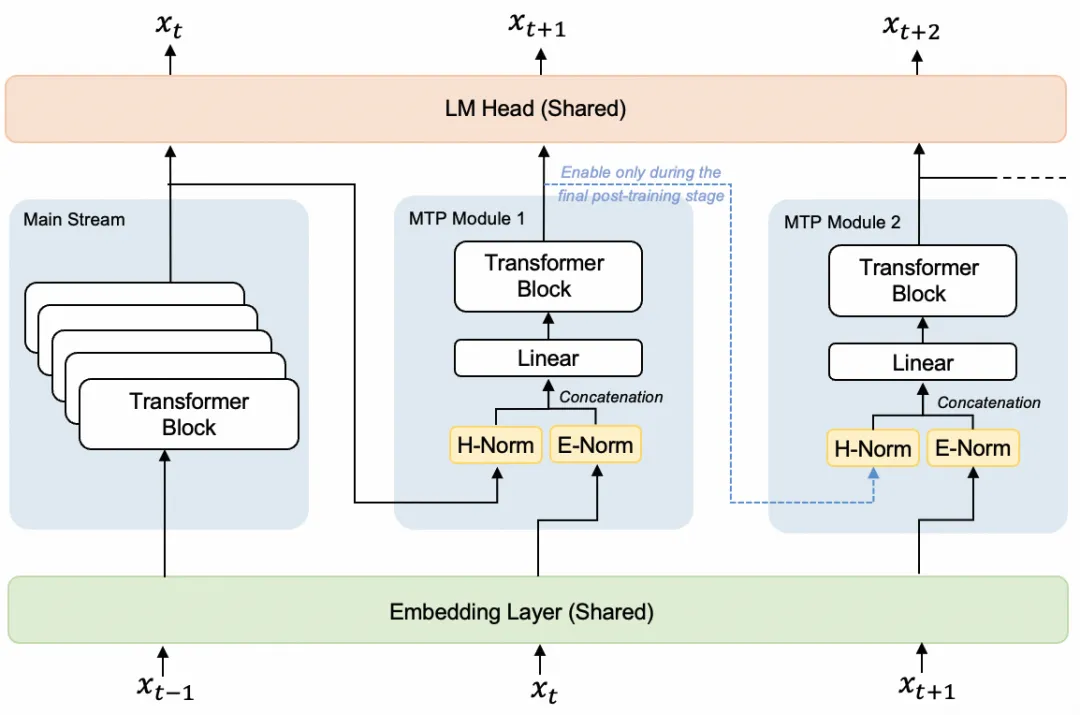
传统语音识别模型受限于自回归生成机制,必须逐个 Token 依次输出,就像打字员一个字一个字地敲键盘。StepAudio 2.5 ASR 将 Step 3.5 Flash 同款的MTP(多 Token 预测)技术移植至语音识别领域,使模型能够一次预测多个候选 Token,并通过并行验证机制快速确认结果。
这一架构带来的具体提升是:吞吐量提升 400%、时延降低 60%、推理成本直降 80%。
在处理长音频方面,行业内通常依赖“切片-转写-拼接”方案,即把音频切成若干小段分别识别再合并。这种方式的问题在于每段之间的上下文是断开的——模型在转写第 10 分钟的内容时,已经“忘记”了第 1 分钟说过的话。
StepAudio 2.5 ASR直接复用 LLM 原生的 32K 上下文窗口,端到端地一次性读入最长 30 分钟的完整音频,即在转写第 29 分钟的对话时,依然能清晰“回忆”起第 1 分钟确立的会议背景。
目前,StepAudio 2.5 ASR 已全量上线,欢迎使用:
阶跃星辰开放平台:https://platform.stepfun.com/docs/zh/guides/models/stepaudio-2.5-asr
Step Plan:https://platform.stepfun.com/docs/zh/step-plan/integrations/audio-api
体验中心:https://www.stepfun.com/studio/audio?tab=speech-recognition
Demo Page:https://stepaudiollm.github.io/step-audio-2.5-asr/
Model Card:https://stepaudiollm.github.io/step-audio-2.5-asr/model-card/
