
 语音小管家
在今天的语音合成系统里,听起来自然已经不再稀缺,但哪里该慢一点、哪个字该拉长、哪个位置该停顿、停多久,依然很难真正交给用户来控制。
但这恰恰是很多真实应用场景在意的问题。
比如导航播报里,“前方路口左转”中的“左转”往往需要更清楚、更突出;
比如儿童跟读或语言教学中,老师希望某个字读得更慢一点、词与词之间停顿更明确;
比如验证码、药品名、人名地名这类高辨识内容,用户真正需要的不是整体语速变慢,而是对关键字和关键停顿做局部、精确的控制;
再比如无障碍朗读、车载交互、智能客服等场景,很多时候问题不是能不能说出来,而是能不能按我们想要的节奏说出来。
遗憾的是,现有主流TTS 系统大多只能提供整句级时长控制或者全局语速调节。它们可以让一句话整体变快或变慢,却很难做到:把某一个字多读 50 毫秒、把某个边界停顿拉长到 260 毫秒,并且不破坏整句的自然度。这是现代语音合成在可控性上存在的一块空白。
而这正是MAGIC-TTS解决的问题。
据我们所知,MAGIC-TTS是首个能够对token 级内容时长和停顿进行显式局部控制的语音合成系统。我们第一次把“字读多久”和“在哪里停、停多久”都变成了可以显式指定的控制量,而且可以做到毫秒级精度的局部调节。
MAGIC-TTS 既能在提供局部时序指令时稳定跟随,又能在不给任何控制时,继续保持自然、高质量的默认合成表现。同时,在基于真实应用场景设计的局部编辑任务中,模型也能把被编辑区域稳定推向目标毫秒值。
论文题目:MAGIC-TTS: Fine-Grained Controllable Speech Synthesis with Explicit Local Duration and Pause Control
作者列表:麦家龙,邢晓芬,徐向民
单位:华南理工大学
项目资源:(代码与模型现已开源)
HuggingFace:https://huggingface.co/maimai11/MAGIC-TTS
⏩我们是怎么做到这种精确、可靠控制的?
MAGIC-TTS 的核心思路其实很直接:我们不再把时长完全交给模型隐式学习,而是把它变成一个可以显式输入的局部控制信号。
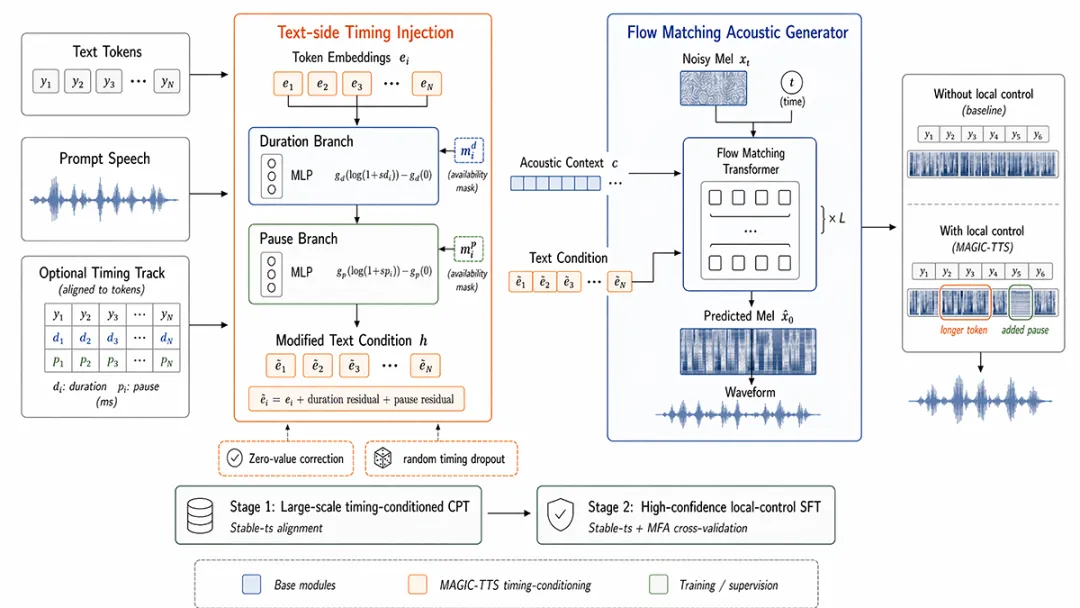
具体来说,对每个token,我们都建模两类时间信息:一类是内容时长;另一类是停顿时长。语音生成第一次具备了真正面向局部内容的时序编辑能力。用户既可以只改一个边界的停顿,也可以只拉长某几个关键字,还可以把二者组合起来使用。
但要把这种能力真正做成可用,难点并不只是把控制量喂给模型。真正困难的地方在于:停顿和内容时长虽然都属于时间控制,但并不是同一种问题。停顿更多作用在边界附近,而内容时长控制要求模型直接重塑token 内部的发音实现,因此更细、更难,也更容易受到边界误差影响。我们要解决的,不只是会加停顿,而是真正做到会控字。内容时长控制是这个问题里更艰难、更关键的一部分。
为了解决这个问题,MAGIC-TTS 主要做了三件事:
第一,是把局部时序做成显式的token 级控制接口。我们直接把内容时长和停顿时长作为控制量输入模型。这样,拉长一个字和增加一个边界停顿都变成了明确、可操作、可精确赋值的动作。
第二,是尽可能提高局部时序监督的可靠性。因为如果token 边界本身就不准,那么某个字应该有多长就会变成一个模糊问题。为此,我们没有只依赖单一路径的自动对齐,而是先利用Stable-ts 在大规模数据上构造 token 级时序标签,再通过 Stable-ts 与 MFA 的交叉验证筛出高置信度子集,用于最终的局部控制微调。这个高置信度子集最终保留下来共 230.72 小时 语音。
第三,是做零值校正。这个设计非常关键。停顿值会附着在每个token 位置上,而其中很多位置的停顿本来就应该是 0。如果模型把这些 0 也编码成带偏向的残差信号,这种信号就会在整句里被密集叠加,让模型过度依赖停顿分支,反而削弱对内容时长的精细控制。为了解决这个问题,MAGIC-TTS 在时长分支和停顿分支都做了零值校正,使真实数值 0 不再额外贡献时序残差。这样一来,0 才不会给整句引入无意义的偏置,也能给内容时长控制留下更清晰、更稳定的学习信号。论文的设计部分和消融实验都说明,这一步对于平衡“停顿控制”和“字级内容时长控制”是关键的。
⏩实验结果说明了什么?
我们从高置信度B@150 子集中随机采样了 100样本作为测试集,并比较spontaneous 和 controlled 两种模式。结果显示,当提供显式 token 级内容时长与停顿控制后,内容时长 MAE 从 36.88 ms 降到 10.56 ms,停顿 MAE 从 18.92 ms 降到 8.32 ms;同时,内容时长相关性从 0.588 提升到 0.918,停顿相关性从 0.283 提升到 0.793。这说明 MAGIC-TTS是在按照给定的局部目标组织语音时序。
值得强调的是,这里面最难的并不是停顿控制,而是内容时长控制。因为后者要求模型直接改变token 内部的声学实现,而不是仅仅在边界插入静音。论文中内容时长 MAE 的大幅下降,说明系统学到的并不只是会停顿,而是更有价值的会控字。
在基于真实应用场景设计的局部编辑任务中,baseline 内容时长目标为 170 ms,实际平均实现为 171.07 ms;编辑后内容平均值达到 207.40 ms,目标为 225 ms,平均绝对偏差为 17.60 ms。停顿方面,编辑目标为 260 ms,编辑后平均实现达到 236.67 ms,平均绝对偏差为 23.33 ms。
⏩为什么我们认为这项能力很重要?
过去很长一段时间里,TTS 主要解决的是能不能说得自然;但在许多真实应用场景里,用户真正关心的是另一类问题:关键字能不能被单独拉长?关键边界能不能被清楚停出来?这种控制能不能稳定、可复现,而且不牺牲自然度?
从这个角度看,MAGIC-TTS 提供的是一种更贴近实际应用的接口。无论是导航播报、儿童跟读、验证码播报,还是无障碍朗读、车载交互、智能客服,凡是对局部节奏有要求的语音场景,都有望从这种能力中受益。
👓作者介绍
麦家龙,华南理工大学数字孪生人重点实验室,研究方向:语音合成/语音大模型等。
联系方式:eejlmai@qq.com
邢晓芬*(通讯作者)
