
 语音小管家
今天,小米发布MiMo-V2.5-TTS Series与MiMo-V2.5-ASR—— 一套面向 Agent 时代的全链路语音模型系列,覆盖识别与合成两大核心能力,让语音的输入与输出都可以被语言自由调度。
MiMo-V2.5-TTS Series 包含三款模型,现已登陆小米MiMo开放平台,并且限时免费。三者共享统一的风格指令遵循、音频标签控制与文本理解能力,让声音表现可以被语言精细调度,分别覆盖三种典型创作需求:
MiMo-V2.5-TTS:内置多款高质量精品音色,支持语速、情绪、语气等精细化控制,开箱即用,满足多场景表达。
MiMo-V2.5-TTS-VoiceDesign:一句话快速定义并生成全新音色,让音色创作更直观、更高效。
MiMo-V2.5-TTS-VoiceClone:少量样本高保真复刻目标音色,同时保持稳定的风格指令遵循与音频标签控制能力。
MiMo-Studio 快速体验地址:https://aistudio.xiaomimimo.com/#/c
MiMo-V2.5-ASR 正式开源。模型在中英双语、中文方言、Code-Switch、强噪音、多说话人等复杂真实场景下的语音识别性能达到业界领先水平,为 Agent 提供清晰可靠的语音转写,确保每一次交互都建立在精准的理解之上。
MiMo-V2.5-TTS:让声音,成为每个人的创造力
核心能力
精准的风格指令遵循能力
从简短的单句指令,到一整份导演笔记,模型都能稳定理解并遵循,覆盖情绪、语气、语速、发声方式、语言风格等多个维度。指令不必写成结构化参数——像给演员说戏一样把想要的感觉描述出来,模型就会落到对应的演绎之中。
对于一致性要求更高的场景——有声剧、游戏 NPC、角色化对话等——模型还支持导演剧本级的结构化输入:把人物、场景、详细指导分层描述,各层按自己的节奏独立更新、自由组合。这种分层既让角色的音色身份贯穿始终,也让每一句话的表演都能被单独控制。
灵活的音频标签控制能力
除了段落级的自然语言指令,模型还支持行内音频标签,用于在文本特定位置精准控制情绪、状态或风格。标签支持中英双语和开放文本描述,允许在同一段文本中灵活混用。从简单的情感标注,到多标签叠加、细粒度排布的复杂编排,模型都能稳定表达,在标签的表达力和组合稳定性上均有出色表现。
丰富的文本理解能力
即便没有任何 prompt,也没有任何标签——就是一段最普通的文本——模型也能直接表现出其中的韵律与情感。标点的停顿、句式的起伏,会被自然呈现;文本中暗藏的情感弧线,从平静叙述到激烈转折,模型能主动捕捉;甚至连字里行间透露出的说话人身份(年龄、气质、角色类型),也会自动落到声音里。换句话说:最朴素的纯文本,交给它,也能还你一段有血有肉的演绎。
模型系列
MiMo-V2.5-TTS
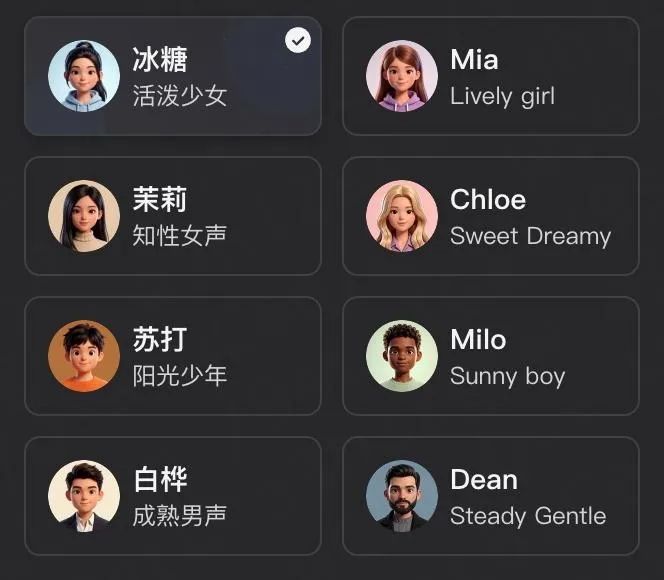
内置多种精品音色,涵盖多种使用场景,每个音色都经过专业调优,发音自然、情感贴合,开箱即享高质量语音合成。
欢迎大家到Xiaomi MiMo Studio进行音色试听:https://aistudio.xiaomimimo.com/#/c
MiMo-V2.5-TTS-VoiceDesign
音色设计面向的是"我心里有一个声音,但世界上还没有"的场景:游戏 NPC、动画角色、虚拟主播、品牌 IP、有声剧的非典型嗓音——这些都很难直接从音色库中挑选,也不适合用真人克隆。
该模型支持通过自然语言描述从零生成一款全新音色,无需任何参考音频。用户可以自由使用年龄、性别、口音、音质、发声方式、性格气质等任意描述维度——比如"一位年迈的东欧裔学者,低沉、略带嘶哑,说话节奏缓慢"或"元气满满的少女,声线清脆,语尾带一点上扬"——模型即可合成对应的角色音色。
得益于大规模预训练,模型对复杂、模糊、甚至相互矛盾的描述也能合理解读,而不局限于"男/女/青年/老年"这类粗粒度标签。这让音色设计不仅能生成真人不易提供的独特嗓音,也能精确复现某一类型化的角色声线。
MiMo-V2.5-TTS-VoiceClone
音色克隆用于让模型用你指定的声音说话——复刻一位真人播客、配音演员、品牌代言人,或者用户本人。
只需提供一段短至数秒的参考音频,无需任何额外的训练、标注或微调过程,模型就能直接复刻出说话人的音色并立即可用。复刻后的声音不仅保留了原始说话人的音色身份,也保留了气息、节奏、习惯性停顿等个人特征。
克隆得到的音色可复用本系列模型的全部控制能力——自然语言指令、音频标签、导演剧本级脚本都能继续叠加使用。复刻的声音不仅"像原人",也能按你给定的风格与情绪去演。
MiMo-V2.5-ASR:听懂你的每一次表达,无论多复杂
如果说 TTS 是在“输出”端让声音成为创作工具,那么 ASR 就是在“输入”端为这一切打开大门。在真实场景下,语种切换、背景噪声、说话人带着浓重的方言口音,在这样的环境里还能听清、听准,才是真正好用的语音识别。
MiMo-V2.5-ASR 作为全链路语音模型系列的听觉基座,在中英双语、中文方言、Code-Switch、强噪音、多说话人、高知识密度等复杂真实场景下均达到业界领先水平。它不只是为了把清晰的语音转成文字,更是让 Agent 在嘈杂的真实声音里,抓住每一个值得被理解的字词。
核心特点
中文方言:支持吴语、粤语、闽南语、四川话等方言
英文复杂场景:在 AMI 等复杂英文场景 Open ASR Leaderboard 上达到领先水平
Code-Switch:中英 Code-Switch 语音转录自由流畅,无需预设语种标签
歌曲识别:中英文歌曲歌词识别,在伴奏与人声混合场景下保持高精度
强噪音场景:在高噪音、远场拾音等复杂声学环境中保持鲁棒识别
多说话人:支持多人交叉对话场景的准确转录,如会议场景
强知识关联:古诗词、专业术语、人名、地名等知识密集型内容的精准识别
原生标点:结合语音韵律与语义原生输出标点,转写结果即拿即用,无需后处理
性能表现
MiMo-V2.5-ASR 在中英文通用、中文方言、Code-Switch 及歌词识别等多个维度上均取得当前最优或极具竞争力的结果,展现出跨场景、跨语种的稳定优势。以下为代表性评测结果:
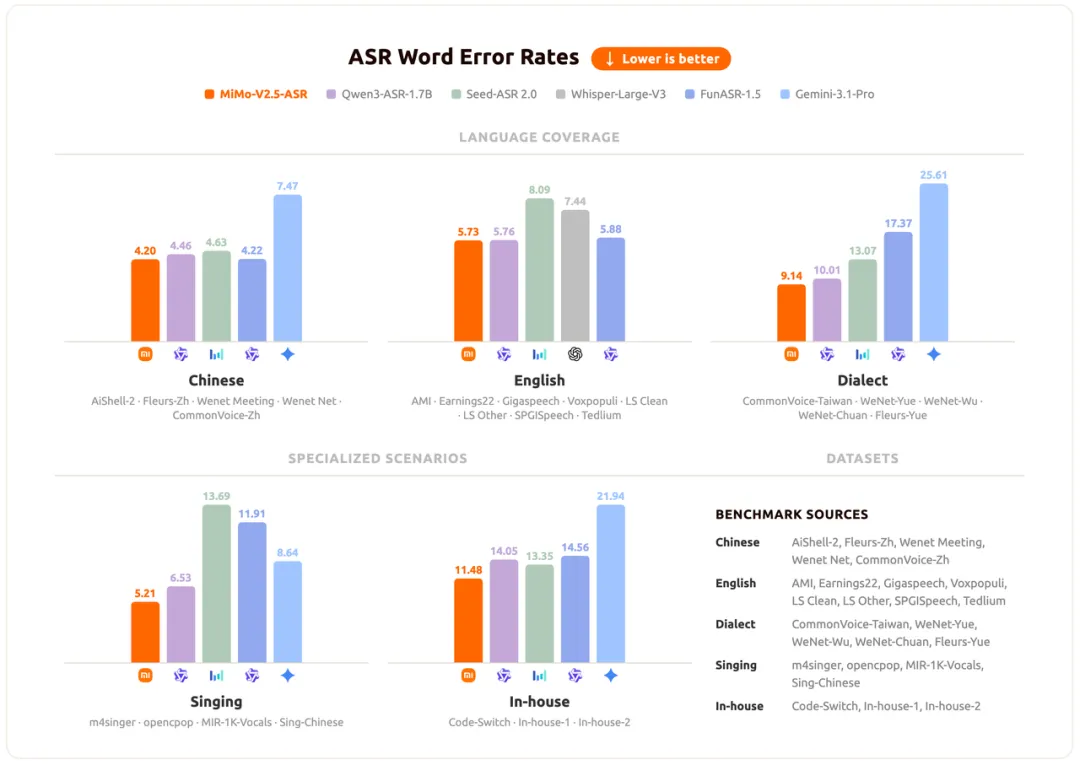
对于 Agent 应用、内容创作工具、会议系统、语音交互产品而言,这是一个真正在复杂真实世界语音中经过验证的听觉基座。
如何使用
MiMo-V2.5-TTS 系列
为助力开发者探索更多场景,MiMo-V2.5-TTS、MiMo-V2.5-TTS-VoiceDesign、MiMo-V2.5-TTS-VoiceClone均在Xiaomi MiMo API开放平台限时免费:
https://platform.xiaomimimo.com/docs/usage-guide/speech-synthesis-v2.5
同时,欢迎大家到Xiaomi MiMo Studio进行快速体验:
https://aistudio.xiaomimimo.com/#/c
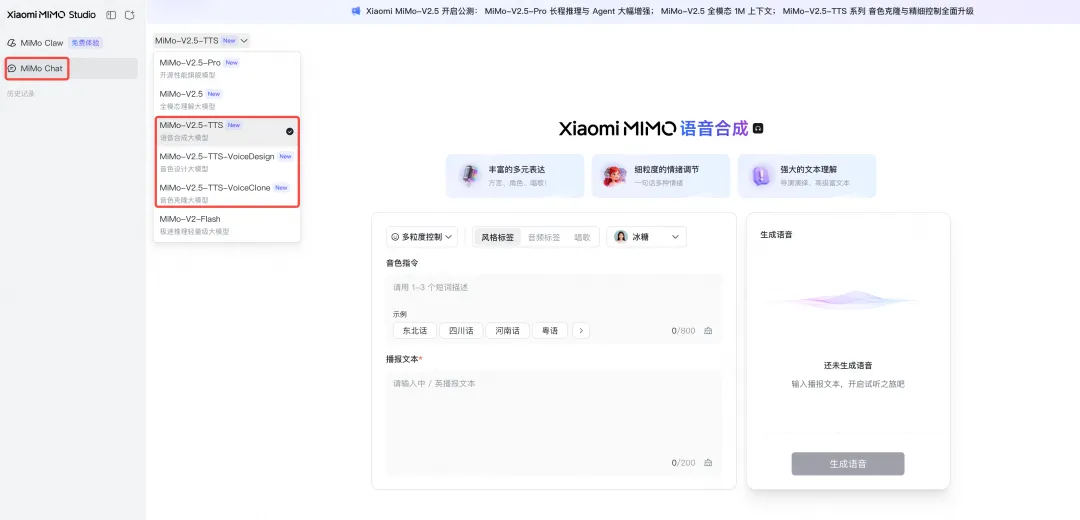
更多case请见:https://mimo.xiaomi.com/mimo-v2-5-tts
MiMo-V2.5-ASR
MiMo-V2.5-ASR 目前已开源模型权重和代码,支持开发者和研究者直接使用或二次开发。
Demo page: https://mimo.xiaomi.com/mimo-v2-5-asr
项目开源地址:https://github.com/XiaomiMiMo/MiMo-V2.5-ASR
权重开源地址:https://huggingface.co/XiaomiMiMo/MiMo-V2.5-ASR
Huggingface space: https://huggingface.co/spaces/XiaomiMiMo/MiMo-V2.5-ASR
Agent 工具调用支持
为方便大家将语音能力快速集成至 Agent 应用中,我们已将 MiMo-V2.5-TTS 相关模型的接入 Skill 全面开源。欢迎前往仓库拉取使用:https://github.com/XiaomiMiMo/MiMo-Skills
声音,只是起点
在 MiMo-V2.5-TTS Series 之外,我们更想回答一个问题:
当 MiMo-V2.5-TTS 懂“表达”、MiMo-V2.5-Pro 懂“规划”、MiMo-V2.5 懂“聆听”,音频创作会变成什么样?
答案是:一条完整、可闭环的Agent式创作链路。
MiMo-V2.5-Pro —— 规划与编剧,拆任务、写剧本、排节奏、决定剪辑顺序。
MiMo-V2.5-TTS Series —— 音色与素材,Voice Design 生成音色、Voice Clone 合成内容。
MiMo-V2.5 —— 听回与评价,听角色一不一致、节奏对不对、有没有跟用户初衷偏离。
Next step
更大规模的语音预训练与强化学习后训练:
MiMo-V2.5-TTS-Series 证明了大规模预训练与后训练的巨大收益,扩大这两者的规模:通过更多的数据、更大的模型、更强的算力,让更强大的语音智能从规模中涌现;更加精细的奖励建模与强化学习算法,推动模型迈向更高阶的语音表达智能。
通用音频生成:
语音只是第一步。我们正在将能力扩展到更广义的音频生成:环境音效、动作声、氛围铺底,乃至短乐句与旋律片段——逐步建模出一个完整的声音世界。我们相信,真正的通用音频模型,不是把语音、音效、音乐简单拼在一起,而是让它们在同一套空间里彼此理解、协同创作。
上下文理解能力:
语音表达从来不是孤立的句子游戏。人之所以能“读对”,是因为理解上下文——知道前面发生了什么,明白当前这句话在整个叙事中处于什么位置。上下文理解意味着模型不再只是一个“逐句执行的工具”,而是一个懂得故事语境的表达者。这是我们迈向真正通用语音智能的关键一步。
通用语音理解能力:
我们的目标是,让方言、噪音、中英混杂这些“真实世界的常态”不再成为语音识别的短板。未来,我们将持续扩展更多方言覆盖、并深化上下文感知能力,让语音识别从“转写”走向“理解”。
