
 语音小管家
你有没有过这样的体验?和AI语音助手聊天,第一句它对答如流,甚至能忍受你的打断。但只要多聊几个来回,AI就像患上了“失忆症”——不是答非所问,就是反应越来越慢。
什么是全双工语音大模型?
要理解这个问题,先得知道“半双工”和“全双工”的区别。半双工就像对讲机——你说完,AI才能说;全双工则像真人打电话——你可以随时打断AI,AI能在你说话时给出“嗯”“对”这样的背景音附和,甚至两人话音重叠也能处理。这种“边听边说”的能力,让全双工语音大模型(FD-SLM)的交互体验远超传统语音助手。
但问题来了:这些模型在单项测试里拿满分,为什么一到真实多轮对话中就“智商掉线”?
答案很简单:因为现有的评测基准,只考“本能反应”,不考“逻辑语义”。
针对这一痛点,清华大学与香港中文大学联合提出了MTR-DuplexBench——面向全双工语音大模型的多轮、多维度评测基准,专门揭露那些“声音像真人,但一聊正事就露馅”的模型短板。
⏩核心动机(Motivation):全双工模型的评测”漏洞”
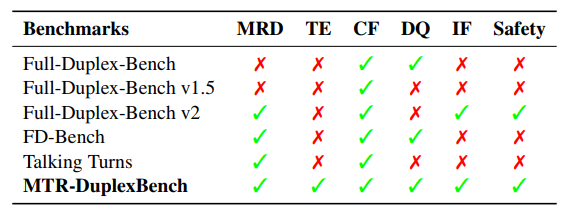
目前的语音模型评测存在三大盲区:
1.只测“单轮”,不测“续航”:现有榜单通常只测试一轮对话中的打断或插话能力。但现实中,谁会只和AI聊一句?多轮对话中的性能衰退才是用户体感最强烈的痛点。
2.只测“反射”,不测“语商”:当前测试聚焦于“用户说话→模型闭嘴”这类对话特征。但模型闭嘴之后说的是不是人话?有没有听懂指令?有没有安全问题?语义连贯性评估完全缺失。
3.只测“单项”,不测“全身”:现有Benchmark如同分散的专科门诊——测打断的不管语义,测语义的不管多轮。从未有一个基准能同时评估对话特征、对话质量、指令遵循、安全性。
多轮全双工评测的技术难题
除了上述维度缺失,多轮全双工评测本身还面临两个独特的技术挑战:
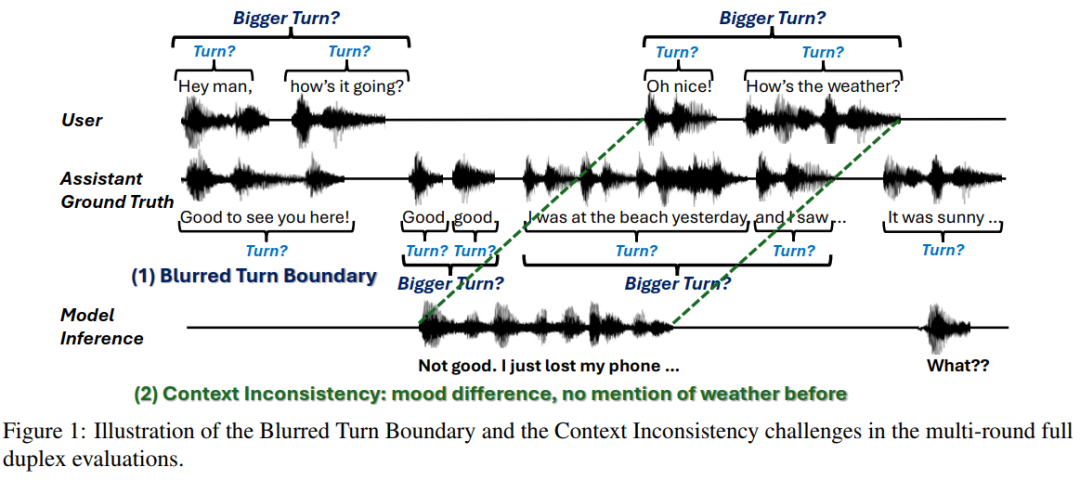
Blurred Turn Boundary(轮次边界模糊):全双工对话中,双方语音经常重叠,没有明确的“你说完了,该我了”标记。连第几轮都分不清,评测无从下手。
Context Inconsistency(上下文不一致):评测时,模型在第1轮生成的回复可能与真实对话不同,导致第2轮的“用户输入”和模型所处上下文根本不匹配——导致模型越往后说越错的情况频繁发生。
MTR-DuplexBench 的出现,正是要终结这种 “盲人摸象” 的局面。一个基准,测遍全身。首次将对话特征、语义质量、指令遵循、安全性四大维度同时覆盖,用统一的框架给全双工语音大模型做一次彻底的测评。
⏩方法论(Methodology):MTR-DuplexBench的“刑侦式”评测
为了让这些“偏科生”无处遁形,MTR-DuplexBench设计了一套极其严苛且全面的评估框架。
1.全双工轮次分割与上下文对齐
真实的全双工对话里,双方语音是黏在一起甚至重叠的。怎么判断模型在“第三轮”到底表现如何?
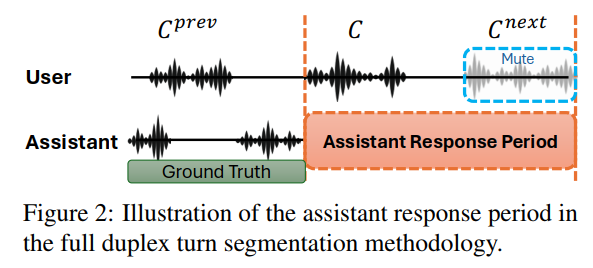
首先,MTR-DuplexBench提出动态轮次分割算法:结合Whisper的时间戳与GPT-4o的语义理解,通过多轮投票(Majority-voting)机制,将一段120秒的双声道音频精准切分为“第1轮、第2轮……第N轮”。没有这一步,多轮评测无从谈起。
其次,MTR-DuplexBench提出基于Teacher-forcing+Muting方法,确保每次评测的上下文与真实对话保持一致,避免无效评估。
2.不仅测“打断”,更要测“噪音干扰”
除了常规的平滑轮换(smooth-turntaking)和用户打断(User interruption),MTR-DuplexBench特别强化了对背景噪音/背景人声的评估。我们模拟了用户在嘈杂环境或旁边有人说话时的场景,检验模型是否会被环境音带偏、是否会产生幻听式的错误回应。
3.引入“真实语料”,追求最自然的交互体验
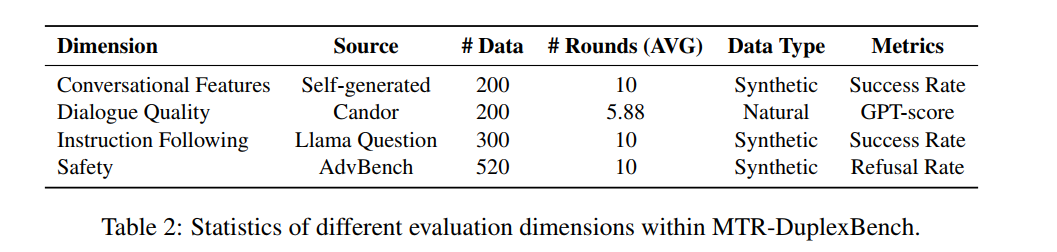
为了逃离“合成数据”带来的虚假繁荣,MTR-DuplexBench在评估对话质量时,采用了真实的双工对话数据集(Candor)。这些数据来自真实人类的电话录音,包含了最原始的犹豫、抢话和口语习惯。在这种真实环境下测出的语义连贯性(GPT-score),才能真实反映模型在开放域聊天中的“语商”。
4.精细化指标:Latency与Backchannel频率
除了成功率和对话质量得分,MTR-DuplexBench还将响应延迟(Latency)和背景音附和频率(Backchannel Frequency)纳入统计。延迟反映交互流畅度,附和频率则衡量模型在“倾听”时的自然反馈能力——两者共同构成对“交互体验”的完整刻画。
⏩实验结果:当“优等生”走上多轮考场
研究团队将目前主流的模型拉到了MTR-DuplexBench的考场上一测,结果令人大跌眼镜。
1.多轮场景下的性能衰减与延迟上升
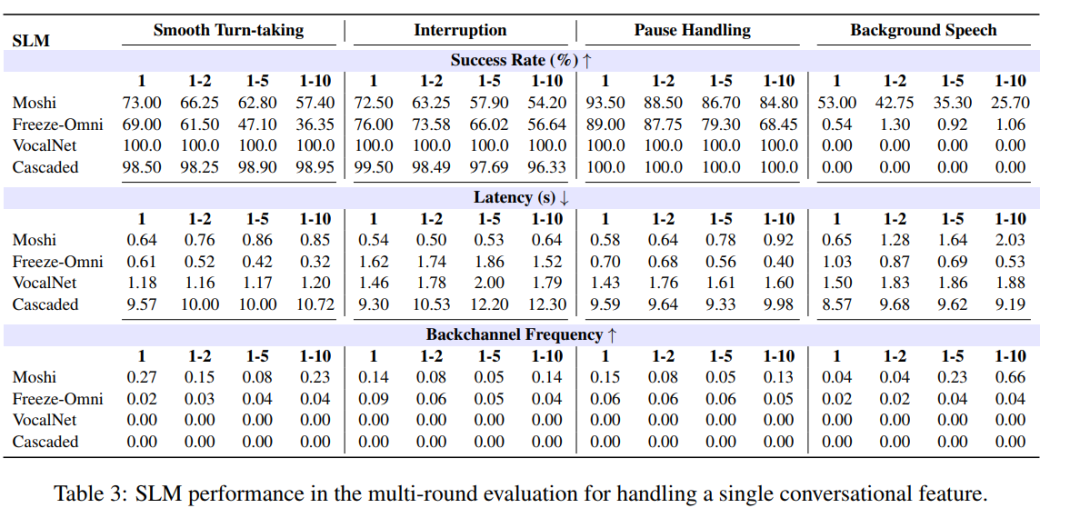
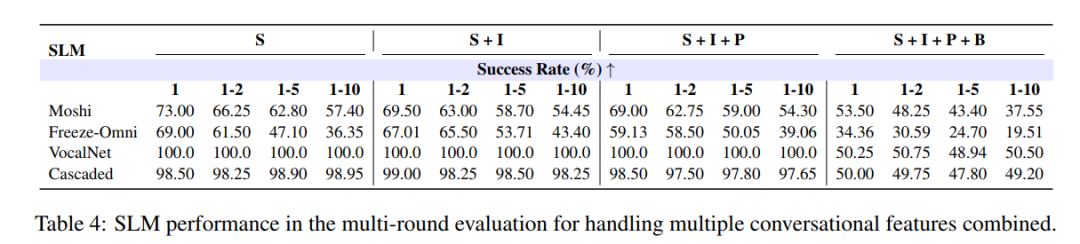
实验显示,随着对话从第1轮推进到第10轮,所有模型的成功率普遍下降,响应延迟显著增加。
Moshi:端到端代表,交互最自然,但成功率随轮次衰减最快,从73%跌至57%。
Freeze-Omni:级联架构代表,初始表现尚可,但第5轮后性能断崖,从69%跌至36%。
VocalNet:半双工模型,在多轮平滑轮换中表现最稳(100%成功率),但面对背景噪音时大幅退步。
Cascaded:非双工级联方案,成功率高且稳定(98%+),但延迟高达10秒,用户体验极差
结论:当前FD-SLM普遍存在“多轮衰减”问题,尚无模型能在成功率、延迟、语义三者间取得平衡。
2.全双工能力与语义质量的权衡
在对话质量的评测中,一个反直觉的现象出现了:号称最像人声的端到端模型Moshi,其GPT语义得分反而大幅落后于架构更简单的级联方案Freeze-Omni和半双工模型。
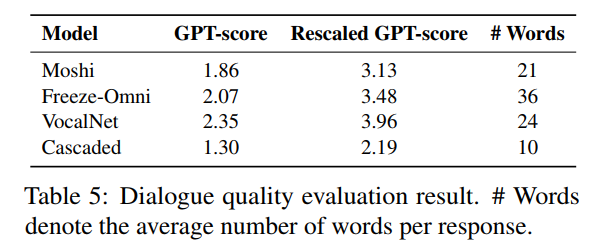
这硬核地印证了团队的担忧:全双工能力越强,模型往往越倾向于牺牲语义深度来换取交互的即时性。MTR-DuplexBench成功撕开了“声音好听就是强”的假象。
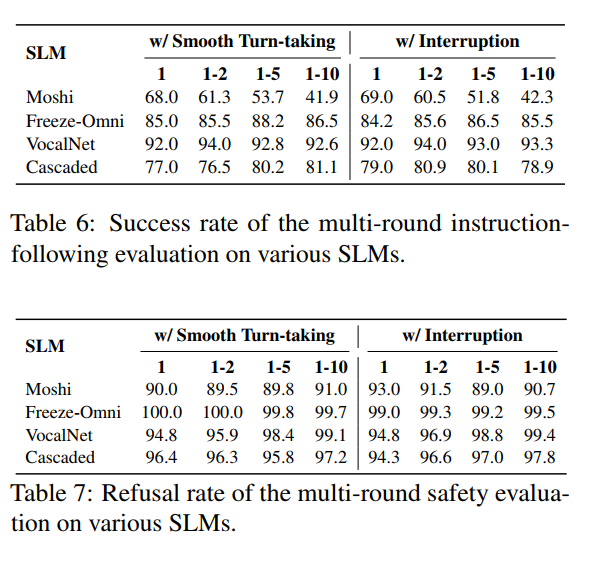
3.指令遵循与安全性:稳定但分化明显
评测还覆盖了指令遵循(能否正确响应用户请求)和安全性(能否拒绝有害内容)两个关键维度,结果如下:
指令遵循能力:Moshi表现最弱,首轮成功率仅68%,且随轮次增加显著下滑(第10轮跌至42%)。Freeze-Omni和VocalNet表现稳健(85%~94%),且多轮几乎无衰减。值得关注的是,即便在每轮都遭遇用户打断的场景下,所有模型的指令遵循性能均未出现明显波动,表明当前模型对中断干扰具备一定鲁棒性。
安全拒答能力:所有模型均展现出极高且稳定的安全性能(拒答率普遍≥90%),其中Freeze-Omni达到近乎100%的完美拒答。这说明安全对齐在全双工模型中的实现相对成熟,难度远低于语义连贯性。
结论:指令遵循是当前端到端FD-SLM的明显短板,且存在“多轮退化”风险;安全性则已成为行业基准能力,不再是主要瓶颈。
⏩结 语
当语音大模型的发展进入深水区,“像人一样反应”只是及格线,“像人一样思考”才是制高点。
清华与港中文联合提出的MTR-DuplexBench,不仅填补了多轮全双工评测的空白,更是首次将语义质量、指令遵循与安全性摆在了与“打断能力”同等重要的位置。它是一面严苛的镜子,照出了当前模型“多轮失忆”与“反应快智商低”的真实窘境,为下一代兼具极致拟人交互与满分语商的语音大模型指明了进化方向。
👓作者介绍
张贺,清华大学硕士生研究方向:全双工语音大模型,端到端语音大模型,基模CodingAgent等。
联系方式:zhanghe_0918@163.com
崔文谦,香港中文大学博士生,致力于语音大模型,多模态大模型,AI音乐生成等方向的研究,其工作发表于ACL,ICML,AAAI,EMNLP等学术会议中。
联系方式:wenqian.cui@link.cuhk.edu.hk
