
 语音小管家
本次分享内容为内蒙古大学23 级硕士研究生 鲜鹄鸿、内蒙古大学刘瑞教授与美国约翰霍普金斯大学 Berrak Sisman、香港中文大学(深圳)/河套学院 李海洲教授合作发表于 APSIPA ASC 2025 的工作《NE-PADD: Leveraging Named Entity Knowledge for Robust Partial Audio Deepfake Detection via Attention Aggregation》。
当伪造音频隐藏在真实语音中进行片段篡改,帧级别的局部音频伪造检测(PADD)成为守护声音真实的新挑战。现有PADD方法多聚焦声音的表层特征,忽视了一种关键信息——命名实体(Named Entity, NE)信息。
NE信息对PADD的重要性不言而喻:伪造者往往会篡改语音中最关键的部分,而这些关键部分大多包含NER信息(比如人名、地名等核心信息点)。这类关键信息具有明确的含义和连贯性,一旦被篡改,很容易出现语义不连贯的问题,这种问题仅靠分析声音表层特征很难发现。如果缺乏NE信息的帮助,检测模型就像“抓不住重点”,难以精准找到伪造片段,因此融入NE信息,是实现精准检测的关键前提。简单来说,NE就是从语音中提取出的关键信息点,能帮模型快速抓住语音的核心含义。
为此,我们提出NE-PADD方法,通过双分支设计,一边提取语音中的NER关键信息,一边进行伪造定位,再通过两种注意力聚合机制,让模型重点关注含关键信息的片段、读懂语音核心含义,最终实现帧级精准伪造定位。
0、Abstract
不同于传统的句子级语音深度伪造检测任务,局部语音深度伪造检测要求在帧级别定位伪造语音所在的位置。尽管该方向已经取得了一些进展,但如何利用语音中的语义信息,尤其是命名实体信息,仍然缺乏充分研究。为此,我们提出了一种新方法 NE-PADD。该方法通过注意力聚合机制,引入命名实体知识,以实现更鲁棒的局部语音伪造检测。NE-PADD 由两个并行分支组成,分别是语音命名实体识别分支 Speech Named Entity Recognition,简称 SpeechNER,以及局部语音伪造检测分支 PADD。具体来说,我们提出了两种注意力聚合机制,帮助 PADD 模型更好地理解命名实体知识,从而获得更强的检测性能。
(1)Attention Fusion,简称 AF,将 SpeechNER 与 PADD 的注意力进行融合,以得到更加准确的权重。
(2)Attention Transfer,简称 AT,利用两个注意力分布之间的辅助损失,引导 PADD 学习命名实体语义信息。
此外,我们基于现有的 PartialSpoof 数据集构建了 PartialSpoof-NER 数据集,并对两种注意力聚合方法进行了详细对比分析。实验结果表明,我们的方法优于多种先进基线,同时验证了在局部语音伪造检测中融合命名实体知识的有效性。
1、Introduction
近年来,深度学习极大推动了语音伪造技术的发展,尤其是在文本转语音和语音转换领域 [1]–[7]。借助 CosyVoice 和 GPT-SoVITS 等生成模型,当前的文本转语音和语音转换系统已经能够生成接近真人水平的合成语音,使其几乎难以与真实语音区分开来 [8]–[11]。局部伪造语音是指将合成语音片段插入或拼接到真实语音中,这类攻击具有显著风险。攻击者只需操纵一些较小的语音单元,例如单词、字符,甚至音素,就可以改变整句话的含义,从而欺骗人类和机器。因此,如何有效检测和抑制这类伪造语音已经成为一个关键而紧迫的问题。
当前,围绕局部语音伪造检测已经出现了许多方法和数据集。RawNet2 [12] 通过 Sinc-Layer 和残差模块处理原始音频,用于高效的局部语音伪造检测。AASIST [13] 结合了基于 RawNet2 的编码器和 RawGAT-ST,利用图注意力层联合建模时域和频域特征。Yi 等人 [14] 构建了首个局部伪造语音数据集 HAD,在该数据集中,部分自然语音片段被替换为具有不同语义内容的合成语音片段。Zhang 等人 [15] 提出了 PartialSpoof 数据集,用于为语音伪造检测提供片段级标签。在此基础上,他们进一步探索了一个能够同时识别片段级和话语级伪造的多任务学习框架 [16]。随后,他们又在这项工作基础上进行了扩展,并引入 Wav2Vec2 作为前端特征提取器,以实现片段级和话语级伪造的联合检测 [17, 18]。
尽管现有方法在局部语音伪造检测方面已经取得了显著进展,但伪造片段往往出现在包含命名实体的语音部分。以往的 PADD 方法虽然取得了一定效果,却往往忽视了语义信息,尤其是命名实体的作用。事实上,命名实体在 PADD 中具有非常重要的作用。例如,在日常语言中,局部深度伪造往往表现为替换句子中的一个或多个命名实体。以 “CompanyX CEO heads a meeting in their Shenzhen office.” 为例,其中 “CompanyX” 是组织名,“Shenzhen” 是地名。如果这些实体被替换或篡改,就可能形成局部伪造,而这类伪造往往难以被传统方法检测出来。因此,命名实体的变化对于 PADD 至关重要。并且,一些局部伪造数据集,例如 HAD,本身就是通过替换命名实体构建的,这也进一步说明命名实体在局部深度伪造任务中的核心地位。
为了解决上述问题,我们提出了 NE-PADD,这是一种通过两种注意力机制将语音中的命名实体语义信息引入检测过程的新型局部语音伪造检测框架。同时,我们还提出了 PartialSpoof-NER 数据集,即在 PartialSpoof 基础上加入命名实体标注的数据集。大量实验表明,NE-PADD 在等错误率等关键指标上优于现有方法,并为局部语音伪造检测建立了新的性能基线。本文的主要贡献如下。
1) 提出了一种新模型 NE-PADD,通过注意力机制将语音中的命名实体语义信息引入深度伪造检测模型。
2) 设计了一种融合 SpeechNER 与 PADD 特征提取模块的方法,以学习注意力权重并提取中间特征用于伪造检测。本文利用 Attention Fusion 和 Attention Transfer 提取语音命名实体中的语义信息,从而提升检测性能。
3) 构建了新的 PartialSpoof-NER 数据集,在 PartialSpoof 的基础上加入命名实体标注,为伪造语音检测提供语义线索。
2、RDD-ADD: Methodology
2.1、Dual-Database Retrieval Store Preparation
在局部伪造场景中,伪造语音片段被嵌入到真实语音中。本文的目标是在帧级别检测这些伪造片段。给定大规模自监督声学特征:
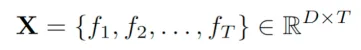
其中,D 和 T 分别表示特征维度和帧数。该任务被建模为帧级二分类问题,对于每一个输入特征 X,输出是一系列帧级标签:
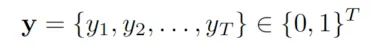
其中,yt= 1 表示真实帧,yt= 0 表示伪造帧。由于伪造片段通常较短且位置局部化明显,因此实现精确的边界检测具有较大挑战。
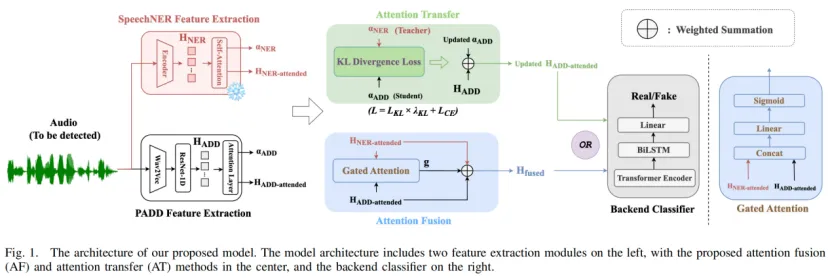
在本文提出的模型中,Attention Fusion 方法首先通过 Gated Attention 模块生成门控注意力权重,然后将其应用于两个不同的中间特征 HADD-attended和 HNER-attended,并对两者进行加权求和,得到新的融合特征 Hfused。之后,将该特征送入帧级分类器完成最终检测。Attention Transfer 方法则通过计算两个注意力分布 αADD与 αNER之间的 Kullback-Leibler 散度,并将其作为辅助损失加入主损失中,以此实现命名实体语义信息的引入。整体模型结构如图 1 所示。
2.2、PADD Feature Extraction
本文使用在 960 小时 Librispeech 语料上预训练的 Wav2Vec2.0 模型提取帧级特征,帧移为 20 ms [19]。提取后的特征进一步经过 ResNet-1D 处理。该网络由多个残差块组成,能够有效捕获音频中的时间依赖和局部模式,并输出嵌入表示 HADD,作为后续注意力机制的输入。
随后,HADD 会被送入一个注意力层,以动态关注音频中更相关的区域。注意力分数计算如下:
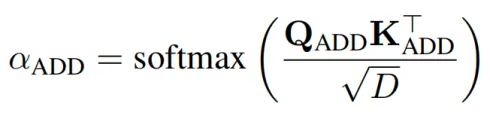
其中,αADD表示动态注意力权重,用于突出音频中可能包含伪造片段的区域。对应的注意力加权嵌入表示为:
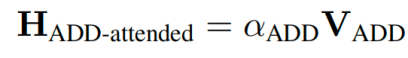
经过注意力修正后的嵌入 HADD-attended能够更有针对性地表示输入音频,突出那些更可能包含伪造片段的区域。
2.3、SpeechNER Feature Extraction
SpeechNER 特征提取模块通过在输入音频转写文本中的命名实体前后加入特殊符号来识别命名实体。考虑到中文语音命名实体研究仍然较少,本文当前实验仅限于英文数据集。本文借鉴了 Yadav 等人关于端到端英文语音命名实体识别的工作 [20],聚焦于英文语音数据中最常见的三类命名实体,即组织、人名和地点。具体而言,本文使用三种特殊符号 {'、'|'、'$' 作为不同命名实体的起始标记,并使用 ] 作为统一的结束标记。例如,对于引言中的示例句子 “CompanyX CEO heads a meeting in their Shenzhen office.”,其训练文本标签可表示为 “{CompanyX] CEO heads a meeting in their $Shenzhen] office”,其中 { 和 $ 分别表示命名实体的起始位置,] 表示实体的结束位置。整个任务被看作一个序列标注任务,其中输入音频首先被转换为对数谱图特征,使用 20 ms Hamming 窗对功率归一化后的音频片段进行处理 [20]。
SpeechNER 模块首先通过编码器处理音频中的命名实体信息。该编码器包含卷积层、归一化层以及多个双向长短时记忆网络层,用于建模音频数据中的时间依赖关系。经过这一过程后,可以得到适合进一步处理的命名实体表示 HNER,其中包含了各时间步上的上下文信息。
随后,该模块再通过自注意力机制处理这些表示,并生成实体级嵌入。经过注意力修正后的表示 HNER-attended能够突出命名实体的重要性,为语音深度伪造检测提供关键语义信息。
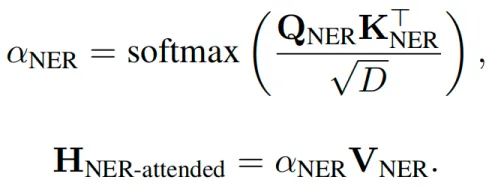
2.4、Attention Fusion
Attention Fusion 通过门控注意力策略融合 HADD-attended和 HNER-attended。具体来说,首先计算融合权重 g:
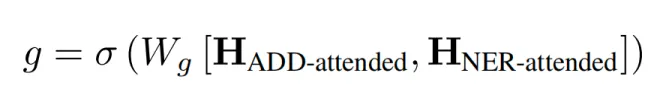
其中,σ 表示 Sigmoid 函数,[·,·] 表示拼接操作。由于经过 Sigmoid 激活,g 的取值范围被限制在 0 到 1 之间。当 g 等于 0 时,表示模型完全依赖 HNER-attended;当 g 等于 1 时,表示模型完全依赖 HADD-attended;而介于两者之间的取值则表示二者的加权组合。在此基础上,融合特征 Hfused定义为:
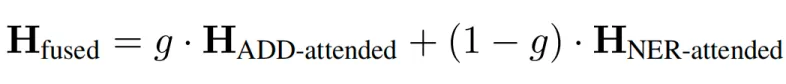
之后再输入后端分类器。
2.5、Attention Transfer
Attention Transfer 通过对齐 αADD与 αNER,实现由教师权重 αNER对学生权重 αADD的引导,使 PADD 分支能够学习语义信息。具体而言,这种对齐通过最小化两个分布之间的 KL 散度来实现:
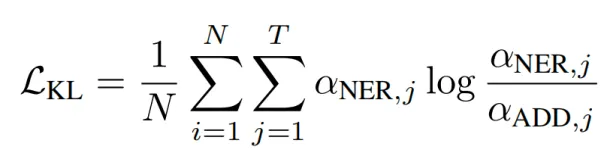
由于 KL 散度本身具有非对称性,因此本文采用教师—学生式的知识迁移方式:αNER作为教师,αADD作为学生。最小化 KL(αNER∥αADD) 可以保证语义知识从 SpeechNER 到 PADD 的单向迁移。总损失由主二元交叉熵损失与迁移损失共同组成:
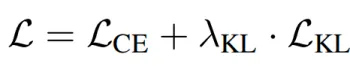
其中,λKL是平衡两者的超参数。这个新的损失函数会引导 αADD的更新,进而用于对 HADD进行注意力加权,得到 HADD-attended,并作为后端分类器的输入。
2.6、Backend Classifier
嵌入特征最终被送入帧级后端分类器进行预测。为了捕获每一帧内部更长距离的全局上下文信息,本文使用了多个 Transformer 编码器。随后,再使用 BiLSTM 对 Transformer 输出的序列嵌入进行进一步建模。最后,通过一个全连接层预测每一帧的边界概率。
3、Experiments and Results
3.1、Data Preparation
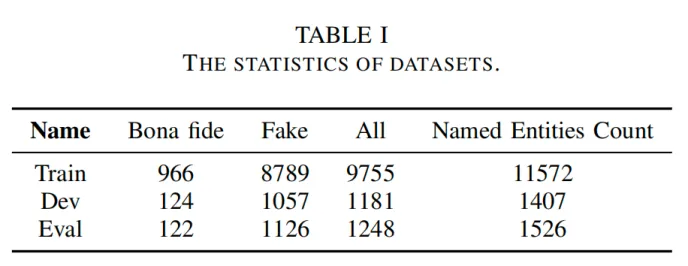
为了严格验证本文方法,我们构建了包含命名实体信息的 PartialSpoof-NER 数据集。该数据集由 PartialSpoof 数据集通过多步处理流程得到。具体来说,首先利用 Whisper 自动语音识别模型将 PartialSpoof 中的音频转写为文本 [21],然后使用斯坦福团队开发的 Stanza 工具从转写文本中抽取命名实体,最终形成带有命名实体标注的 PartialSpoof-NER 数据集。
数据集统计结果如下。训练集包含 966 条真实语音、8789 条伪造语音,共有 9755 条语音和 11572 个命名实体。开发集包含 124 条真实语音、1057 条伪造语音,共 1181 条语音和 1407 个命名实体。测试集包含 122 条真实语音、1126 条伪造语音,共 1248 条语音和 1526 个命名实体。平均来看,每条语音大约包含 1 到 2 个命名实体。
3.2、Experiment Setup
模型采用二元交叉熵损失和 Adam 优化器进行训练,共训练 100 个 epoch。训练批大小为 16,学习率为 10^-4,并使用 Noam 学习率调度器进行调整,其中 warm-up 步数为 1600 [22]。在训练过程中,我们会定期在适配集上评估等错误率,以监控模型性能。
在 NE-PADD 中,输入音频表示为 L×1,其中 L 表示音频长度。SpeechNER 特征提取模块的参数被冻结。在 PADD 特征提取模块中,输入首先经过 Wav2Vec,输出大小为 T×768,其中 T 表示时间步数。第一层一维卷积设置为 C(5,2,1),无偏置,输出大小为 T×512。之后接入 12 个残差块,每个残差块由卷积和归一化层组成,结构为 C(1,0,1),输出维度保持为 T×512。最后,再通过一个 C(1,0,1) 的一维卷积层,将输出进一步压缩到 T×128。
后端分类器使用 Transformer 编码器 E(2,4,1024),即 2 层、4 个注意力头、前馈网络大小为 1024,输出维度保持为 T×128。最后再接一个隐藏层大小为 128 的单层 BiLSTM,输出维度为 T×128,并经过 ReLU 激活,最终利用一个 256 维全连接层预测每一帧的概率。
3.3、Baselines
为了验证所提出的 NE-PADD 模型的有效性,本文将其与四种先进的局部语音伪造检测模型进行比较。
第一种是 Single reso. [18],该方法通过引入自监督学习模型和利用片段级标签的训练策略,在部分伪造场景下进行多分辨率训练。第二种是 BAM [23],该方法利用边界信息作为辅助注意力来定位局部伪造语音,并设计了双分支边界模块以提取更具判别性的帧级特征。第三种是 TDL [24],该方法结合嵌入相似性模块与时序卷积操作,有效捕获特征信息和位置信息。第四种是 WBD [19],该方法提出了一种利用片段不连续性和声学信息的帧级边界检测系统。
3.4、Metrics
本文采用等错误率 EER 作为模型评价指标,这是二分类任务中常用的标准指标。虽然本文任务是帧级局部伪造检测,但每一帧的预测结果同样可以看作二分类决策,因此 EER 在这里仍然具有代表性。EER 对应于假阳性率与假阴性率相等时的点,能够较为平衡地评估检测性能。EER 越低,表示模型区分真实帧和伪造帧的整体能力越强。
3.5、Comparison with Existing Methods
如表 2 所示,本文的 Attention Fusion 方法在 PartialSpoof-NER 数据集上取得了 7.89% 的 EER,达到了最佳性能。
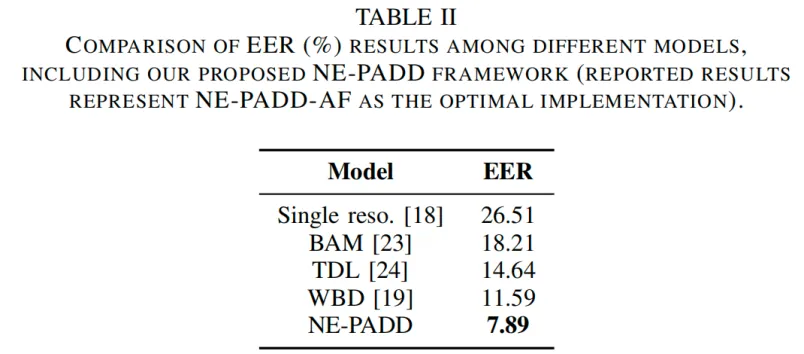
需要说明的是,NE-PADD 指的是本文整体框架,即利用命名实体语义信息增强局部语音伪造检测。在该框架下,我们探索了两种具体实现方式,分别是 NE-PADD-AF 和 NE-PADD-AT。两者都遵循利用 SpeechNER 语义权重的核心思想,但在注意力信息的融合方式上有所不同。由于 NE-PADD-AF 的实证效果最好,因此在与其他基线模型比较时,本文将其结果作为 NE-PADD 的代表性实现进行报告。
通过在 NE-PADD 框架下引入创新性的注意力融合与注意力迁移机制,模型能够更准确地捕获命名实体的语义权重,从而在局部语音伪造检测任务中取得更好的结果。
3.6、Ablation Study
为了评估语义信息对 PADD 模型性能提升的作用,本文进行了消融实验。我们将所提出的 Attention Fusion 和 Attention Transfer 方法应用到多个模型上,使这些模型能够直接从音频中学习语义信息。
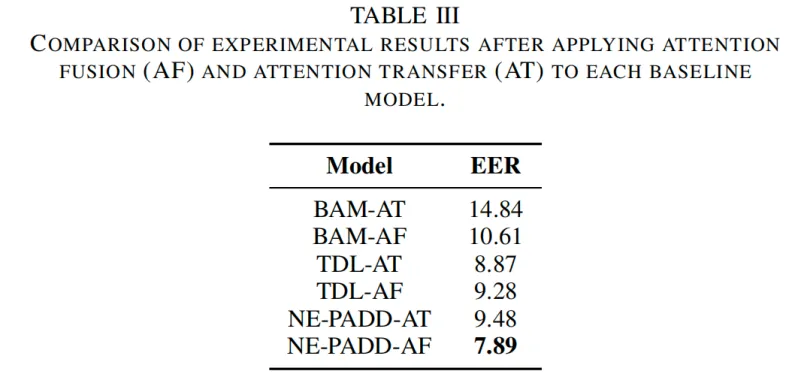
实验结果表明,相比于原始 BAM 基线,加入 Attention Transfer 和 Attention Fusion 后,EER 分别下降了 3.37% 和 7.60%。同样地,相比于原始 TDL 基线,加入这两种机制后,EER 分别下降了 5.77% 和 5.36%。这些结果说明,通过注意力机制引入语义信息,能够显著提升 PADD 模型的检测能力。
这些发现进一步说明,语义特征在识别细微音频篡改方面具有关键作用,也验证了将语义信息整合进检测框架的有效性。对于文中的 BAM-AT、BAM-AF、TDL-AT 和 TDL-AF 等命名形式,其含义分别是原始 BAM 或 TDL 基线叠加了本文提出的 AT 或 AF 机制。
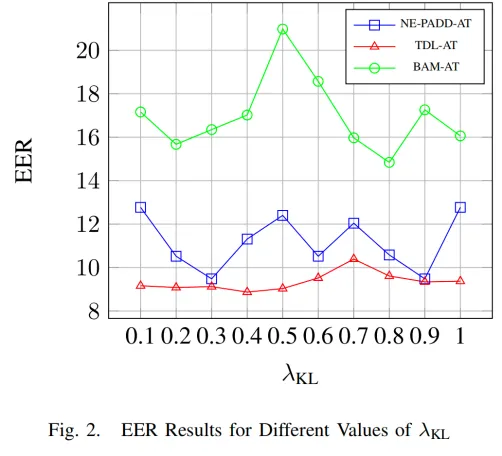
对于 Attention Transfer,我们还在三个模型上对超参数 λKL 进行了实验,取值范围为 0.1 到 1,步长为 0.1。表 3 中汇报的 Attention Transfer 结果均对应各模型的最优超参数设置。
3.7、Finer-grained Resolution Experiment
为了研究一条音频中伪造片段数量对模型检测性能的影响,我们按照伪造片段数量对现有数据集进行了划分,例如 1 处伪造、2 处伪造、3 处伪造,一直到 10 处伪造,并分别在这些子集上训练和测试模型。
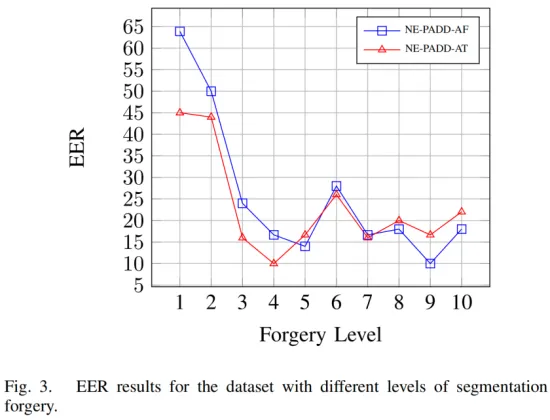
实验结果表明,尽管由于数据规模有限,这些结果可能还不能完全反映模型的泛化能力,但可以观察到,随着一条语音中伪造片段数量的增加,模型检测伪造的准确性也随之提升,这体现在更低的 EER 上。这说明伪造片段数量会对模型性能产生显著影响。
4、Conclusion
本文提出了一种新的局部语音深度伪造检测方法,并构建了新的 PartialSpoof-NER 数据集。本文模型通过两种注意力机制融合语义特征,从而提升了对细粒度语音篡改的检测能力,并在 PartialSpoof-NER 数据集上取得了当前最优性能。不过,对于极短伪造片段的检测仍然具有挑战,这将是未来工作的重点之一。由于当前数据资源仍然有限,本文模型尚未应用于中英双语局部伪造场景。未来的工作将进一步扩充数据资源,以验证模型在多语言场景下的泛化能力。
论文翻译:内蒙古大学计算机学院 2023级硕士研究生 鲜鹄鸿(导师:刘瑞教授)
排 版:贾真琦,责 编:鲜鹄鸿,审 核:刘 瑞
