
 语音小管家
你有没有想过,一首歌能不能任意改词,旋律保持不变?
想象一下这样的场景:你特别喜欢一首歌的旋律,但歌词想换成自己写的;或者你想把一首中文歌"翻唱"成英文版,旋律保持不变,歌词却是全新的英文内容。以前要做到这件事,要么得先提取MIDI,手动对齐每个字和音符后再用专业工具合成;要么遮盖需要编辑的部分,提供前后上下文,靠AI"猜"着补全,效果往往不尽如人意。
近期,西北工业大学音频语音与语言处理研究组(ASLP@NPU)联合巨人网络AI Lab,开源了YingMusic-Singer-Plus。你只需要提供三样东西:一段提供音色的参考音频(可选)、一段提供旋律的歌声片段、以及你想要的新歌词,剩下的全交给模型,不需要任何手动对齐。模型通过精心设计的课程学习策略以及GRPO强化学习优化,同时实现了对修改后歌词的高忠实度和对原始旋律的高保持度。为填补歌声编辑领域长期缺乏标准化评测基准的空白,我们同步开源了LyricEditBench——首个面向旋律不变的歌词编辑的专用基准,覆盖部分替换、完全改写、删除、插入、跨语言翻译、中英混合六种常见编辑场景,共计7,200条测试用例,支持中英双语评测。在实用性方面,YingMusic-Singer-Plus同时支持云端在线体验与本地部署,开箱即用,在单卡NVIDIA 2080 Ti上仅需10秒即可完成推理。目前模型权重与代码均已开源,以下对该技术报告进行简要的解读与分享。
论文题目:YingMusic-Singer-Plus: Controllable Singing Voice Synthesis with Flexible LyricManipulation and Annotation-free Melody Guidance
作者列表:郝春博,郑俊杰,马国斌,姜月鹏,陈华康,田文杰,陈宫煜,陈子浩,谢磊†
合作单位:巨人网络 AI Lab
论文地址:https://arxiv.org/abs/2603.24589
在线体验:https://huggingface.co/spaces/ASLP-lab/YingMusic-Singer-Plus
Github:https://github.com/ASLP-lab/YingMusic-Singer-Plus
Demo Page:https://aslp-lab.github.io/YingMusic-Singer-Plus-Demo
Hugging Face:https://huggingface.co/ASLP-lab/YingMusic-Singer-Plus
LyricEditBench:https://huggingface.co/datasets/ASLP-lab/LyricEditBench
现有方法的痛点在哪?
当前歌声编辑领域主要有两种范式:
上下文学习(In-context Learning)策略,即遮盖需要编辑的区域,以周围上下文和目标歌词为条件重新生成。这种方法操作方便,但只能处理局部片段,且对旋律的控制力有限。
基于商业SVS模型的手动对齐流水线,用户需要手动将修改后的歌词与转录得到的 MIDI 音符及时值逐一对齐,然后再重新合成音频。这种方式可控性强,但人工成本极高,尤其在跨语言翻译等场景下复杂度急剧上升。
近期也有一些工作试图缓解这些问题:Vevo2 [1] 实现了旋律可控生成,但存在歌词忠实度下降和旋律偏离的问题;SoulX-Singer [2] 支持以现有歌声作为旋律输入,但仍需手动对齐字级时间戳,核心负担并未解除。
总的来说,现有方法要么依赖上下文来"恢复"旋律,要么需要手动对齐歌词与旋律的时间戳,灵活性和可扩展性均受限。
如图1所示,YingMusic-Singer-Plus是一个全扩散(fully diffusion-based)模型,能够以 44.1 kHz 的采样率生成高保真歌声。其架构由四个核心模块组成:
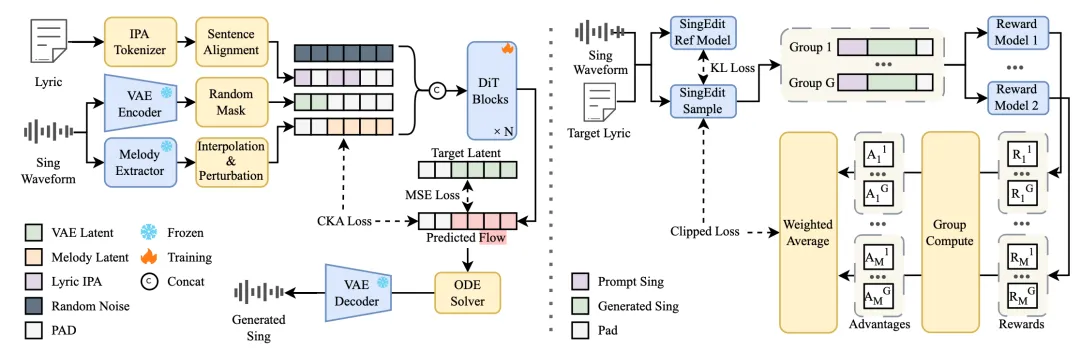
图1 YingMusic-Singer-Plus的整体架构。左图:训练流程,包含变分自编码器、旋律提取器、IPA分词器以及基于DiT的条件流匹配。右图:GRPO训练流程。
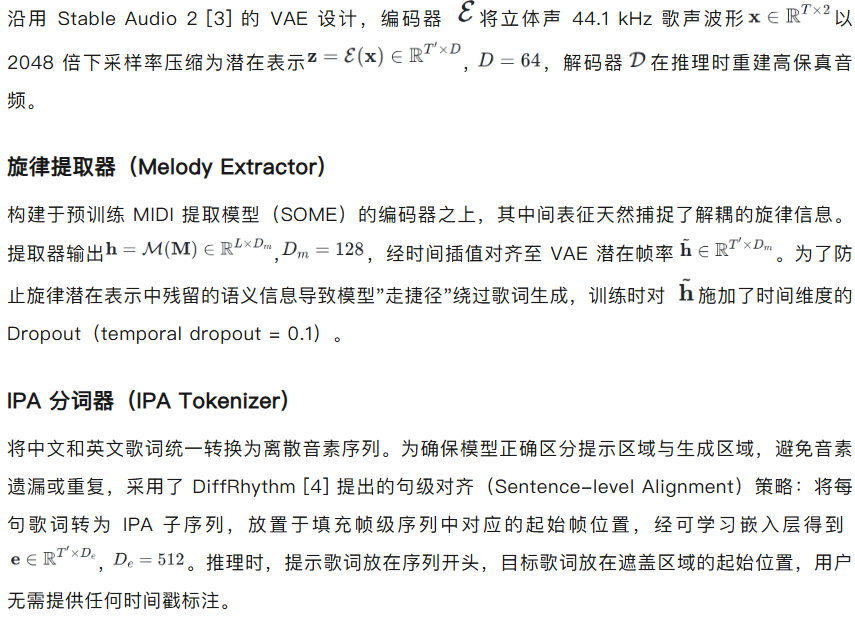
变分自编码器(VAE)
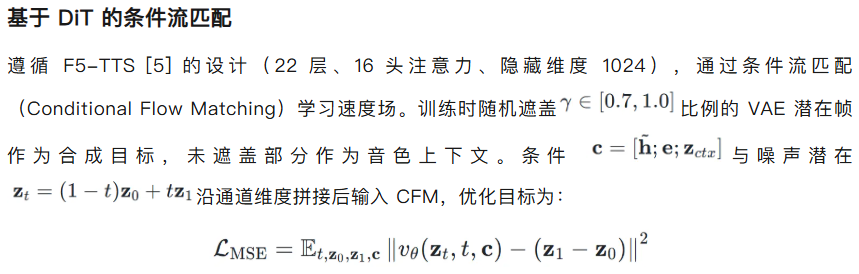
课程学习(Curriculum Training)策略
阶段一:TTS预训练:使用 Emilia 数据集的中英文子集,不启用旋律条件,让模型建立基本的发音先验知识。训练 100 万步。
阶段二:歌声监督微调 1:在歌唱数据上启用句级对齐,但仍不启用旋律条件,使模型适应歌唱域。训练 24 万步。
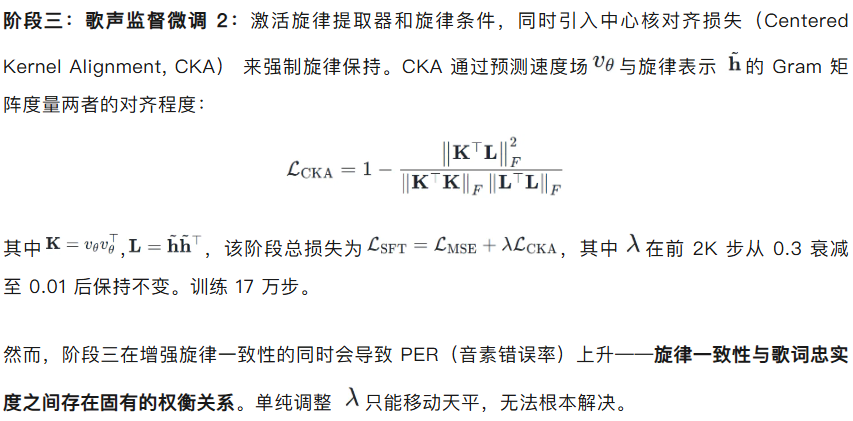
组相对策略优化
为突破上述权衡瓶颈,YingMusic-Singer-Plus引入了组相对策略优化(Group Relative Policy Optimization, GRPO)——这一最初由 DeepSeek-R1 [6] 提出用于大语言模型推理激励的方法,被创新性地应用于歌声编辑领域。
为什么选择 GRPO?
PPO需要训练额外的价值网络,代价高昂;
DPO等离线方法存在分布偏移问题,预收集的偏好数据随着策略改进会变得过时;
GRPO在线运行,通过组内奖励统计估计基线,无需价值网络,高效且稳定。
我们参考近期 Flow-GRPO [7]、MixGRPO [8] 等工作,将确定性 ODE 轨迹转换为 SDE,但将随机采样步限制在有界窗口内,确保对探索步的精确优势归因。采用M=4个等权重奖励模型联合评估(防止向单一奖励维度坍缩),每个样本的优势计算为:
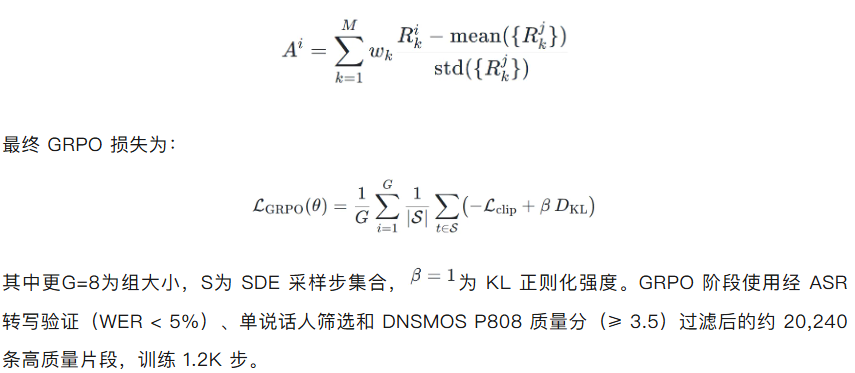
LyricEditBench:首个面向旋律一致性的歌词改编基准
技术报告还构建了LyricEditBench——首个面向旋律一致性的歌词修改评估的基准测试集,基于 GTSinger [9] 数据集构建。
表1 LyricEditBench中的歌词修改任务类型。
缩写 | 任务类型 | 描述 |
|---|---|---|
PSub | 部分替换 | 替换部分词语 |
FSub | 完全替换 | 全面改写歌词 |
Del | 删除 | 删除部分词语 |
Ins | 插入 | 插入部分词语 |
Trans | 翻译 | 中英互译 |
Mix | 中英混合 | 混合语言歌词 |
构建流程
从 GTSinger 中移除 Paired Speech Group,通过 MD5 哈希去重,排除超过 15 秒的片段。使用 DeepSeek V3.2 根据原始歌词和修改指令生成修改版本,丢弃不合规输出,得到 11,535 个有效样本。按歌手性别(男/女)和语言(中/英)分为四类,每种编辑类型每类选取 300 个样本,最终共7,200 个测试实例。每个实例包含旋律参考片段、音色提示和修改后的歌词。
实验结果
评估指标
PER(音素错误率)↓:使用 Qwen3-ASR-1.7B [10] 转写后计算音素级歌词忠实度。
SIM(说话人相似度)↑:基于 WavLM-large 提取说话人嵌入计算余弦相似度(与 F5-TTS 一致)。
F0-CORR(基频皮尔逊相关性)↑:使用 RMVPE [11] 提取 F0 轮廓,计算逐帧皮尔逊相关性。
VS(Vocal Score)↑:基于 VocalVerse2 [12] 的感知质量评分。
N-MOS(自然度MOS)↑ 和 M-MOS(旋律一致性 MOS)↑:30 名听众的 5 分制主观评分。
主要结果
如表2所示,与最直接的对比基线 Vevo2 相比,YingMusic-Singer-Plus在所有六种编辑类型、两种语言、两种任务设置(Melody Control 和 Sing Edit)下的 PER、F0-CORR 和 VS 三项指标上均取得优势:
表2 与基线模型在LyricEditBench各任务类型(表1)及各语言上的对比。各项指标(M):P:PER、S:SIM、F:F0-CORR、V:Vocal Score。最优结果以粗体标出。
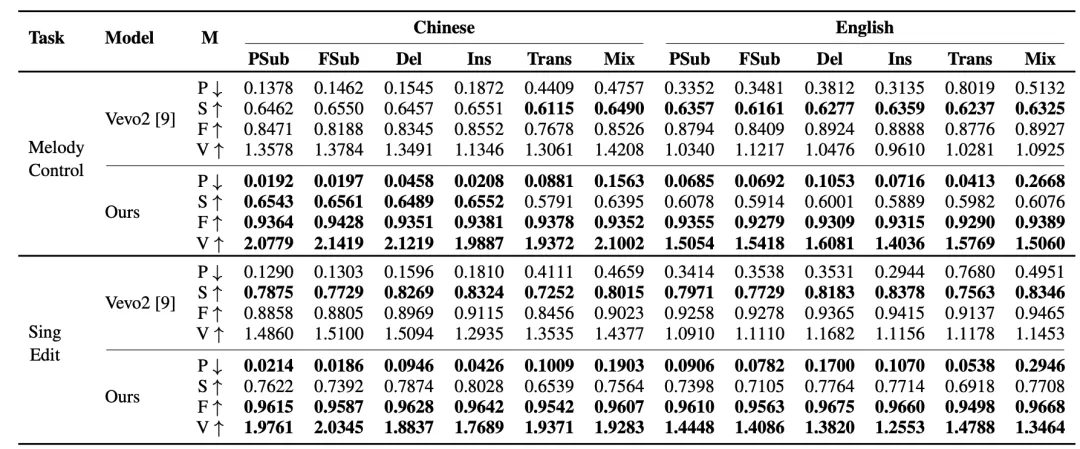
歌词忠实度方面,差距最为显著。以中文 Melody Control 设置下的 PSub 任务为例,YingMusic-Singer-Plus的 PER 为 0.0192,而 Vevo2 为 0.1378,减少了 86 个百分点。在 Trans 和 Mix 等极端任务上,Vevo2 的 PER 甚至高达 0.80 以上(英文翻译),而 YingMusic-Singer-Plus保持在 0.04–0.27 的范围内。
旋律保持方面,YingMusic-Singer-Plus的 F0-CORR 在各任务中稳定保持在 0.93–0.97 之间,而 Vevo2 在 0.77–0.95 之间波动较大,说明后者的旋律控制鲁棒性不足。
SIM 方面,Vevo2 得益于其多阶段架构(自回归 LLM 负责旋律和内容生成,专用 CFM 负责音色重建),在说话人相似度上略有优势。但 YingMusic-Singer-Plus采用单阶段 CFM 联合建模所有因素,以架构简洁性换取了部署便利性。
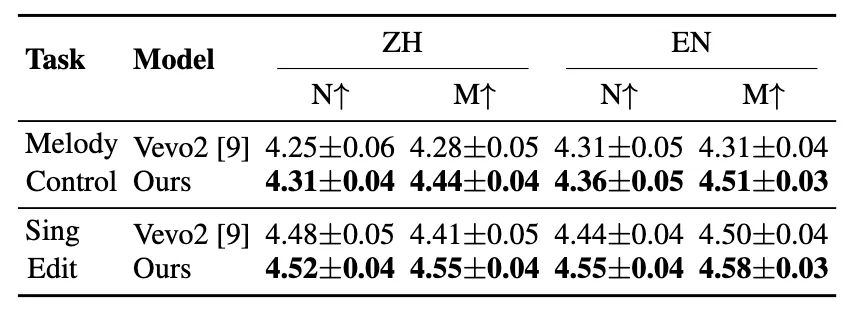
如表3,主观评价方面,YingMusic-Singer-Plus在 N-MOS 和 M-MOS 上全面领先 Vevo2,且方差更小、评分更稳定。听众反馈 Vevo2 存在明显的歌词幻觉和旋律偏差。
表3 LyricEditBench主观评估结果。N-MOS和M-MOS分别代表自然度与旋律贴合度。
消融实验
如表4,其清晰展示了课程学习各阶段的贡献:
表4 LyricEditBench消融研究。最佳结果以粗体标出,次佳结果以下划线标出。
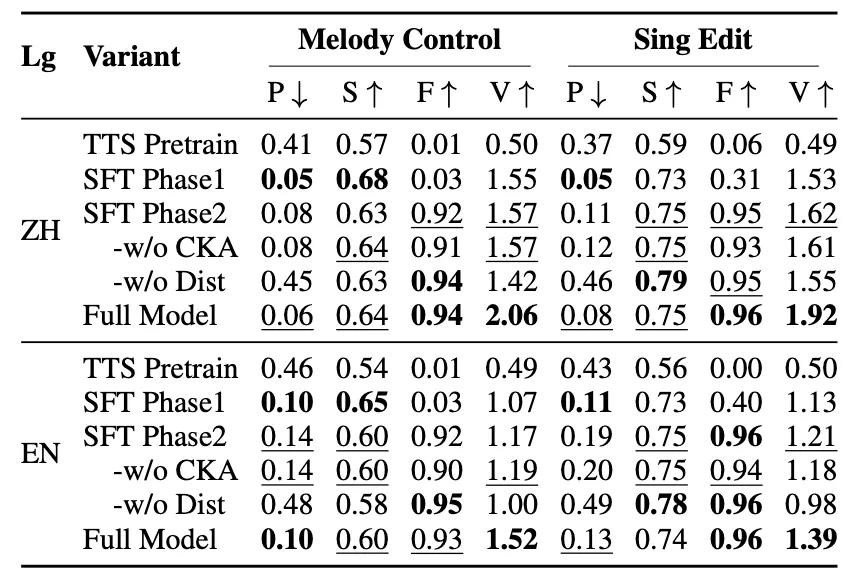
TTS预训练:建立发音先验,但缺乏歌唱能力(F0-CORR 接近 0)
SFT Phase 1:所有指标大幅提升,PER 达到最低,但显式旋律引导仍不可或缺
SFT Phase 2:F0-CORR 跃升至 0.92 以上,但 PER 回升,体现旋律-歌词权衡
GRPO:恢复 PER 并进一步提升 F0-CORR 和 VS,SIM 不变,确认奖励优化能同时增强多个维度
关于时间 Dropout 的消融(w/o Dist)尤其值得关注:去除对旋律潜在表示的时间 Dropout 后,PER 急剧恶化(中文从 0.08 飙升至 0.45),说明未经扰动的旋律潜在表示保留了残余语义信息,模型会利用这些信息"绕过"真正的歌词生成。时间 Dropout 消除了这一信息泄漏,迫使模型依赖抽象旋律轮廓。
总 结
YingMusic-Singer-Plus提出了一套简洁而高效的歌声编辑范式:
三输入、零对齐:仅需音色参考(可选)、旋律歌声片段和修改歌词,无需手动对齐。
课程训练 + GRPO:通过分阶段课程学习和基于强化学习的 GRPO 优化,同时实现高旋律一致性和高歌词忠实度,突破了二者之间的固有权衡。
LyricEditBench:首个面向旋律一致性的歌词改编基准,覆盖六种编辑类型、两种语言,为后续研究提供了标准化评测平台。
模型权重、推理代码和 LyricEditBench 均已开源,为歌曲改编、个性化翻唱、多语言歌曲适配等应用场景铺平了道路。
参考文献
[1] X. Zhang, J. Zhang, Y. Wang, C. Wang, Y. Chen, D. Jia, Z. Chen, and Z. Wu, “Vevo2: A unified and controllable framework for speech and singing voice generation,” CoRR, vol. abs/2508.16332, 2025.
[2] J. Qian, H. Meng, T. Zheng, P. Zhu, H. Lin, Y. Dai, H. Xie, W. Cao, R. Shang, J. Wu, H. Liu, H. Wen, J. Zhao, Z. Jiang, Y. Chen, S. Yin, M. Tao, J. Wei, L. Xie, and X. Wang, “Soulx-Singer: Towards high-quality zero-shot singing voice synthesis,” CoRR, vol. abs/2602.07803, 2026.
[3] Z. Evans, J. D. Parker, C. Carr, Z. Zukowski, J. Taylor, and J. Pons, “Long-form music generation with latent diffusion,” in ISMIR, 2024, pp. 429–437.
[4] Z. Ning, H. Chen, Y. Jiang, C. Hao, G. Ma, S. Wang, J. Yao, and L. Xie, “Diffrhythm: Blazingly fast and embarrassingly simple end-to-end full-length song generation with latent diffusion,” CoRR, vol. abs/2503.01183, 2025.
[5] Y. Chen, Z. Niu, Z. Ma, K. Deng, C. Wang, J. Zhao, K. Yu, and X. Chen, “F5-TTS: A fairytaler that fakes fluent and faithful speech with flow matching,” in ACL (1). Association for Computational Linguistics, 2025, pp. 6255–6271.
[6] D. Guo, D. Yang, H. Zhang, J. Song et al., “Deepseek-r1 incentivizes reasoning in llms through reinforcement learning,” Nat., vol. 645, no. 8081, pp. 633–638, 2025.
[7] J. Liu, G. Liu, J. Liang, Y. Li, J. Liu, X. Wang, P. Wan, D. Zhang, and W. Ouyang, “Flow-grpo: Training flow matching models via online RL,” CoRR, vol. abs/2505.05470, 2025.
[8] J. Li, Y. Cui, T. Huang, Y. Ma, C. Fan, M. Yang, and Z. Zhong, “Mixgrpo: Unlocking flow-based GRPO efficiency with mixed ODE-SDE,” CoRR, vol. abs/2507.21802, 2025.
[9] Y. Zhang, C. Pan, W. Guo, R. Li, Z. Zhu, J. Wang, W. Xu, J. Lu, Z. Hong, C. Wang, L. Zhang, J. He, Z. Jiang, Y. Chen, C. Yang, J. Zhou, X. Cheng, and Z. Zhao, “Gtsinger: A global multitechnique singing corpus with realistic music scores for all singing tasks,” in NeurIPS, 2024.
[10] X. Shi, X. Wang, Z. Guo, Y. Wang, P. Zhang, X. Zhang, Z. Guo, H. Hao, Y. Xi, B. Yang, J. Xu, J. Zhou, and J. Lin, “Qwen3-asr technical report,” CoRR, vol. abs/2601.21337, 2026.
[11] H. Wei, X. Cao, T. Dan, and Y. Chen, “RMVPE: A robust model for vocal pitch estimation in polyphonic music,” in INTERSPEECH. ISCA, 2023, pp. 5421–5425.
[12] Z. Wang, R. Yuan, Z. Geng, H. Li, X. Qu, X. Li, S. Chen, H. Fu, R. B. Dannenberg, and K. Zhang, “Singing timbre popularity assessment based on multimodal large foundation model,” in ACM Multimedia. ACM, 2025, pp. 12 227–12 236.
