
 语音小管家
⏩主要特性
超小模型尺寸:仅 0.1B 参数
原生音频格式:48 kHz、2 声道输出
多语言支持:支持 中文、英文等多种语言
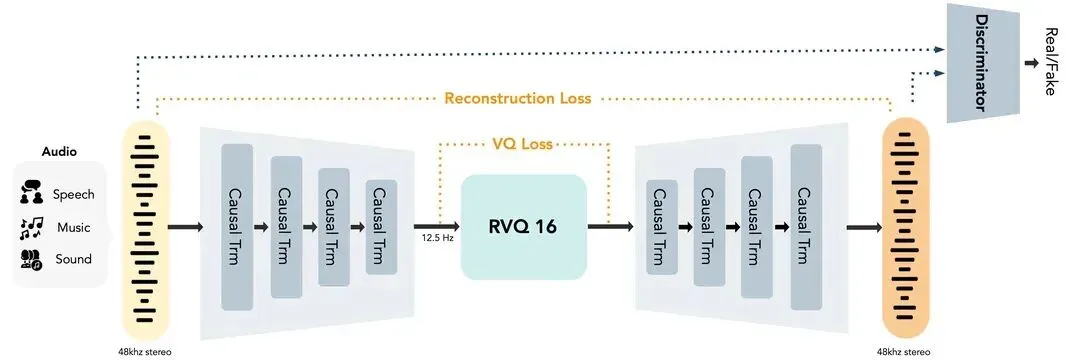
纯自回归架构:基于 Audio Tokenizer + LLM
流式推理:低实时延迟和快速首字节音频
CPU 友好:流式生成可在 4 核 CPU 上运行
长文本支持:支持长输入,具有自动分块语音克隆
开源部署:支持直接
python infer.py、python app.py和打包 CLIMOSS-TTS-Nano 目前支持 20 种语言
⏩快速上手
打开终端,创建一个干净环境:
conda create -n moss-tts-nano python=3.12
conda activate moss-tts-nano
2. 克隆仓库并安装:
git clone https://github.com/OpenMOSS/MOSS-TTS-Nano.git
cd MOSS-TTS-Nano
pip install -r requirements.txt
pip install -e . moss-tts-nano generate \
--prompt-speech assets/audio/zh_1.wav \
--text "欢迎关注模思智能,AI正在重塑我们说话的方式。" 生成的文件自动保存到 generated_audio/ 文件夹,拿来就能用!
想玩Web界面?直接 python app.py 或 moss-tts-nano serve,浏览器打开 localhost:18083 就行。
这个项目完美解决了当前开源TTS的三大痛点:
- 太大跑不动
→ Nano直接干到0.1B - 必须GPU
→ 纯CPU实时 - 部署太复杂
→ CLI + Web + Python 一条龙
⏩相关链接
