
 语音小管家
论文链接: https://arxiv.org/pdf/2508.06098v2
代码链接: https://github.com/xiquan-li/MeanAudio
发表会议: ACL 2026
近年来,文本转音频生成(TTA)技术取得了突飞猛进的发展,从环境音效到背景音乐,AI 已经能够根据文字描述生成几乎任何类型的声音,为游戏、影视、VR 等行业带来了革命性的创作工具。然而,一个长期困扰行业的痛点始终没有得到彻底解决:生成速度太慢。主流的扩散和流匹配模型通常需要几十到几百次迭代才能生成一段高质量音频,实时因子(RTF)普遍在 1 以上,这意味着生成 10 秒音频需要 10 秒以上的时间,完全无法满足实时交互场景的需求。
今天我们要介绍的这篇来自上海交通大学 X-LANCE 实验室的论文,彻底打破了这一速度瓶颈。他们提出的MeanAudio模型,首次将均值流(Mean Flows)技术应用于文本转音频生成,实现了仅需 1 次函数评估(1-NFE)就能生成高质量音频的惊人突破。在单张 NVIDIA RTX 3090 显卡上,MeanAudio 的实时因子低至0.013,比当前最好的开源扩散模型快了整整 100 倍。更令人难以置信的是,这一惊人的速度提升是在仅 120M 参数的轻量级模型上实现的,同时还保持了与大模型相当的生成质量。
一、基础概念
在深入解读论文之前,我们先明确几个关键概念:
文本转音频生成(TTA):根据输入的文字描述,自动生成对应的音频内容,包括环境声、音效、音乐等(不包含语音生成)。 实时因子(RTF):生成音频的时间与音频本身时长的比值。RTF<1 表示生成速度快于实时,数值越小速度越快。 函数评估次数(NFE):生成过程中需要调用模型的次数。扩散和流模型通常需要多次迭代,NFE 越大速度越慢。 流匹配(Flow Matching):一种生成模型框架,通过学习从噪声分布到数据分布的连续流场来生成样本,比扩散模型更稳定、更高效。 均值流(Mean Flows):流匹配的最新改进,通过直接回归流场的平均速度而非瞬时速度,实现了高质量的单步生成。
二、研究背景
文本转音频生成技术的发展大致经历了三个阶段:早期的基于规则和拼接的方法,中期的基于 GAN 的方法,以及当前主流的基于扩散和流匹配的方法。特别是 2023 年以来,随着 AudioLDM、Tango 等模型的出现,TTA 的生成质量得到了质的飞跃,Inception Score(IS)从 8.17 提升到了 12.81。
然而,这些模型都面临着一个共同的致命缺陷:推理速度极慢。以当时最好的开源模型 GenAU 为例,它需要 200 次采样步骤才能生成一段高质量音频,在 RTX 3090 上的 RTF 高达 1.612。这意味着生成一段 10 秒的音频需要 16 秒以上的时间,不仅严重影响了创作者的工作流,更完全无法应用于虚拟助手、实时游戏等对延迟敏感的场景。
为了解决速度问题,学术界主要采用了蒸馏的方法,即通过一个训练好的大模型(教师)来指导一个小模型(学生)学习在少数几步内生成音频。代表性的工作包括 AudioLCM 和 ConsistencyTTA,它们确实实现了单步生成,但也存在明显的局限性:
性能天花板低:学生模型的性能永远无法超过教师模型,甚至会有明显的质量下降。 计算成本高:在线蒸馏需要同时在内存中保留 2-3 个完整模型,离线蒸馏则需要先生成和存储大量教师模型的轨迹。 训练不稳定:一致性约束过于严格,容易导致训练崩溃或生成质量差。
正是在这样的背景下,MeanAudio 的作者们另辟蹊径,没有走传统的蒸馏路线,而是直接采用了最新的均值流技术,从根本上解决了流匹配模型的推理速度问题。
三、核心方法
MeanAudio 的核心思想非常简洁:与其学习流场的瞬时速度,不如直接学习流场的平均速度。这样一来,模型就可以一步从噪声跳到最终的音频样本,无需多次迭代。为了实现这一目标,作者们设计了一套完整的技术方案,包括增强的 Flux 风格流 Transformer、双文本编码器、集成无分类器引导以及瞬时到均值的训练课程。
3.1 均值流:从多步到单步的飞跃
传统的流匹配模型学习的是流场的瞬时速度
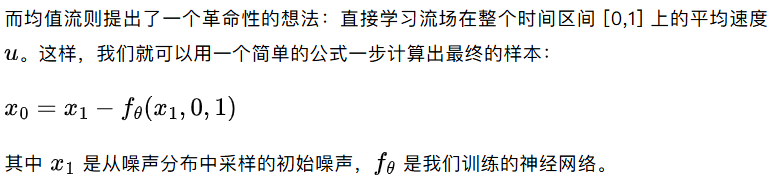
这一简单的改变带来了巨大的速度提升,但也带来了一个新的问题:直接训练均值流非常不稳定,收敛速度慢,而且多步生成性能差。为了解决这个问题,作者们提出了一系列巧妙的改进。
3.2 增强的 Flux 风格流 Transformer 架构
MeanAudio 采用了当前最先进的 Flux 风格流 Transformer 作为骨干网络,并针对音频生成的特点进行了多项增强:
混合块设计:结合了 4 个多模态 DiT 块(MMDiT)和 8 个单模态 DiT 块。多模态块用于融合文本和音频特征,单模态块用于进一步细化音频特征。 ConvMLP 替代普通 MLP:在音频流中使用 1D 卷积代替线性层,大大增强了模型对局部时间结构的建模能力。 旋转位置嵌入(RoPE):在注意力层的查询和键上使用 RoPE,能够更好地建模相对位置关系,支持可变长度的音频生成。 RMSNorm 和 SwiGLU 激活:采用了当前 Transformer 的最佳实践,提高了训练的稳定性和收敛速度。
3.3 双文本编码器:细粒度 + 全局语义对齐
为了提高生成音频与文本描述的语义一致性,MeanAudio 创新性地采用了双文本编码器架构:
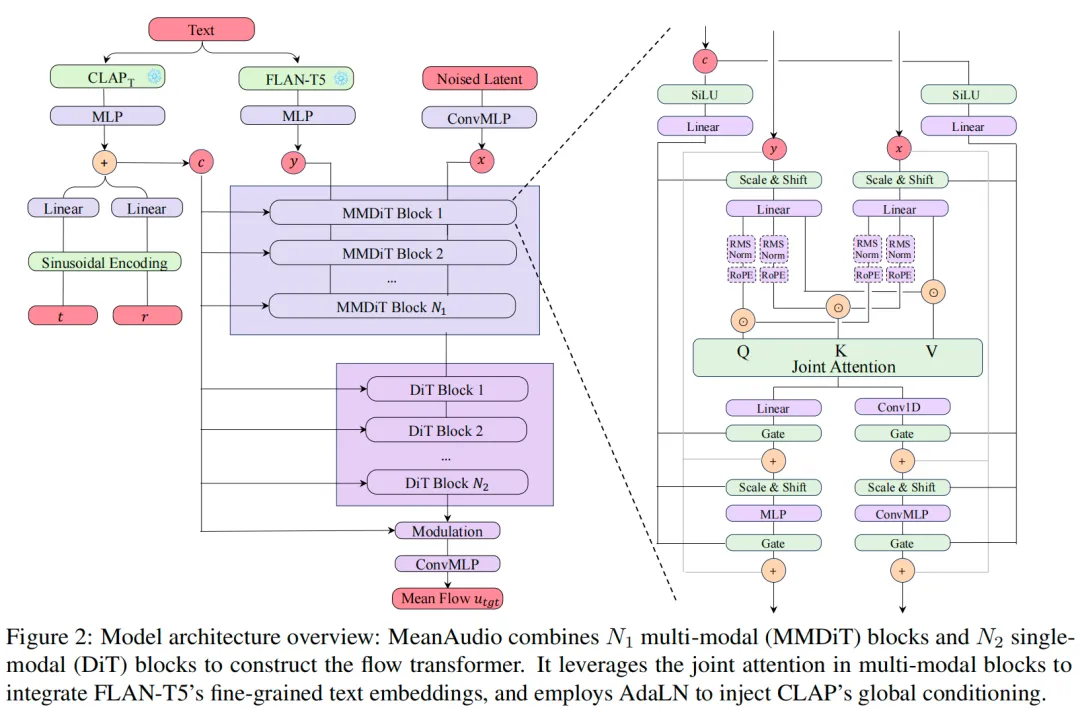
FLAN-T5:作为指令微调的大语言模型,能够生成细粒度的 token 级文本嵌入,捕捉文本中的细节信息。这些嵌入被输入到 MMDiT 块的文本分支,通过联合注意力与音频特征进行融合。 CLAP:作为专门在大规模音频 - 文本数据集上预训练的模型,能够生成与音频对齐的全局文本嵌入。这个全局嵌入与时间步特征结合后,通过自适应层归一化(AdaLN)注入到整个模型中。
实验证明,双编码器的设计比单独使用任何一个编码器都能带来显著的性能提升。在针对长文本描述的主观评价中,双编码器模型的相关性得分从 3.75 提升到了 4.10(满分 5 分)。
3.4 集成无分类器引导:零成本提升可控性
无分类器引导(CFG)是提高生成模型可控性的标准技术,但传统的 CFG 在采样时需要同时计算条件和无条件两个输出,这会使函数评估次数翻倍,严重影响速度。
MeanAudio 巧妙地将 CFG集成到了训练目标中。作者们重新定义了引导后的瞬时速度场,并将其作为均值流的训练目标。这样,模型在训练时就已经学会了引导后的平均速度,在采样时无需额外的前向传播,真正实现了零成本的 CFG。
3.5 瞬时到均值训练课程:解决训练不稳定问题
直接训练均值流会遇到严重的不稳定问题,这是因为均值流的目标是由模型自身的导数定义的,而随机初始化的模型无法提供有效的导数信息。
为了解决这个问题,作者们提出了瞬时到均值的两阶段训练课程:
瞬时流预训练:先用标准的流匹配目标训练模型学习瞬时速度场。这一阶段在大规模弱标注数据集上进行,为模型打下坚实的基础。 混合流微调:在高质量数据集上,用混合的瞬时流和均值流目标进行微调。通过随机设置 r=t,有 75% 的概率使用瞬时流目标,25% 的概率使用均值流目标。
这种课程式训练方法不仅解决了均值流训练不稳定的问题,还同时保留了模型的单步和多步生成能力。消融实验表明,没有这个训练课程,单步生成的 CLAP 得分会从 0.290 下降到 0.285,而多步生成的性能会下降得更明显。
四、实验与核心发现
作者们在 AudioCaps 和 MusicCaps 两个标准数据集上进行了全面的实验,与当前所有主流的 TTA 模型进行了对比。实验结果令人震撼,MeanAudio 在单步生成上取得了压倒性的 SOTA 性能,同时在多步生成上也能与大模型相媲美。
4.1 单步生成:速度与质量双 SOTA
在单步生成设置下,MeanAudio 的表现全面超越了所有现有的加速 TTA 模型:
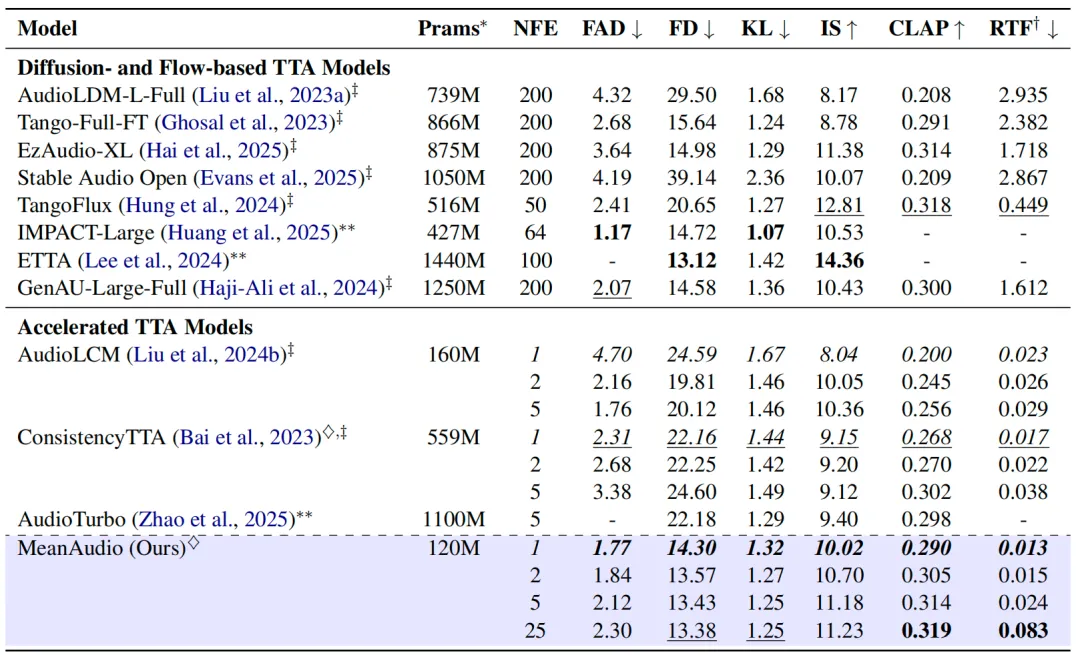
从表中可以看出:
速度最快:MeanAudio 的 RTF 仅为 0.013,比 GenAU(1.612)快了 100 倍,比之前最快的 ConsistencyTTA 还快了 30%。 质量最高:MeanAudio 的 FD(弗雷歇距离)低至 14.30,比 ConsistencyTTA 低了 35%,甚至超过了很多需要几百步的多步模型。 参数最小:MeanAudio 只有 120M 参数,是 ConsistencyTTA 的 1/5,AudioLCM 的 3/4。
更令人惊讶的是,MeanAudio 的单步生成性能已经超过了 Tango-Full-FT(200 步,FD=15.64)和 EzAudio-XL(200 步,FD=14.98)等主流扩散模型
4.2 多步生成:性能媲美大模型
MeanAudio 不仅单步生成能力强,多步生成性能也同样出色。随着采样步数的增加,MeanAudio 的生成质量会持续提升:
可以看到,仅需 25 步,MeanAudio 的 FD 就降到了 13.38,CLAP 得分达到了 0.319,这一性能已经与 TangoFlux(50 步,FD=20.65,CLAP=0.318)和 GenAU(200 步,FD=14.58,CLAP=0.300)相当甚至更好。
4.3 主观评价:人类专家打分第一
客观指标的优势也转化为了主观评价的领先。作者们邀请了 10 位音频专业人士对生成的音频进行了打分,评价维度包括整体质量(OVL)和文本相关性(REL):
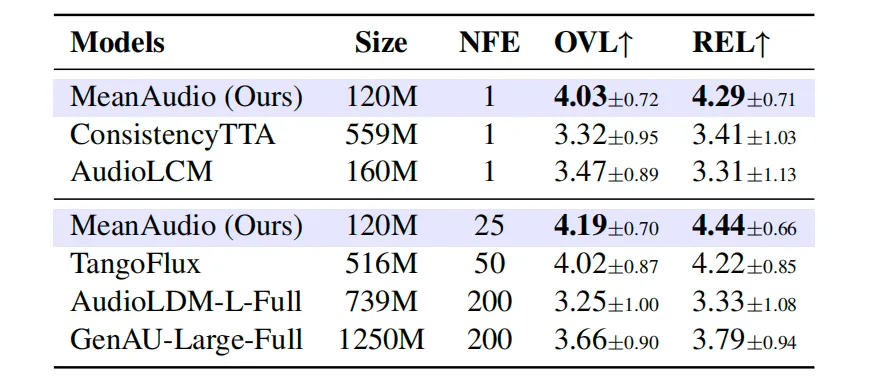
结果显示,MeanAudio 的单步生成在整体质量和文本相关性上都显著优于其他单步模型,甚至超过了需要 200 步的 GenAU。而 25 步的 MeanAudio 更是获得了所有模型中的最高分。
4.4 音乐生成:同样表现惊艳
除了普通的音效生成,MeanAudio 在音乐生成上也表现出了强大的能力。在 MusicCaps 数据集上,MeanAudio-S-Full(在完整数据集上训练的版本)的单步 FD 低至 11.82,25 步 FAD 低至 1.21,这一性能已经与 FluxMusic(2100M 参数,200 步,FAD=1.43)和 ETTA(1440M 参数,100 步,FAD=1.91)等大模型相当。
4.5 消融实验:揭秘最佳实践
作者们还进行了全面的消融实验,揭示了构建高性能均值流音频生成器的最佳实践:
训练课程至关重要:没有瞬时流预训练,单步生成的 FD 会从 14.30 上升到 16.13,CLAP 得分从 0.290 下降到 0.285。 流混合比例 75% 最优:当 r=t 的比例为 75% 时,模型在单步和多步生成上都取得了最好的平衡。如果比例为 0%,训练会完全失败。 双编码器缺一不可:移除 CLAP 编码器会导致 CLAP 得分从 0.285 下降到 0.270,文本相关性明显降低。 CFG scale=3 最优:当引导尺度为 3 时,生成质量和多样性达到了最佳平衡。进一步增大引导尺度会导致多样性下降。
五、结论与未来方向
5.1 核心结论
MeanAudio 的提出标志着文本转音频生成技术进入了实时生成时代。它的核心贡献可以总结为四点:
首次将均值流技术应用于文本转音频生成,实现了高质量的单步生成。 设计了增强的 Flux 风格流 Transformer 和双文本编码器架构,显著提升了生成质量和语义对齐。 提出了瞬时到均值的训练课程,解决了均值流训练不稳定的问题。 在单步和多步生成上都取得了 SOTA 性能,同时保持了极快的速度和极小的模型体积。
当然,MeanAudio 也存在一些局限性:
目前只能生成最多 10 秒的音频,无法生成长音频。 训练数据全部来自公共数据集,质量和规模都不如专有数据集。 只能生成音效和音乐,无法生成可理解的语音。
6.2 未来方向
扩展模型支持可变长度和长音频生成。 探索将均值流技术应用于语音生成。 进一步扩大模型和数据规模,提升生成质量。
七、总结
总的来说,MeanAudio 是文本转音频生成领域的一个里程碑式的工作。它不仅解决了长期困扰行业的速度问题,还为生成模型的加速提供了一条全新的思路。我们有理由相信,在不久的将来,实时、高质量的 AI 音频生成将成为现实,为我们的生活和工作带来更多的可能性。
