
 语音小管家
豆包的语音对话升级到了双全工模式。普通用户也许不知道“双全工”是什么,也不在意这个拗口名词的技术定义,但能直接感受到的变化可能是:
对话更流利 想打断时可以随时打断,系统还能自行判断是否应该被打断 豆包知道什么时候不该回应(比如噪声,或与对话无关的声音)
这篇文章我想从技术和产品设计两个角度,分享几点思考:
要做到端到端、实时双全工、可商用的语音对话模型,难点到底在哪里? 好模型不等于好产品。好模型是技术追求,好产品依赖用户洞察。 豆包做得这么好,如果只用火山引擎的 API,我们能不能也做一个? 把对话做得流利自然,到底有什么价值? 一个基于对话的智能体应该如何设计?(我觉得这是本篇文章最重要的部分)
端到端双全工语音对话的难点所在
拒识和意图
在当前技术能力下,对普通话表达比较清晰的用户而言,“拒识”和“意图”在双全工对话里可能是最影响体验的部分。
所谓拒识,是指对疑似干扰、明显不是在和 AI 对话的内容不做任何响应。比如我们和 AI 聊天时,旁边的人突然说了与对话无关的话,如果 AI 能判断这不是对它说的,就应该保持沉默。
意图的范围更广。传统做法会细分很多意图,比如闲聊、搜索、控制、音乐等。现在大模型对意图的判断已经更强,因此很多对话不一定需要细分。但细分意图的好处在于可以刻画用户画像。语音对话的意图还包括判断用户是否在说话、是否需要响应。从这个角度看,拒识也可以被视为一种意图。
在端到端双全工语音对话中,这些意图和拒识往往需要由同一个模型来解决。当然,是否必须用一个模型来做也未必。如果追求单模型能力,就需要在数据上投入更多工作。单模型的好处是能够更好地保持输入与输出音频流同步,判断更准确;系统复杂度更低,更依赖模型与数据。缺点是对训练数据的要求更高。
文本基础模型能力保持和更新频率
任何多模态模型都需要文本大模型的基础能力。这里有两个问题。
第一,文本大模型迭代很快。当文本模型升级后,如果它已经被转成多模态模型,那么对应的多模态版本往往需要重新做后训练对齐、强化学习等工作。
第二,所谓原生多模态模型的文本能力通常还是会弱一些。对中小公司来说,要持续保持这种能力并不容易。
实时推理成本高
类比文本大模型推理,可以发现文本输入往往可以使用 Prefilling 来提升效率。但实时语音交互无法预填充。1 秒语音离散化后大约会变成十几到二十几个 token,而这些 token 都需要实时推理。因此流式推理对工程优化和算力资源提出了很高要求。
对于半双全工模型来说,可以引入 VAD,检测到一段语音结束后再推理,从而退化为 Prefilling 过程。对十几秒语音而言,在 GPU 上推理通常很快,一般不会带来明显延迟。双全工则不同,它的推理时间颗粒度更细。
好模型不等于好产品
一个好的对话系统,不只是“模型足够好”这么简单。好模型是技术上的追求;好产品则是在模型之上叠加大量对用户与场景的理解。
以豆包为例,其中有不少产品设计。比如一些小 trick:当用户想听故事时,它可能会随机从库里取一段故事,直接播放或合成,从而降低延迟与成本。但一旦意图理解错了(比如用户要特定人物的故事),就会出现答非所问。
即使豆包使用端到端模型,在落地成可商用系统时也难以避免额外的语音识别流程,因为还涉及内容审核与过滤。如果完全依赖端到端模型,往往来不及拦截。做过真实业务的人对这一点都很熟悉。
在真实产品里,还有大量类似的策略与取舍,甚至会细化到“某类问题应该怎么答”。
用现在的 API 和开源模型怎么做好一个对话系统
不是每家公司都有能力搭建豆包这样的技术框架,即使资源很充足也是如此。不信可以试试其他家的对话系统。比如元宝的“打电话”,只要有声音几乎就会打断,哪怕只是“嗯”一声。这说明它很可能只是用了基于能量的 VAD 来做打断意图判定。
当然,我们也需要从商业角度思考:做一个这样的系统到底有什么用?这个问题会在下一节简单讨论。
那么,用 API 和开源模型能做一个更流畅的对话系统吗?可以,但比较难,需要很多技术和产品设计。
除了纯端到端方案,常见还有两种:一种是“语音识别大模型 + TTS”级联的三段式方案;另一种是“语音输入、文本回复,再接 TTS”的两段式方案。两段式方案类似一些 Omni 模型:接受全模态输入,但用文字输出。使用 API 的主要问题是延迟不可控,因为依赖网络环境和 API 调用耗时。实际系统设计里,也可以将两段式与三段式混合使用,并由意图来决定选择哪种路径。具体做法这里不再展开,有兴趣我可以单独介绍。
流利自然的对话到底有什么用
自然对话的核心价值,是让人愿意聊下去,这也是人机交互最基础的一步。能聊下去,才能有效提升用户时长。
这就像人与人的交流:如果对方反应迟缓、理解力弱,很难深入交流;如果对方反应迅速、思维敏捷,往往能聊很久。用户时长是很重要的指标:聊得越久,获取有效数据的机会越多;数据越多,就越能精准理解用户,从而提供更合适的后续内容。
对话智能体:边听、边说、边做
到这里才来到最重要的一步:如何构建一个边听、边说、边做的语音智能体?无论是车载智能座舱,还是如火如荼的机器人,它们本质上都是能够执行任务的载体。智能座舱相对成熟,而机器人因为需要物理动作来完成任务,难度更大。但无论如何,我们最终的目标都是在自然交流中,让机器完成我们希望它做的工作。
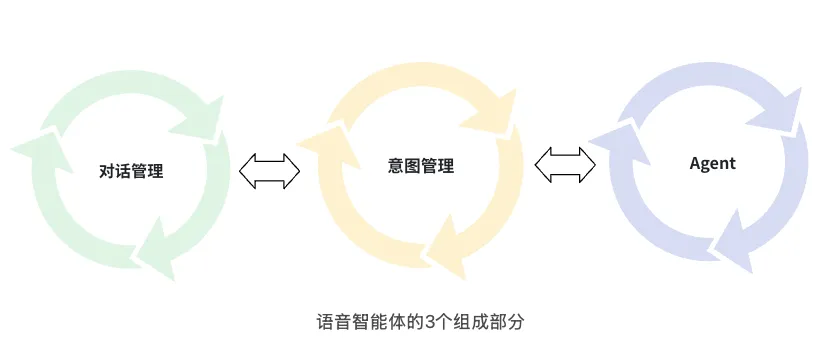
对话管理
对话管理模块只负责语音输入、回复生成与语音回复,无论采用端到端还是其他形式。在对话管理中,需要把重点放在:如何更好地收音、生成更自然的文本与语音回复,以及更合理的对话状态管理与体验,例如打断状态、倾听状态、禁止打断等。
至于是否要打断、某些场景下怎样回复更合适、是否需要联网搜索等决策,则交给意图管理。
如果认为端到端模型完全不需要意图管理,我认为在现有技术方案下仍然做不到。豆包的语音交互重点更多集中在对话管理上;而意图管理和 Agent 则具有很强的业务相关性,是每个产品都需要重点考虑的部分。
意图管理
我认为意图管理才是做好产品最重要的部分,因为它承接对话与 Agent 的执行。一旦意图理解不到位,无论对话还是执行都会产生很大偏差。
仍以豆包为例,最简单的意图就是是否需要联网搜索,以及是否需要讲故事。
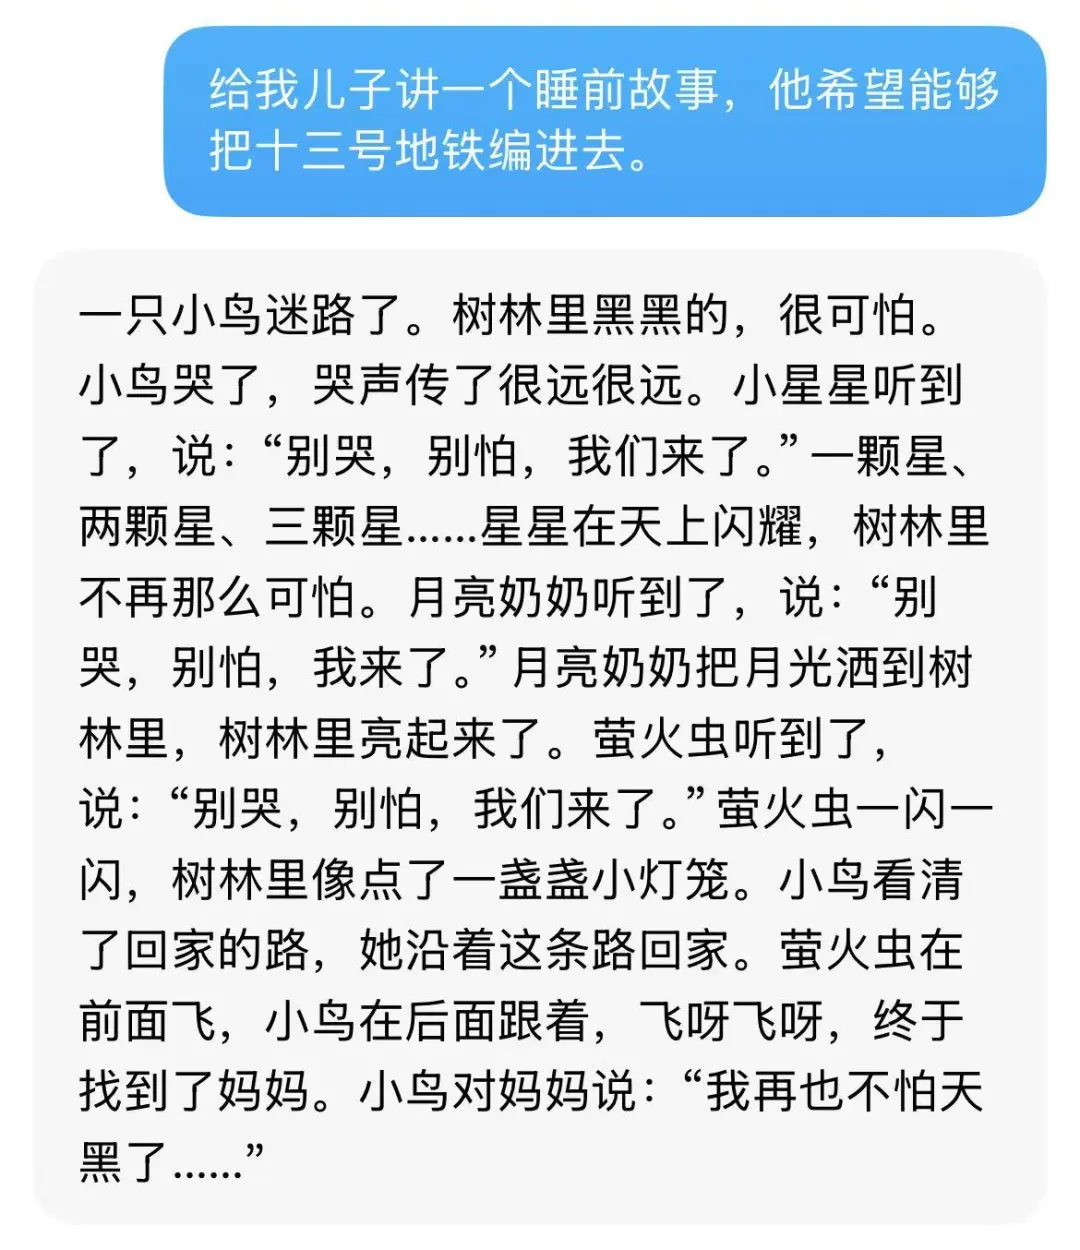
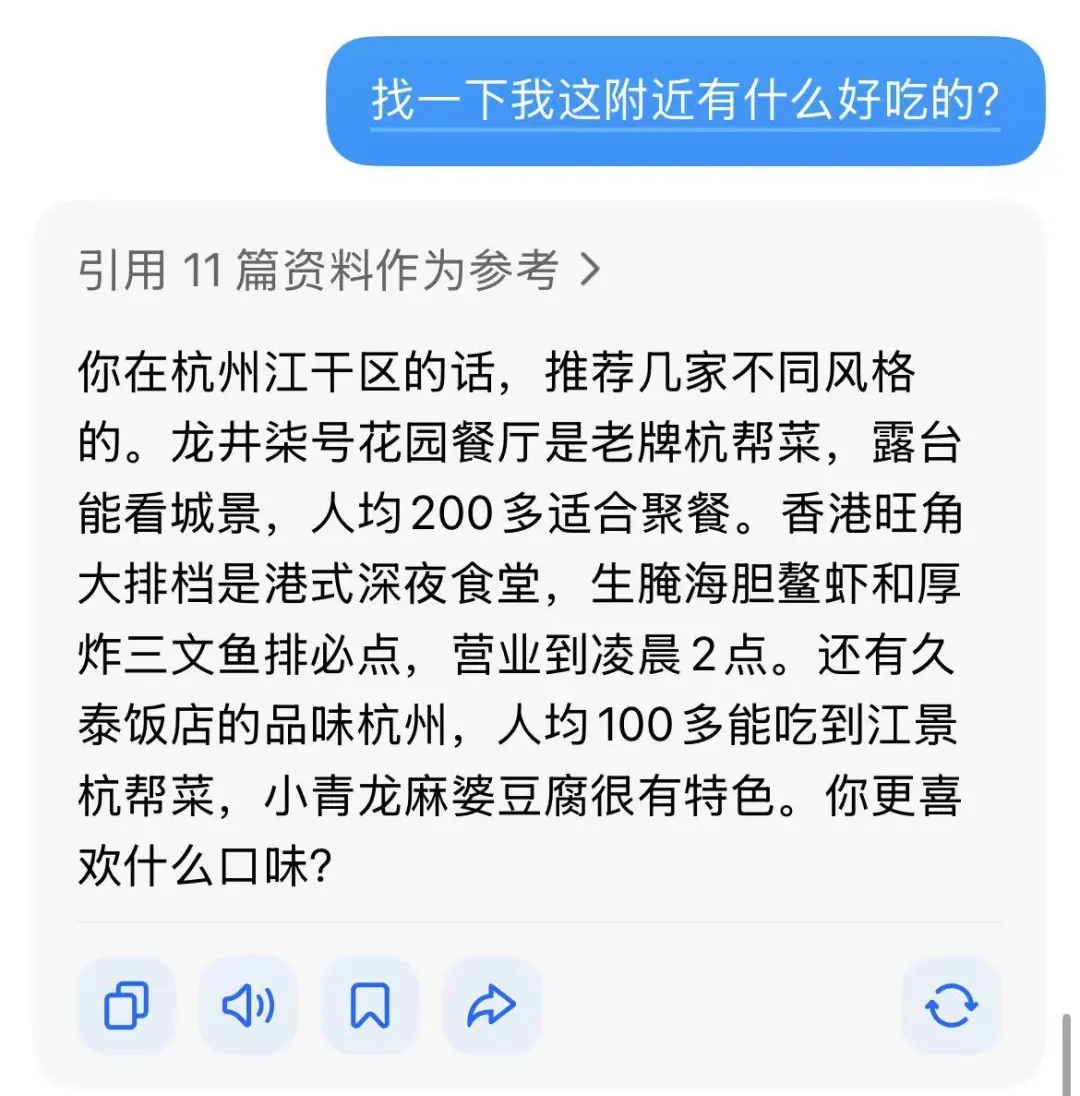
意图管理与业务逻辑高度相关。不同产品、不同业务需要的意图完全不同,都需要结合对产品与场景的理解做针对性设计。这不仅包含对话意图,也包含下游 Agent 的执行意图。
负责执行的 Agent
举一个最简单的例子:在车里和车载助手聊天时,可能出现这样的场景:
user: 我突然有个想法,周末去 xx 旅行吧,听说最近很美
assistant:太好了,需要我给你做一个计划吗?(意图识别)
user: 好啊,可以的。(意图确认)
assistant:那你等几分钟,我已经开始帮你规划了,完成后会发给你。(语音回复 + 异步后台执行)
Agent 在后台执行时,用户无需等待,可以自然地继续和助手对话,而不必立刻拿到结果,因为这类任务本身就很复杂。
不难看出,什么时候触发 Agent 执行至关重要;Agent 能做什么同样关键。和意图一样,Agent 的设计也与业务逻辑强绑定。
因此,在 Agent 部分需要结合业务与垂直场景,设计一些原子能力,或者说 Skill,来完成复杂操作,从而给用户更好的体验。这样的技术框架在现有技术条件下完全可以实现。
最 后
最后我想说,豆包在语音对话上虽然已经做得不错,但这也只是新的开始,就算没有豆包端到端双全工的技术,也能做出一个七八十分的对话产品。Voice Agent 的路还很长,仍有很多事值得去做。系统化设计而不是单点突破,才更能带来业务与产品体验的整体提升。路漫漫其修远兮,吾将上下而求索。
