
 语音小管家
近年来,以 Whisper 为代表的语音基础模型在高资源语言上取得了显著进展,但在小语种与方言等低资源场景中仍存在明显性能退化。这一现象表明,现有预训练能力尚不足以直接覆盖多样化的长尾语言需求。
在适配策略上,全参数微调(Full Fine-tuning)通常伴随较高计算与显存开销,并且在样本稀缺条件下容易产生过拟合和灾难性遗忘。参数高效微调方法(如 LoRA)虽显著降低了训练成本,但多采用跨层统一配置,未能利用模型内部表征的层级差异,因而在低资源条件下的适配效率仍有改进空间。
基于上述问题,ACL 2026 论文提出DAMA (Depth-Aware Model Adaptation),旨在通过“按层分配适配容量”的方式,实现低资源多语言 ASR 的高效、稳定迁移。
⏩关键发现:层间可塑性呈 U 型分布
作者首先通过 layer-wise linear probing 分析模型在不同深度的语言表征特性。结果表明,解码器并非“各层同质”,而是呈现显著的U 型层级可塑性分布:浅层与深层语言特异性更强,中间层则更偏向跨语言共享语义。
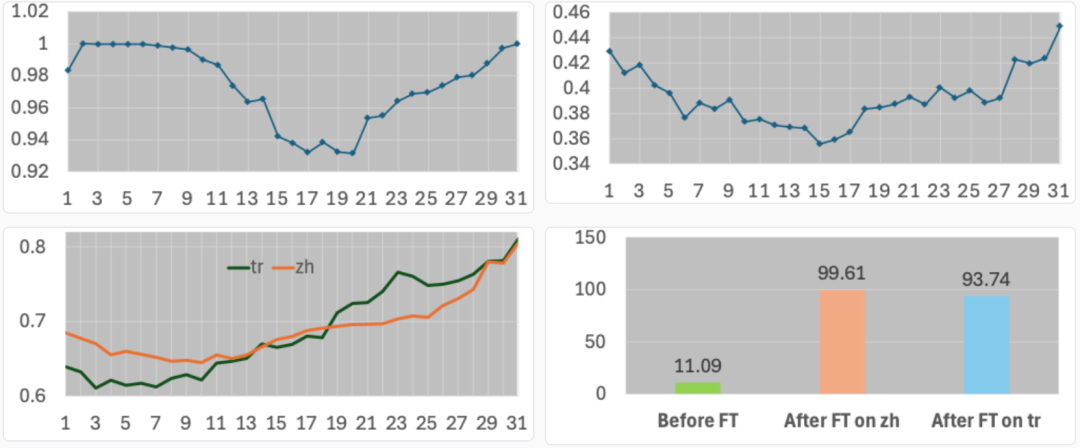
进一步实验显示,浅层与深层探针准确率接近 100%,说明其主要承载语言相关信息;中间层准确率显著下降,形成“语义谷(Semantic Valley)”,对应更稳定的语言无关语义空间。若采用全层无差别更新策略(如 Full Fine-tuning 或标准 LoRA),中间层共享语义结构容易被破坏,进而诱发跨语言泛化退化与灾难性遗忘。
⏩方法设计:DAMA 的三项核心机制
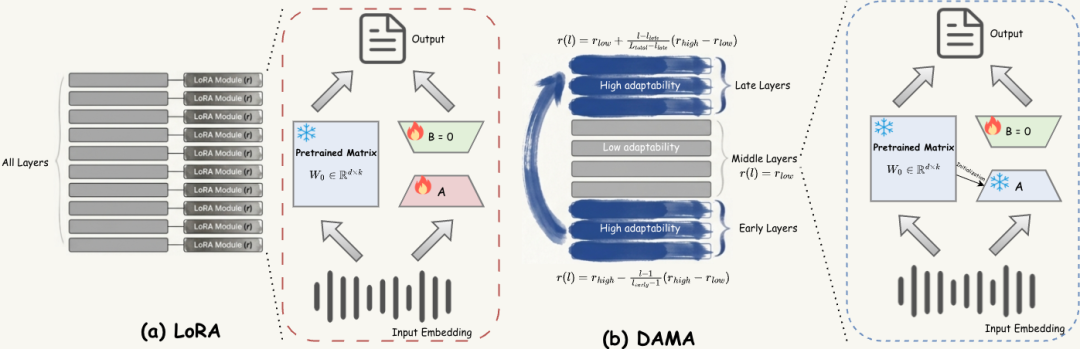
DAMA 的核心思想是使适配容量与层功能相匹配,即在高可塑层增强更新能力,在语义稳定层抑制扰动。框架由以下三个互补模块构成:
⚡1. 深度感知秩分配 (Depth-Aware Rank Schedule)
依据 U 型可塑性分布,在浅层与深层分配较高 rank,在中间层采用较低 rank,以同时兼顾目标语言适配能力与共享语义结构稳定性。
⚡2. 奇异值分解初始化 (SVD-based Initialization)
在中间层引入基于奇异值分解(SVD)的初始化策略,使更新方向尽可能避开主导语义子空间,从而降低语义漂移风险并提升训练稳定性。
⚡3. 基底保护投影 (Basis-Protected Projection, BPP)
在中间层冻结部分基底参数,仅更新受限子空间,以进一步减少可训练参数规模,并在极低资源条件下缓解过拟合与遗忘问题。
⏩实验结果:精度与效率的协同提升
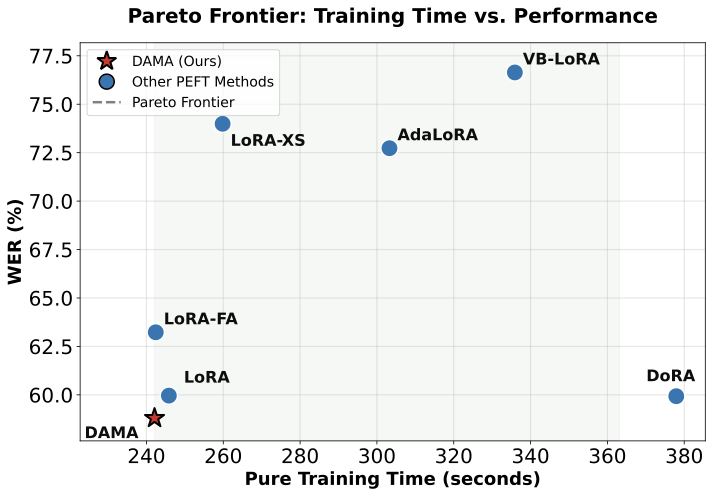
在 Common Voice 与 FLEURS 两个基准上的 18 种低资源语言实验中,DAMA 在维持竞争性识别性能的同时,体现出更优的参数与计算效率。
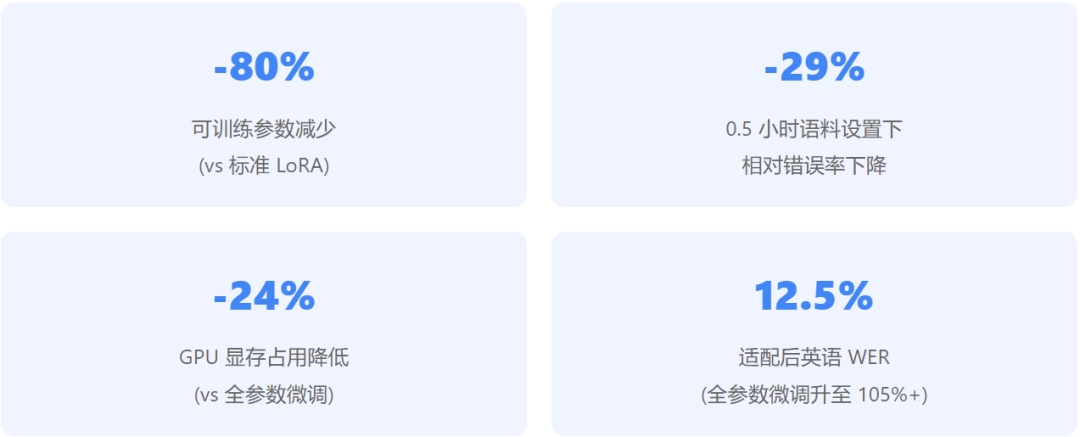
在训练时长与 WER 的 Pareto 分析中,DAMA 位于更优前沿区域,体现出更好的“性能—成本”平衡。这一结果说明,基于模型内部结构先验进行差异化适配,较统一式参数更新策略更适合低资源多语言场景。
⏩总 结
总体而言,DAMA 表明低资源多语言 ASR 的关键不在于无差别增加参数规模,而在于依据模型层级表征特性实施结构化适配。该工作为高效、可扩展的语音模型迁移提供了可验证的技术路径,也为后续跨语言与跨任务适配研究提供了方法参考。
👤 第一作者介绍
肖扬,墨尔本大学博士一年级研究生,主要研究方向包括语音大模型、多模态大模型及语音模型记忆机制。 其以第一作者身份在 ACL、ICASSP、Interspeech 等学术会议发表论文十余篇。
📚 论文信息
Title:Adapting Where It Matters: Depth-Aware Adaptation for Efficient Multilingual Speech Recognition in Low-Resource Languages
