
 语音小管家
语音修复(Speech Restoration)要解决的事很朴素:
把一段“坏掉的语音”修回“听起来像正常录音”的样子。坏的方式很多,比如:
降噪:背景嘶嘶声、风噪、环境噪
去混响:房间回声太大
去削波/爆音(declipping):录音过载导致破音
超分辨率:低码率/窄带语音补回细节
这两年生成式语音修复模型(GenSR:Generative Speech Restoration)确实很猛:即便输入烂得厉害,也能“补出”听感不错的音频。
但它们存在长期硬伤:
1)训练目标 ≠ 人耳偏好
很多生成式修复模型的训练目标更像“把概率分布拟合好/把距离最小化”,而人耳更在乎的是一个组合拳:
听起来自然不自然(有没有金属音、毛刺、机器人感)
干净不干净(噪声残留、奇怪伪影)
内容有没有被改(漏字、吞音、发音歪)
音色/说话人有没有跑(修完变了个人)
结果就是:模型可能在某个指标上很漂亮,但整体听感仍不对劲。
2)只用一个指标做“对齐”,很容易被模型“钻空子”(Reward Hacking)
在生成模型领域很常见:你让模型优化某个分数,它就学会走捷径,把分数刷上去,但其它维度变差。比如:
为了更像原说话人,强行保留音色 → 噪声也一起保留
为了更“干净”,过度抹除细节 → 语音变糊、内容损失
3)语音修复模型形态太多,难做统一后训练
生成式语音修复至少有三大路线:
AR(自回归):像语言模型一样按序生成
MGM(掩码生成/离散扩散):反复填空修复token
FM(Flow-Matching):在连续空间做“从噪声到干净语音”的流动生成
同一套“偏好对齐”方法要想真正落地,必须能跨这三类都有效。
论文:https://ojs.aaai.org/index.php/AAAI/article/view/40775/44736
Demo Page:https://gensr-pref.github.io
「解决方案」
团队给出的答案是:别指望一个指标代表人耳。要对齐,就用“多指标共同表决”的偏好信号,强行把 reward hacking 的路堵死。
团队提出:Multi-Metric Preference Alignment(多指标偏好对齐)
核心由两步组成:
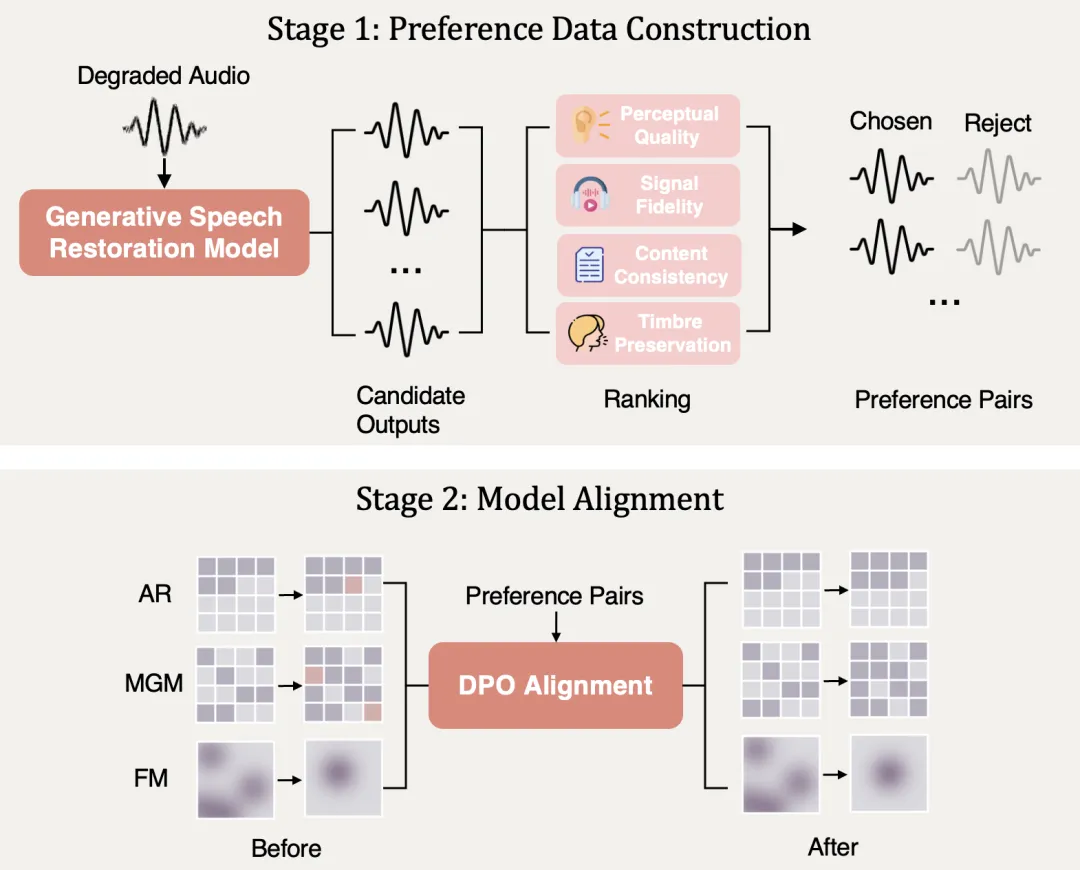
构建偏好数据集 GenSR-Pref
用DPO(Direct Preference Optimization)做后训练对齐
✅核心工作一:GenSR-Pref——80K“偏好对”数据集,赢家必须“四项全优”
很多偏好对齐失败,根因不是算法,而是偏好信号不可信。团队的关键设计是:赢家样本必须同时在四个互补维度都更好,否则不算赢家。
用于“投票”的四个维度(分别管不同听感要素):
感知音质(Perceptual Quality):NISQA
信号质量/失真噪声(Signal Fidelity):DNSMOS
内容一致性(Content Consistency):SpeechBERTScore
音色/说话人保持(Timbre Preservation):Speaker Similarity
只有当 A 在这四项指标上全部胜过 B,才组成一对偏好样本(A=Chosen,B=Reject)。这相当于“体检四项都合格才算更好”,把“只刷单项分”的捷径直接封死。
数据规模:约 80K 对偏好样本(preference pairs)。并且偏好对的构建主要在同一范式内部做排序(关键)
✅核心工作二:DPO 对齐——不训练奖励模型,直接用“更喜欢谁”微调生成器
每道题都是四选一:
偏好对齐在大模型里常见的是 RLHF,但对音频生成来说成本更高、链路更复杂。我们选了更轻量的路线:DPO(直接偏好优化)。
直观理解:
给定同一个“损坏语音”输入
模型产生多个候选修复结果
我们有一对“赢家/输家”(来自GenSR-Pref)
DPO 训练的目标就是:提高赢家的概率、降低输家的概率
另外这套 DPO 还被我们分别适配到了AR / MGM / FM三类生成机制里,做到了“同一思想跨范式落地”。
✅核心工作三:为什么这套方案能稳?我们做了三组“打脸式”消融
我们专门把容易踩坑的地方都验证了一遍:
1)多指标 vs 单指标:多指标明显更稳
单指标对齐确实能把对应分数抬高,但其它指标经常掉(典型 reward hacking)。多指标“一票通过”则能让各项指标一起涨,整体听感更一致。
2)DPO vs 纯监督微调(SFT):DPO 更有效
只拿“好样本”做监督微调(SFT),往往涨一点就停滞;DPO 这种“成对拉开差距”的训练更有力。
更关键的是:我们还发现一种“看起来很合理但会崩”的做法——把 ground-truth(真实干净语音)永远当赢家去做 DPO,会导致模型训练“坍塌”(model collapse)。原因是模型会走极端:为了永远赢,它学会把非GT输出的概率都压得极低,反而不正常。
3)in-paradigm alignment:同范式数据对齐最好
我们提出一个经验法则:AR 用 AR 产生的偏好对来对齐最好,MGM/ FM 同理。
原因很简单:不同生成范式的“错误模式”不一样,改进方向也不一样。用自己的范式数据,更像“顺着自己最擅长的方向纠偏”。
「关键结果:三种生成范式都吃到了收益,而且3K对偏好样本就够用」
我们在多套语音修复基准上测试(包含多任务综合修复GSR、以及下游语音增强DNS基准)。
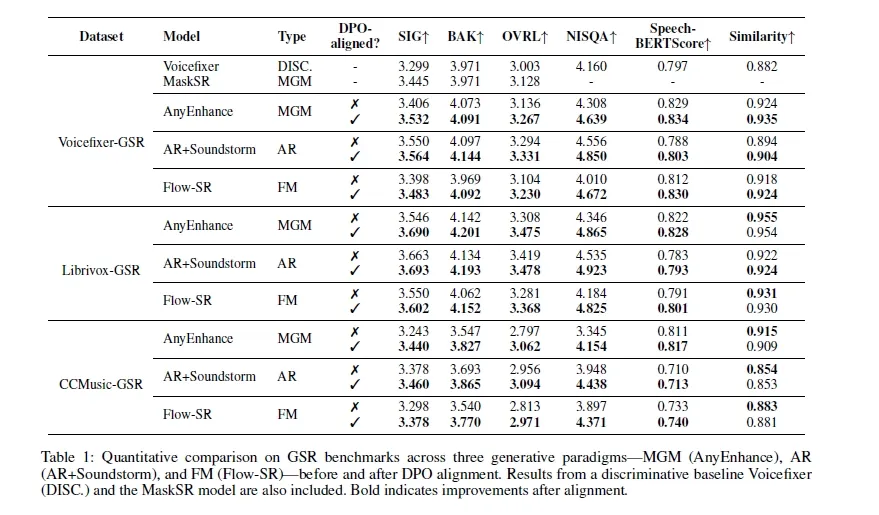
结论很统一:
MGM(AnyEnhance)用大规模偏好对齐(69K对)提升显著,例:在 Librivox-GSR 上 NISQA明显上涨
AR(AR+Soundstorm)和FM(Flow-SR)即便只用约 3K 对偏好数据,也能稳定提升多项指标
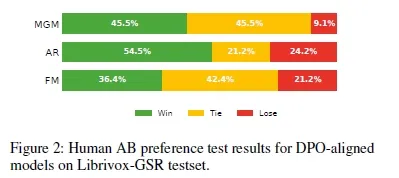
主观听感 A/B 测试里,人类更偏好对齐后的模型,最高Win rate可到54.5%
一句话总结:不是“换个指标算分”,而是真把生成修复往“人耳更喜欢的方向”推了。
「应用验证:对齐后的生成模型还能当“数据标注员”反哺传统模型」
很多场景(比如歌声修复)缺少成对的“坏音频-干净真值”数据,传统判别式模型(discriminative)就很难训练。
我们做了一个桥接思路:
用对齐后的生成式模型(DPO增强的 AnyEnhance)去生成高质量 pseudo-label(伪标签)
再用这些伪标签去监督训练传统修复模型(Voicefixer)
结果:在真实歌声录音上,Voicefixer 的多项指标都有明显提升。
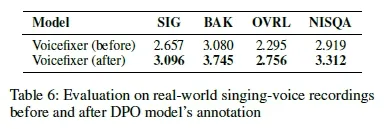
这说明:对齐后的生成器不仅自己更好用,还能“造数据”帮助数据稀缺任务。
「总结」
团队把“偏好对齐”第一次系统性地落在了生成式语音修复上,解决的核心不是某个新模型结构,而是三个关键工程难题:
偏好信号怎么定义才靠谱?→ 用“多指标互补 + 全票通过”的严格规则
怎么避免 reward hacking?→ 从数据构建阶段就把“刷单项分”的路堵死
能不能跨 AR/MGM/FM 都有效?→ DPO 适配三范式,并验证 in-paradigm alignment 原则
